

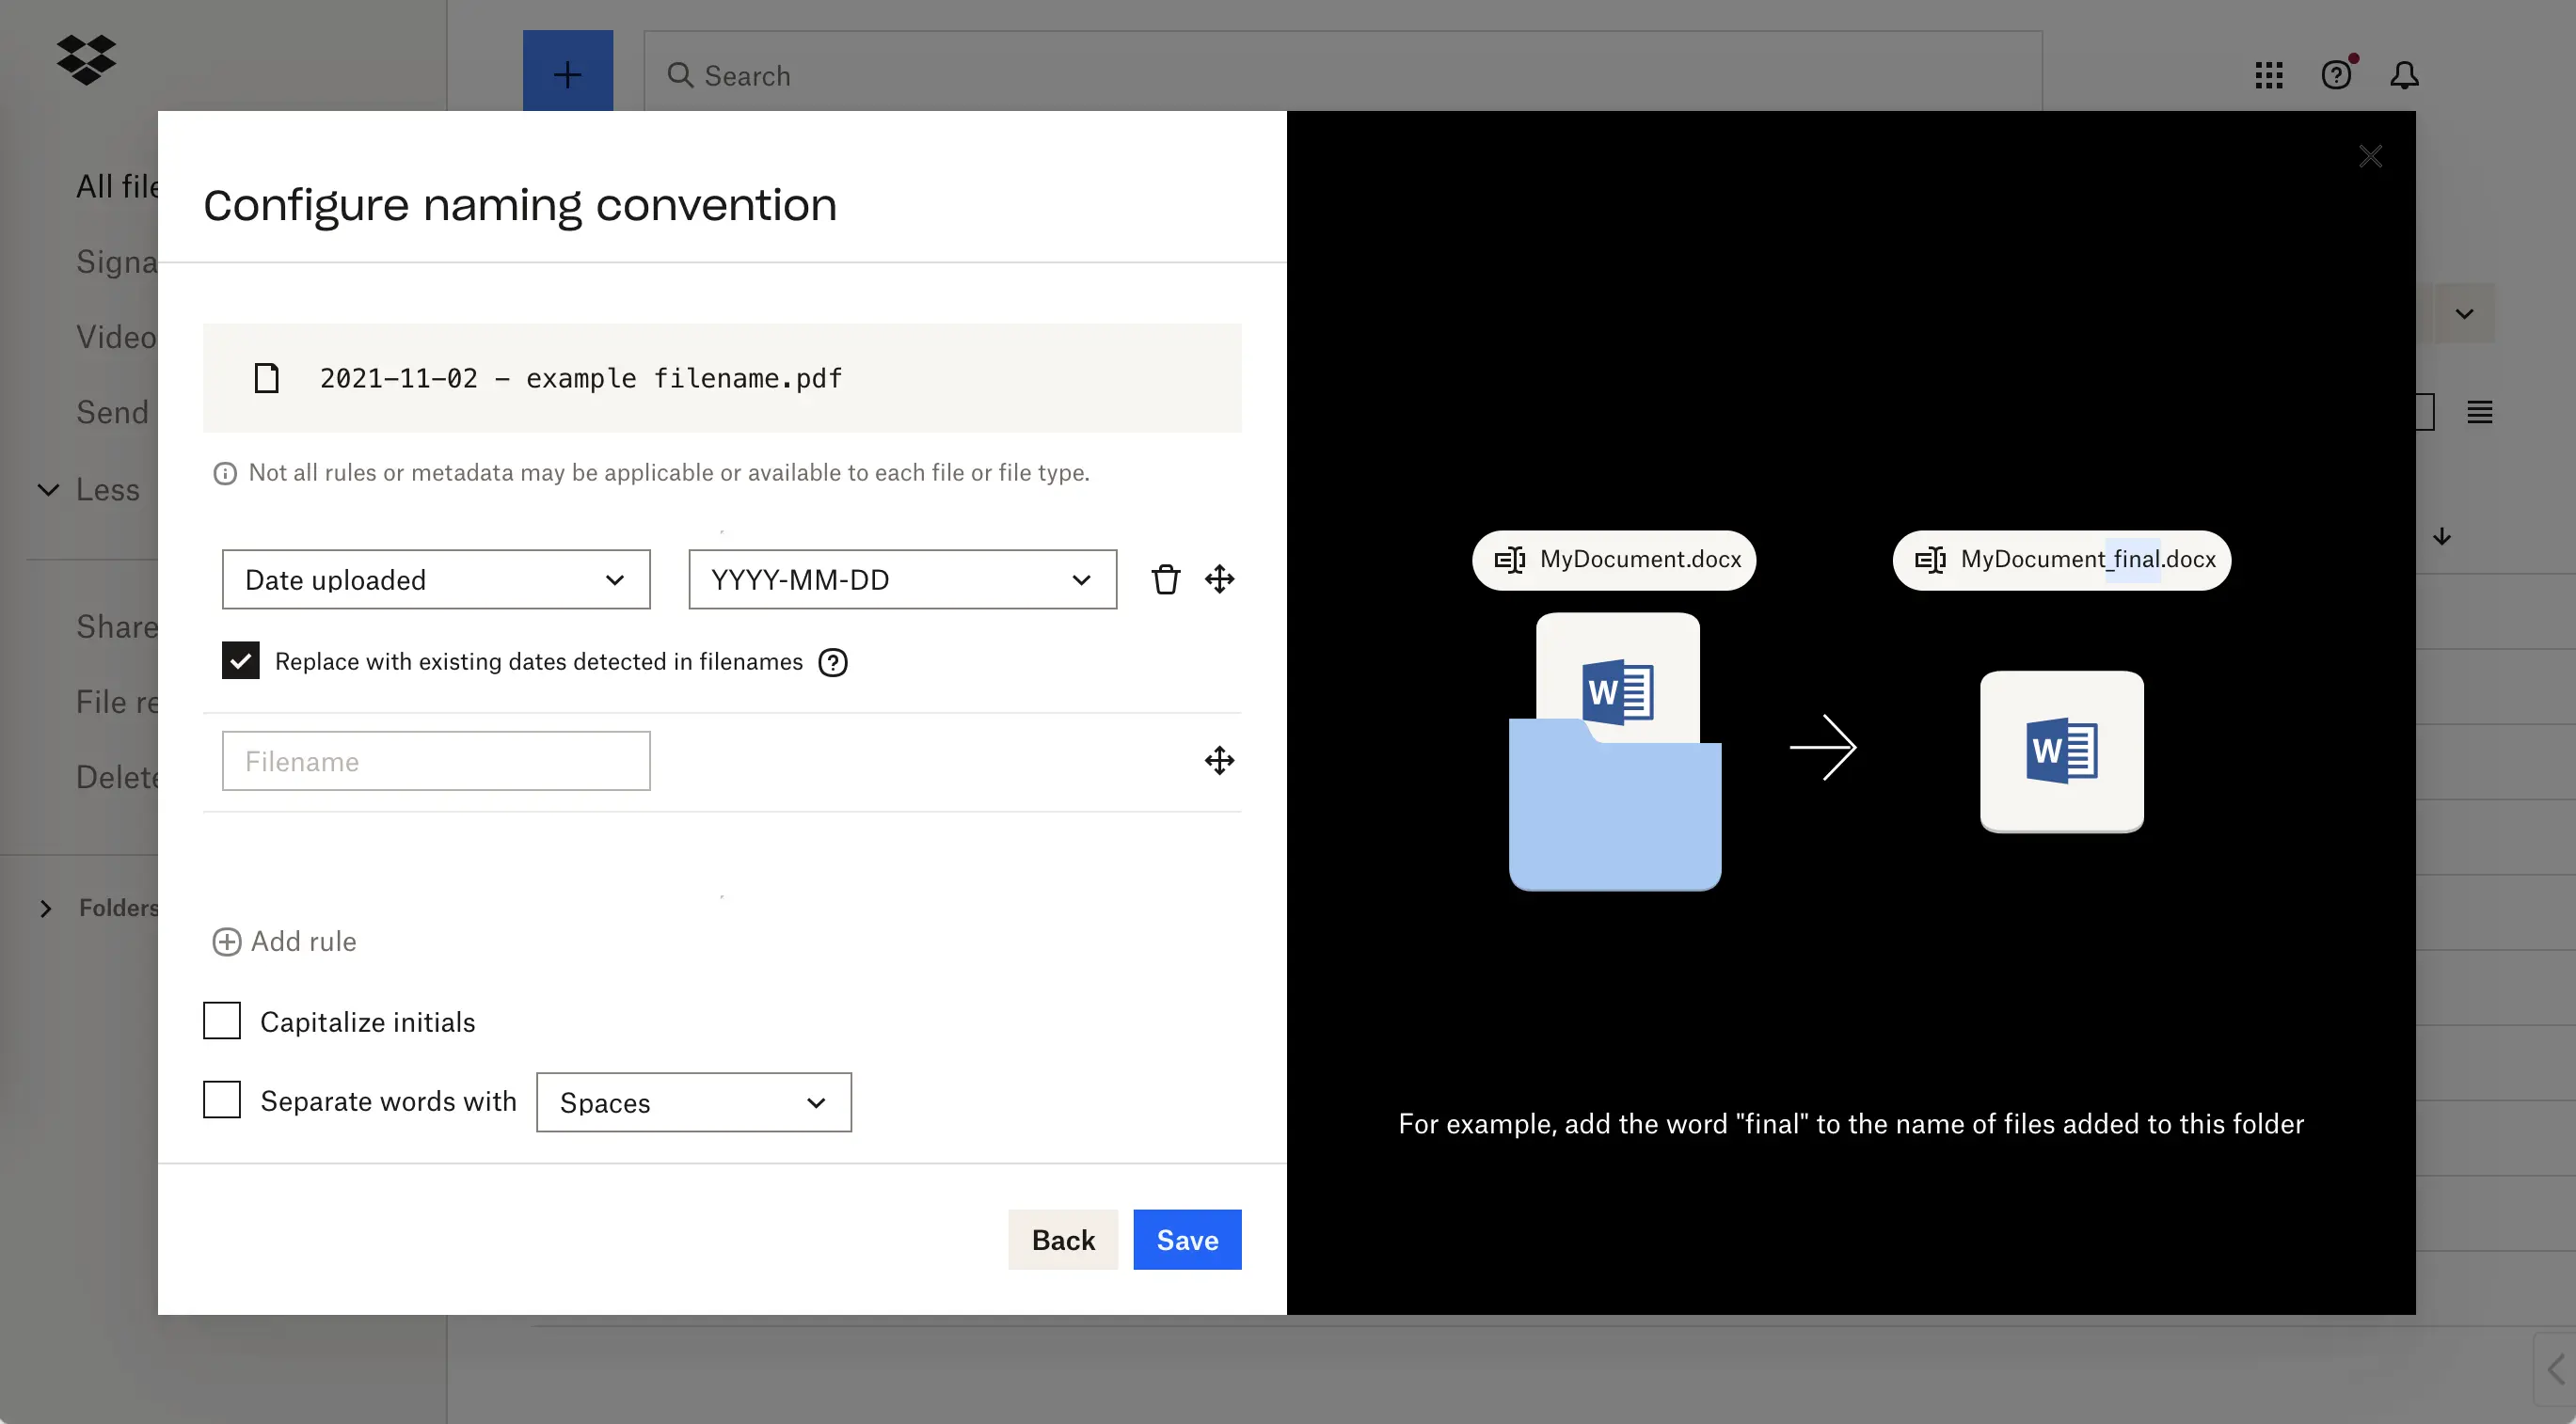
这是一种日期吗?利用机器学习识别文件名中的日期格式
内容提要
Dropbox推出了自动命名规范功能,利用机器学习模型识别文件名中的日期,提高文件重命名效率。该模型通过标注和合成数据训练,优化了识别精度并减少延迟,未来计划扩展到识别更多实体。
延伸解读
从规则到机器学习:识别日期的挑战
文章指出,基于规则的方法难以自动识别文件名中多样且不一致的日期格式,尤其是在Dropbox的规模下。因此,Dropbox转向机器学习模型,通过监督学习和多类分类来识别日期组件。这种转变不仅提高了识别精度,还减少了延迟,使文件重命名更高效。
模型设计与优化:平衡精度与速度
Dropbox采用DistilRoberta作为基础模型,通过模型剪枝和量化优化推理速度。剪枝移除了最后两层编码器,在保持性能的同时将延迟降低30%以上。这些优化确保了用户体验,使模型能够快速处理文件重命名任务。
数据策略:标注与合成数据的结合
为了训练模型,Dropbox从员工文件中采样并手动标注,同时构建工具生成合成数据以覆盖更多日期格式。这种结合减少了过拟合风险,并利用迁移学习在较小标注数据集上实现良好性能,平衡了标注成本与模型效果。
实际效果与未来方向
自2022年8月发布以来,机器学习模型使重命名文件数量比基于规则的基线增加了40%,并在几周内应用于超过100万个文件。未来,Dropbox计划扩展模型以识别更多实体类型,如名称和地点,进一步提升重命名体验。
Q&A
Dropbox的自动命名规范功能是如何工作的?
该功能利用机器学习模型识别文件名中的日期,并根据用户设定的规则自动重命名文件。
Dropbox是如何训练其机器学习模型以识别日期的?
模型通过标注和合成数据训练,使用了手动标注的文件名和合成的样本,以提高识别精度。
使用机器学习模型识别日期有什么优势?
机器学习模型能够处理多种日期格式,减少了手动配置的复杂性,提高了文件重命名的效率。
Dropbox未来对自动命名规范功能有什么计划?
未来计划扩展模型以识别更多类型的实体,提升用户的重命名体验。
Dropbox如何解决用户对手动配置命名规则的抵触?
Dropbox开始自动建议命名规范,基于文件夹中现有文件的命名规则,简化用户操作。
在识别日期时,机器学习模型面临哪些挑战?
模型需要处理不一致或模糊的命名规则,且识别不同日期格式的能力有限。
