
太阳能与风能SCADA数据的连续聚合刷新策略:选择合适的策略形态
内容提要
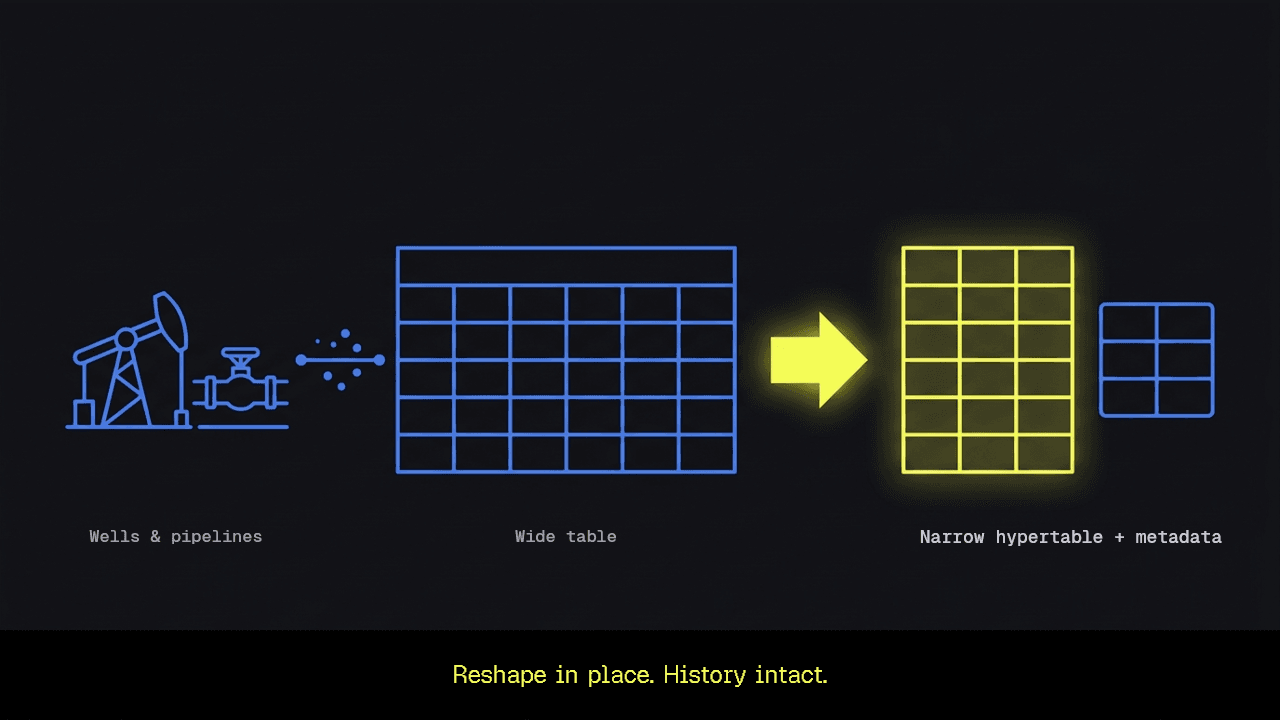
文章介绍将油田SCADA宽表就地转换为窄表加标签元数据,无需重新导入历史数据,仪表板可照常运行;同时涉及IIoT表部署前的容量测算,以及TimescaleDB连续聚合的刷新机制,包括失效跟踪、回看窗口与迟到数据处理。
延伸解读
宽表转窄表:无需重导历史数据
文章介绍将油田SCADA宽表就地转换为窄表加标签元数据,无需重新导入历史数据,仪表板可照常运行。这意味着在现有系统上可直接进行结构优化,避免数据迁移带来的停机与风险,适合需要保留历史数据并保持业务连续性的场景。
IIoT表部署前的容量测算
文章提到IIoT表部署前需进行容量测算,例如20字节的传感器读数在磁盘上占95.6字节,并需预测6310亿行数据量,测试摄入上限。这提醒读者在schema评审前应量化存储与吞吐需求,避免后期扩展困难。
连续聚合刷新机制:失效跟踪与回看窗口
文章解释TimescaleDB连续聚合的刷新机制,包括失效跟踪、回看窗口与迟到数据处理,并提到两个偏移量可防止聚合桶过期。这有助于读者理解如何配置连续聚合以正确处理迟到数据,确保聚合结果的时效性与准确性。
Q&A
如何在不重新导入历史数据的情况下,将油田SCADA宽表转换为窄表?
文章介绍了一种就地转换方法:将宽表转换为窄表(hypertable)并添加标签元数据,无需重新导入历史数据,仪表板可照常运行。
IIoT表部署前如何进行容量测算?
文章提到需要测量每行字节数,例如一个20字节的传感器读数在磁盘上占用95.6字节,然后根据预计行数(如6310亿行)进行容量规划,并在模式评审前测试摄取上限。
TimescaleDB连续聚合的刷新机制包括哪些关键部分?
连续聚合刷新机制包括失效跟踪、回看窗口以及处理迟到数据的两个偏移量,这些机制共同防止聚合桶数据过时。
连续聚合中如何处理迟到数据?
通过失效跟踪和回看窗口,并利用两个偏移量来确保迟到数据被正确纳入聚合,避免聚合桶数据过时。
什么是连续聚合的失效跟踪?
失效跟踪是TimescaleDB连续聚合刷新机制的一部分,用于跟踪哪些聚合桶需要刷新,以应对迟到数据或数据变更。
回看窗口在连续聚合刷新中起什么作用?
回看窗口用于确定在刷新连续聚合时需要重新计算的时间范围,以捕获迟到数据,确保聚合结果的准确性。
