


如何构建开放域问答系统?
内容提要
开放域问答(ODQA)要求模型仅凭问题从外部知识中找答案,主要方法有三类:检索器-阅读器先检索相关段落再抽取答案;检索器-生成器直接生成答案;闭卷生成式依靠参数记忆作答。检索可用TF-IDF或稠密向量,训练可端到端联合优化。
延伸解读
开放域问答的三种技术路线
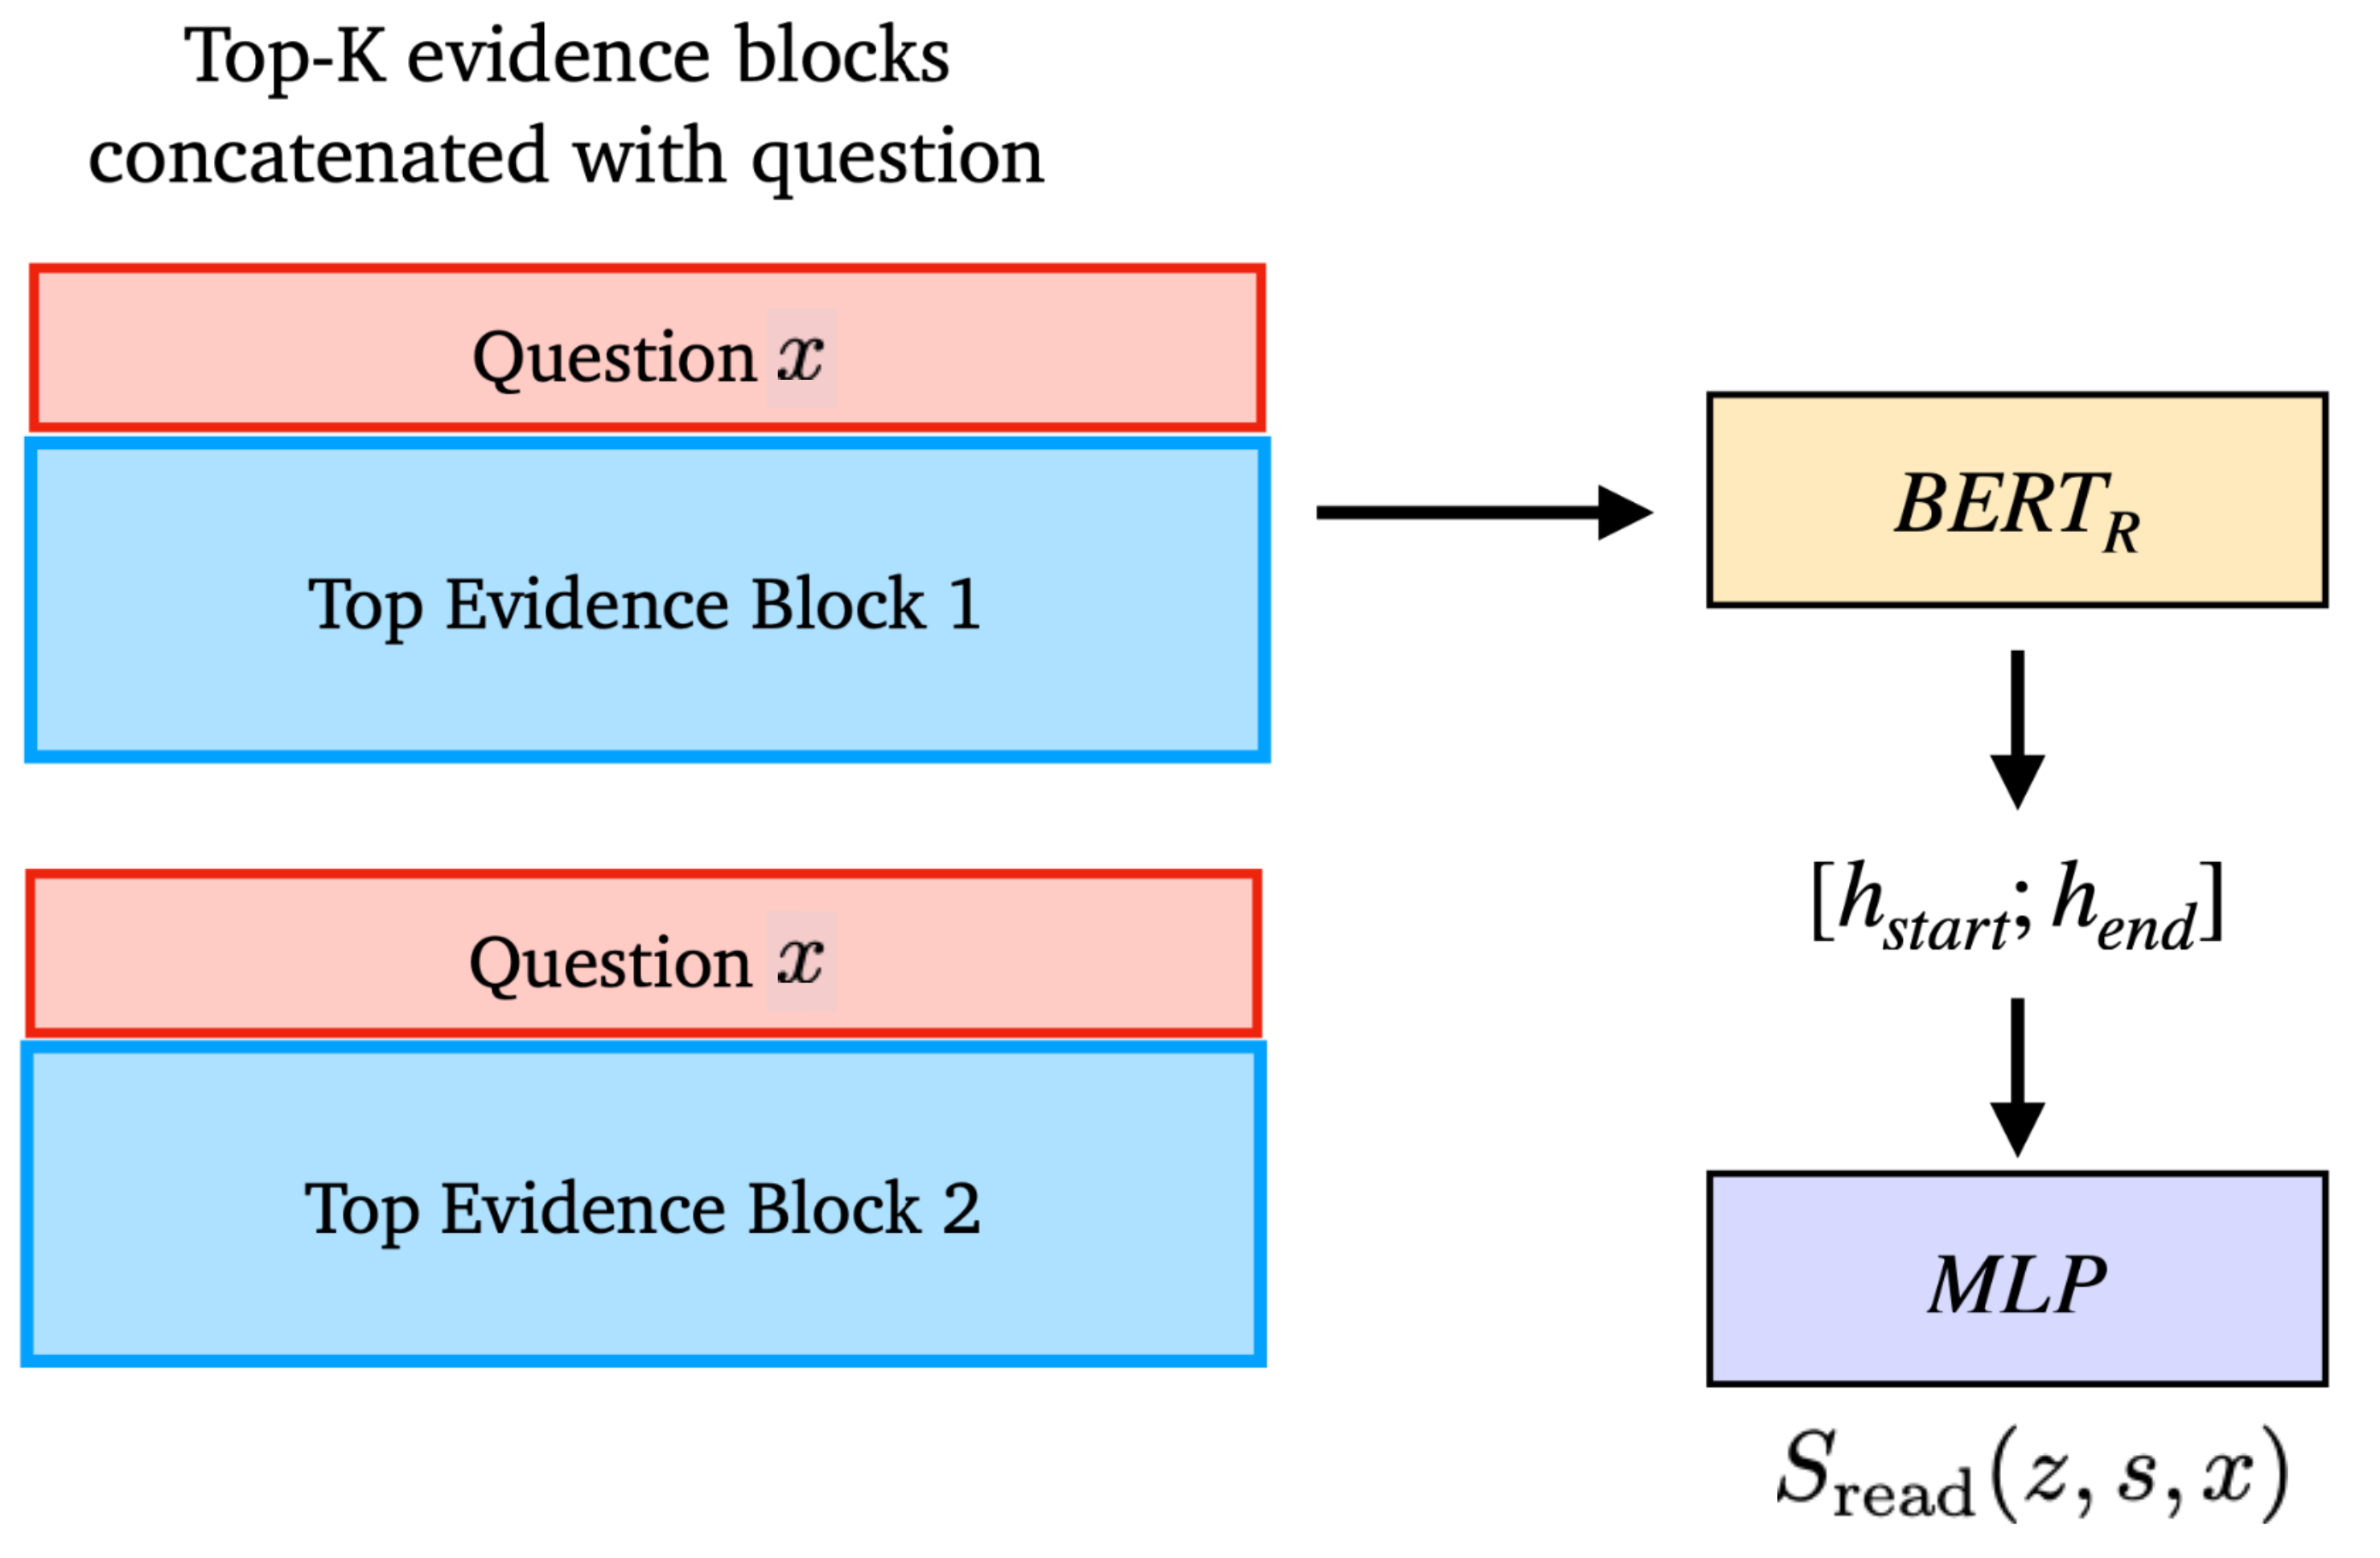
文章将开放域问答系统归纳为三类框架:检索器-阅读器、检索器-生成器和闭卷生成式。检索器-阅读器先检索相关段落再抽取答案,检索器-生成器直接生成答案,闭卷生成式则完全依赖模型参数中的记忆。这三类方法在知识来源、答案形式和计算成本上各有取舍,读者可根据应用场景选择。
检索器实现:经典IR与神经IR
检索器负责从外部知识库中找出可能包含答案的段落。文章介绍了两种主流实现:经典IR使用TF-IDF等非学习特征,如DrQA采用基于向量空间模型的搜索引擎;神经IR则用神经网络生成稠密向量,通过点积计算相关性,如ORQA、REALM和DPR。神经IR不一定优于经典IR,但能更好地捕捉语义相似性。
端到端联合训练的关键挑战
检索器与阅读器可以联合训练以优化整体性能,但面临检索不可微的挑战。R^3使用强化学习,将阅读器的反馈作为奖励训练检索器;ORQA和REALM则通过优化答案的边际似然来联合训练,并采用ICT预训练或显著跨度掩码提升检索质量。这些方法都需要处理大规模检索和训练稳定性问题。
闭卷问答的潜力与局限
闭卷生成式模型如T5和GPT-3,无需外部知识,仅凭参数记忆回答问题。T5通过显著跨度掩码继续预训练,在多个数据集上达到竞争性效果;GPT-3在少样本设置下甚至能匹配微调基线。但这类模型难以更新知识、可能产生幻觉,且性能随模型规模增长,部署成本较高。
Q&A
开放域问答(ODQA)和阅读理解(RC)任务的主要区别是什么?
开放域问答只给模型提供问题,不提供相关上下文,需要模型从外部知识中寻找答案;而阅读理解任务同时提供问题和上下文,模型只需从上下文中抽取答案。
构建开放域问答系统有哪些主流框架?
主要有三种:检索器-阅读器(先检索相关段落再抽取答案)、检索器-生成器(检索后直接生成答案)和闭卷生成式(仅靠模型参数记忆作答)。
检索器-阅读器框架中,检索器常用的实现方式有哪些?
常用两种:经典IR(如TF-IDF、BM25等非学习型方法)和神经IR(用神经网络生成稠密向量表示,通过点积计算相关性)。
端到端联合训练检索器和阅读器时,常用的优化目标是什么?
通常最大化获得正确答案的边际对数似然,即对检索到的段落边缘化后优化答案概率。例如ORQA、REALM、DPR等都采用这种目标。
闭卷问答中,生成式语言模型如何在没有外部知识的情况下回答问题?
大语言模型在预训练过程中将事实知识记忆在参数中,因此可以直接根据问题生成答案,无需检索外部文档。例如T5、GPT-3在闭卷设定下也能取得不错的效果。
在开放域问答中,最大内积搜索(MIPS)有什么作用?
MIPS用于快速从大量编码的段落中检索与问题最相关的段落,是检索器-阅读器/生成器框架中的关键组件,能加速推理过程。
