


什么是数据血统,为什么它很重要?
内容提要
数据血统是追踪和可视化数据在数据管道或系统中流动和转换的过程。它提供了对数据的起源、移动和转换的详细了解,帮助组织提高数据质量、确保合规性等。数据血统的重要性在于维护数据质量、满足法规要求、故障排除、影响分析、管理风险、审计和治理、提高操作效率等方面。一些常用的数据血统工具包括Collibra、Informatica Axon、IBM InfoSphere Information Governance Catalog、Apache Atlas和Erwin Data Intelligence。
延伸解读
数据血统的核心价值:从追踪到决策
数据血统不仅追踪数据流动,更通过可视化数据从源到目的地的完整路径,帮助组织理解数据依赖关系。这种透明性使数据专业人员能够快速定位数据质量问题、评估变更影响,并确保数据处理符合法规要求。它超越了简单的监控,成为数据治理和战略决策的基础工具。
实施数据血统的关键考量
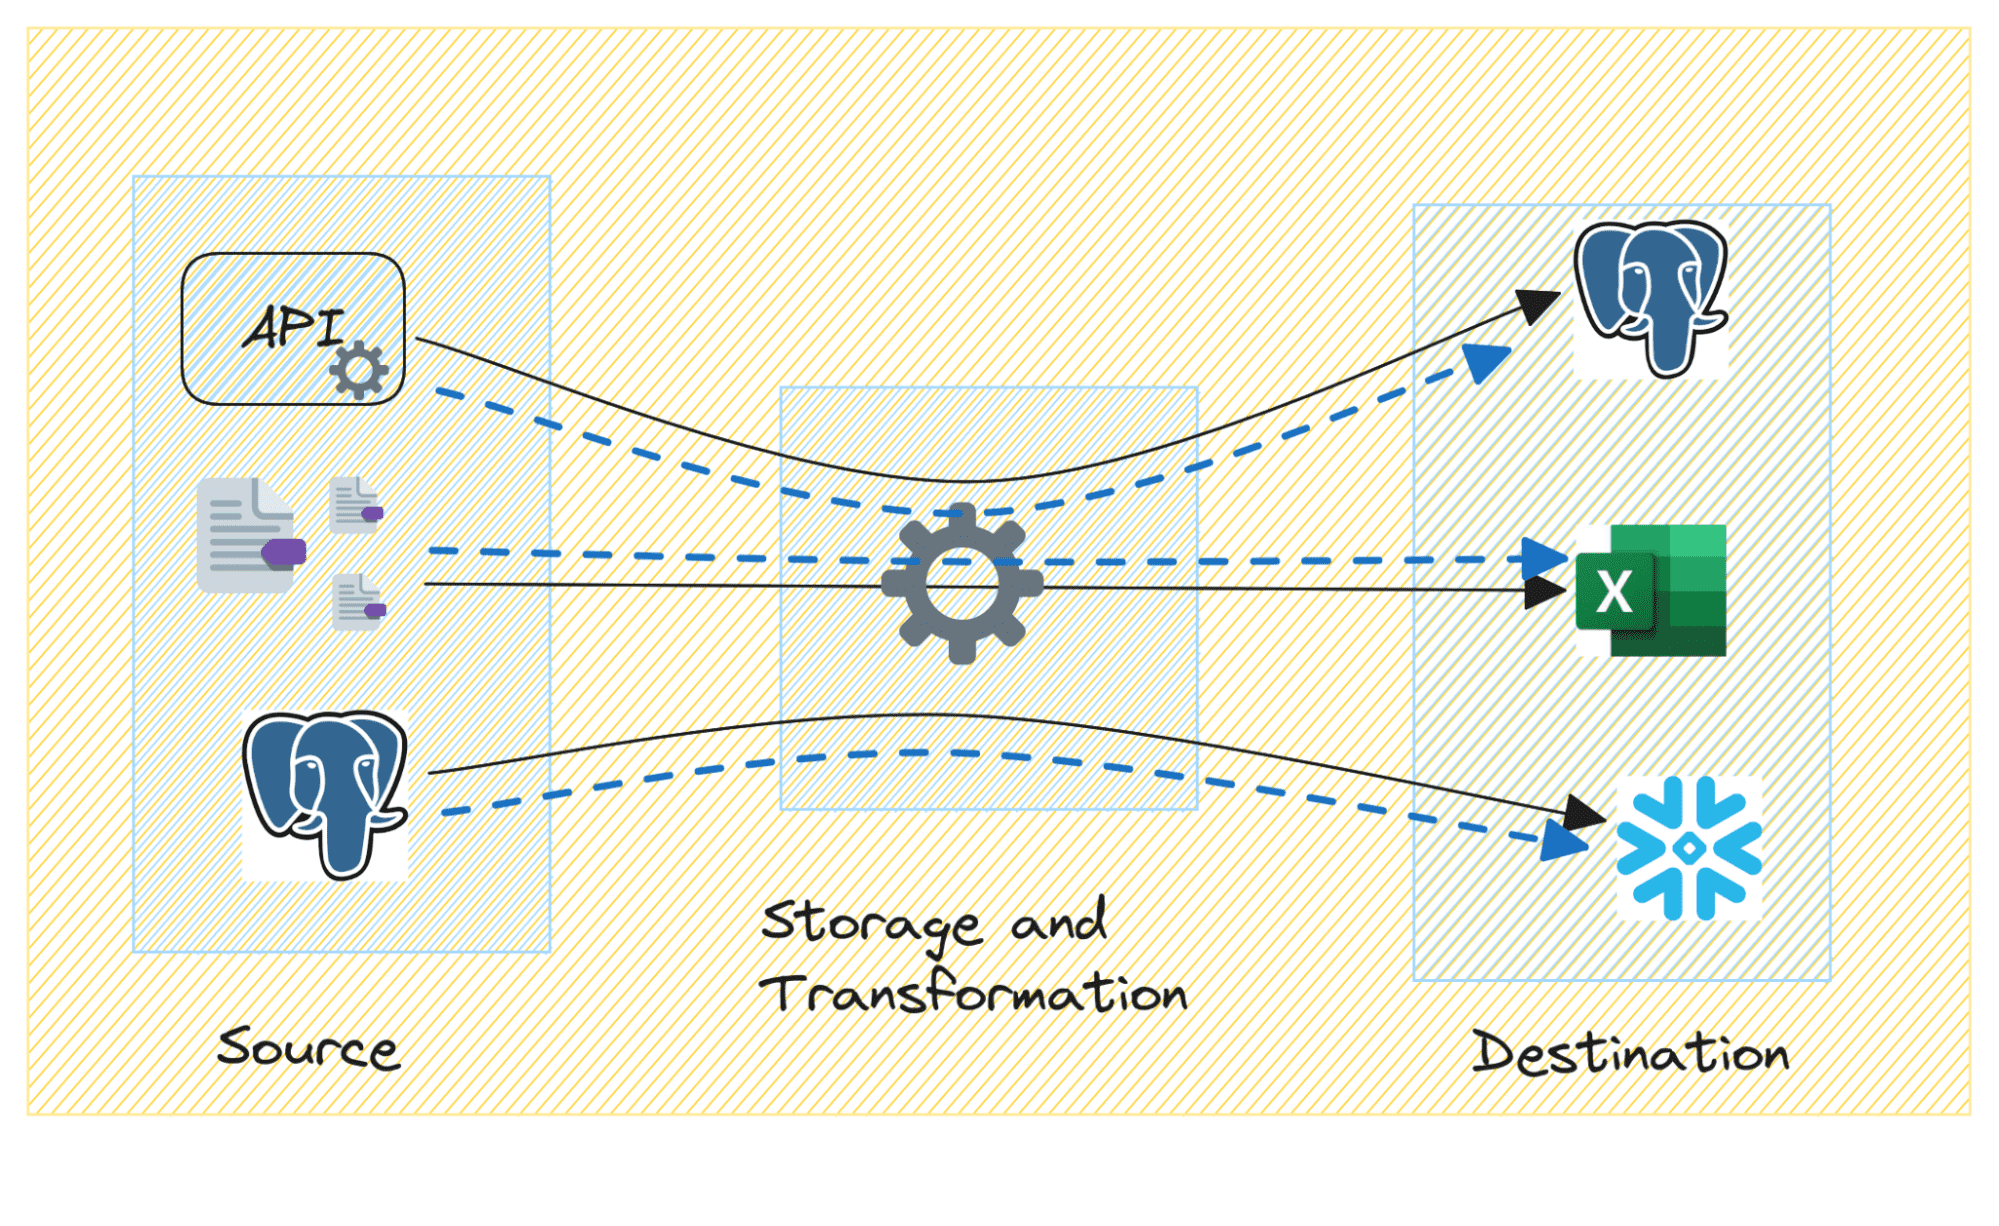
有效的数据血统需要覆盖源系统、元数据、数据移动与转换以及最终目的地等关键组件。组织在实施时应关注元数据的捕获,包括数据类型、格式和业务规则,并跟踪ETL过程。自动化工具可以持续监控数据流动,提供实时更新,但需根据现有数据架构和治理需求选择合适的平台。
数据血统的实际应用场景
数据血统在影响分析、风险管理和审计治理中发挥重要作用。例如,在修改数据源或流程前,通过血统视图评估潜在影响,避免意外后果。在审计时,详细的数据移动和转换记录能证明合规性。此外,通过识别冗余流程和瓶颈,数据血统有助于优化操作效率,减少处理时间。
Q&A
什么是数据血统?
数据血统是指追踪和可视化数据在数据管道或系统中流动和转换的过程。它提供对数据起源、移动和转换的详细了解,帮助组织提高数据质量、确保合规性等。
数据血统包括哪些关键组成部分?
数据血统的关键组成部分包括:源系统(如数据库、日志文件、传感器等)、元数据(数据类型、格式、业务规则等)、数据移动和转换(ETL过程)、以及最终目的地(数据库、数据仓库、数据湖等)。
为什么数据血统对数据质量很重要?
数据血统通过提供数据旅程的透明视图来维护数据质量,确保数据准确、可信并与业务目标一致。通过追踪数据流,组织可以快速识别和解决数据质量问题。
数据血统如何帮助满足法规合规要求?
数据血统通过提供数据移动、转换和存储的全面记录,帮助组织满足法规要求。它提供了从源到目的地的清晰可见性,是确保遵守法律和行业特定法规的稳健机制。
数据血统在故障排除中有什么作用?
数据血统通过提供识别故障点或不一致性的指南,简化了故障排除过程,帮助快速识别和解决数据问题,从而加速解决数据相关问题,减少停机时间和运营中断。
有哪些常用的数据血统工具?
常用的数据血统工具包括:Collibra、Informatica Axon、IBM InfoSphere Information Governance Catalog、Apache Atlas和Erwin Data Intelligence。
