Igor Suhorukov:PostgreSQL 19 中的向量化查询执行:PostgreSQL 扩展中的 Arrow、ORCA 与 Flight SQL
内容提要
作者开发了pg_vexec扩展,为PostgreSQL 19实现向量化查询执行,无需修改内核。该扩展通过规划器钩子让向量节点与行式路径按代价竞争,支持ORCA向量化规划、PAX列存批量读写、Arrow IPC帧跨节点传输及Flight SQL接口。239项回归测试通过,ClickBench提速19–24%,Flight SQL比二进制COPY快4.7倍。
延伸解读
扩展路线与内核修改的取舍
pg_vexec 选择以扩展形式实现向量化执行,不修改 PostgreSQL 内核,仅通过现有钩子接入。这避免了 openGauss 式分支难以合并的问题,也降低了部署门槛。但代价是部分能力受限,例如 Gather 仍逐行传递元组,UPDATE/DELETE 等场景无法使用向量节点。读者需注意:扩展方案在兼容性与性能之间做了明确权衡,并非所有查询都能受益。
ORCA 向量化规划的实际表现
文章将 ORCA 改造成向量化引擎,使其在代价模型中考虑向量节点,并在单节点和 MPP 集群上均可规划。但实测显示 ORCA 仍比 PostgreSQL 原生规划器慢 2.3–2.6 倍,主要因其计划是串行的。虽然 vexec 能带来 16–19% 的提升,但 ORCA 的并行能力受限于 gp_core 的设置。因此,ORCA 向量化更适合已有 Cloudberry 生态的用户,而非追求极致单机性能的场景。
Arrow 与 Flight SQL 的生态价值
Flight SQL 接口让客户端直接接收 Arrow 记录批次,省去了行式传输和驱动重组列的开销。实测中,百万行 lineitem 数据通过 Flight SQL 比二进制 COPY 快 4.7 倍,且 pyarrow 可零拷贝转为 NumPy 数组。对于 BI 和 ML 工作流,这意味着更少的序列化和更高的互操作性。但需注意,Flight SQL 仅作为补充,不替代 pgwire,且要求向量化执行器开启。
性能提升的边界与注意事项
ClickBench 上 vexec 在 auto 模式下为 PostgreSQL 规划器提速 19–24%,但部分查询如 COUNT(DISTINCT) 和文本列扫描反而变慢。force 模式会放弃索引路径,可能不如 auto 模式。此外,测量基于 1000 万行数据,与公开的 1 亿行结果不可直接比较。读者应关注:向量化并非万能,需根据查询特征和模式选择 auto 或 force,并留意文本列和去重聚合的潜在退化。
Q&A
pg_vexec 是什么?它如何在不修改 PostgreSQL 内核的情况下实现向量化查询执行?
pg_vexec 是一组为 PostgreSQL 19 设计的扩展,用于实现向量化查询执行。它通过 PostgreSQL 现有的规划器钩子(如 set_rel_pathlist_hook、set_join_pathlist_hook 和 create_upper_paths_hook)将向量节点插入计划,并让这些节点与行式路径按代价竞争。扩展完全通过钩子集成,无需修改内核,卸载后服务器行为与原生一致。
pg_vexec 如何与 ORCA 优化器集成?ORCA 如何支持向量化规划?
pg_vexec 通过 gp_orca 模块中的 API 注册向量化代价模型(CCostModelVec)、代价估算和节点构建器。CCostModelVec 继承自 CCostModelGPDB,对 ORCA 的代价公式进行两次评估(原始和向量化),并按内核步骤比例混合。ORCA 在搜索计划时直接考虑向量节点的代价,其翻译器将完成的节点交给 vexec,若 oracle 同意则替换为向量节点。
pg_vexec 支持哪些列存格式?如何实现列式数据的批量读写?
pg_vexec 支持 PAX 和 ao_column 列存格式。存储模块通过 vexec/source_v1 和 vexec/sink_v1 注册批量读取器和写入器。PAX 返回最多 131,072 行的组,切片为批次而不复制;ao_column 返回最多 16,384 行的块。VecInsert 替代 ModifyTable 的循环,将批次写入存储的 sink,或通过 table_multi_insert 每次 1,000 行写入堆表。
pg_vexec 如何通过 Arrow IPC 帧在集群节点间传输数据?
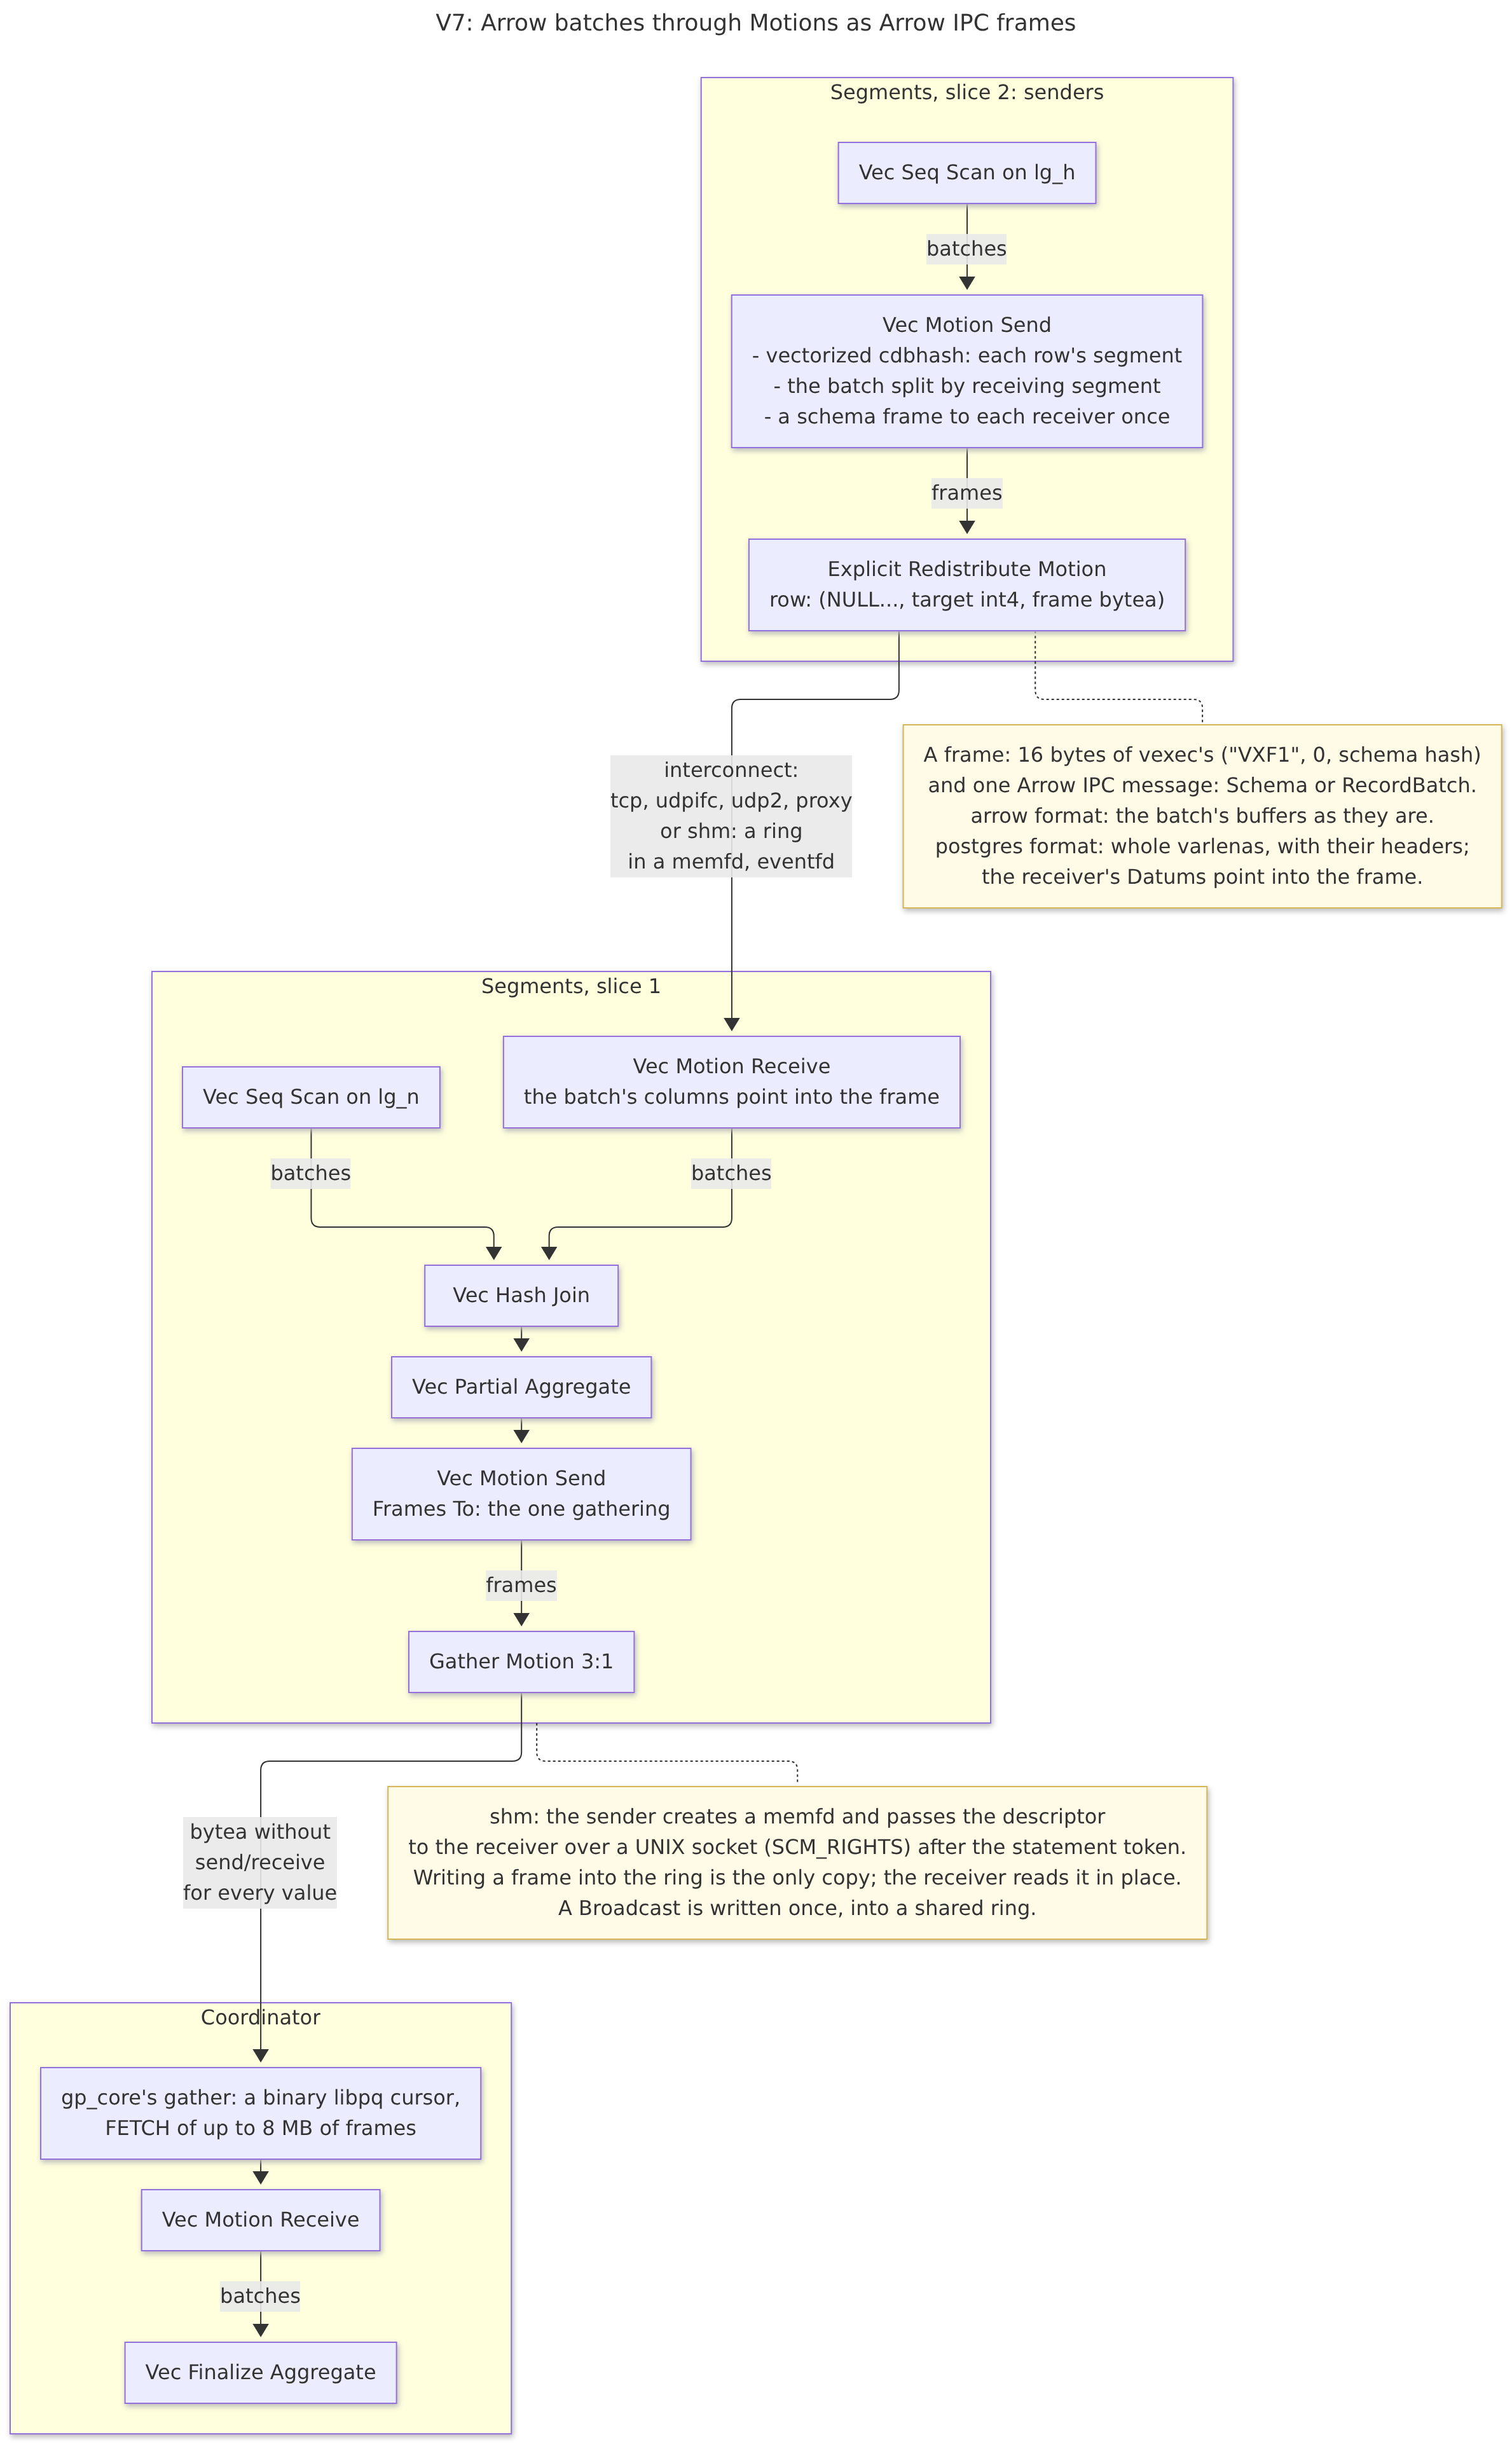
当 Motion 两侧都有向量节点时,vexec 在发送端放置 VecMotionSend,接收端放置 VecMotionReceive。批次作为 Arrow IPC 帧传输,帧包含 16 字节的 vexec 头(VXF1、保留字段、模式哈希)和 Arrow IPC 消息。在 arrow 格式下缓冲区直接发送;在 postgres 格式下 varlena 整体写入,接收端的 Datum 直接指向帧。向量化的 cdbhash 逐位复现 GpHashSegment,确保行发送到正确的段。
pg_vexec 的 Flight SQL 接口有什么优势?性能如何?
Flight SQL 接口直接从批次提供 Arrow 数据,客户端接收 Arrow record batches,无需行式转换。对于 BI 和 ML 工具,这避免了通过 pgwire 传输行再重新组装列的开销。性能上,Flight SQL 服务一百万行 lineitem 比二进制 COPY 快 4.7 倍;通过 adbc_ingest 插入数据到 porc_vec 比 COPY CSV 快 1.65 倍,比二进制 COPY 快 2.9 倍。
pg_vexec 如何支持 PostGIS 和 pgvector 函数在向量化执行中运行?
pg_vexec 通过内核包(kernel packs)声明哪些函数可以在批次上提前调用。声明分为三类:never raises(在批次活跃行上调用)、check(在检查通过的行上调用,其余由 PostgreSQL 评估)、prefilter(包有答案时采用,未决行交给函数本身)。这些声明绑定到扩展、版本和函数签名,并在 ALTER EXTENSION UPDATE 时丢弃。pgvector 和 PostGIS 的测试表明,使用 vexec 与不使用的结果一致。
pg_vexec 的性能提升如何?在 ClickBench 和 TPC-H 上的表现怎样?
在 ClickBench 上,pg_vexec 在 PostgreSQL 规划器下自动模式提升 19–24%,ORCA 下提升 16–19%,最佳查询提速 8.8–9.5 倍。TPC-H Q1 执行时间几乎减半。Flight SQL 服务百万行比二进制 COPY 快 4.7 倍。插入 20 万行到 porc_vec,Flight SQL 比 COPY CSV 快 1.65 倍,比二进制 COPY 快 2.9 倍。
pg_vexec 有哪些已知限制或注意事项?
限制包括:Gather 和 Gather Merge 仍基于行;ExecSetTupleBound 不适用于 CustomScan,VecSort 在计划时获取 LIMIT 边界;UPDATE、DELETE、MERGE 等没有向量节点;在原生 PostgreSQL 上 ORCA 计划是串行的;排序的 Gather Motion 不携带帧;PAX 没有 index_delete_tuples,可能导致插入失败;COUNT(DISTINCT) 分组字符串在自动模式下可能变慢;force 模式放弃索引路径(最近邻搜索除外)。
