

AI 规模化的可行性:探索和辩论 [译]
内容提要
文章以支持者与怀疑者的辩论形式,探讨AI规模化能否通向AGI。核心争议在于数据瓶颈:高质量数据可能耗尽,自我对弈与合成数据能否补足尚缺证据;基准测试多考察记忆而非长期推理,扩展效果存疑。作者估计2040年前实现AGI的概率约为70%,失败概率为30%。
延伸解读
数据瓶颈:规模化路线的关键制约
文章指出,高质量语言数据可能很快耗尽,而实现能撰写科学论文的AI所需数据量比现有数据多5个数量级。自我对弈和合成数据被视为潜在解决方案,但面临评估与计算两大难题:缺乏明确胜利条件时模型难以自我纠正推理错误,且搜索所有可能思维空间的计算成本极高。这提醒读者,规模化并非单纯增加算力,数据供给与自我改进机制的有效性才是决定成败的核心变量。
基准测试的局限:记忆与推理的错位
怀疑者强调,MMLU、BIG-bench等主流基准多考察记忆和回忆,而非长期推理或复杂问题解决能力。例如GPT-4在SWE-bench上仅1.7%的表现,远低于人类。支持者则以过去8个数量级的性能提升趋势反驳。读者需注意,基准分数高并不等同于通用智能,评估长期任务执行能力的测试才更能反映模型的实际泛化水平。
世界模型与智能本质的争论
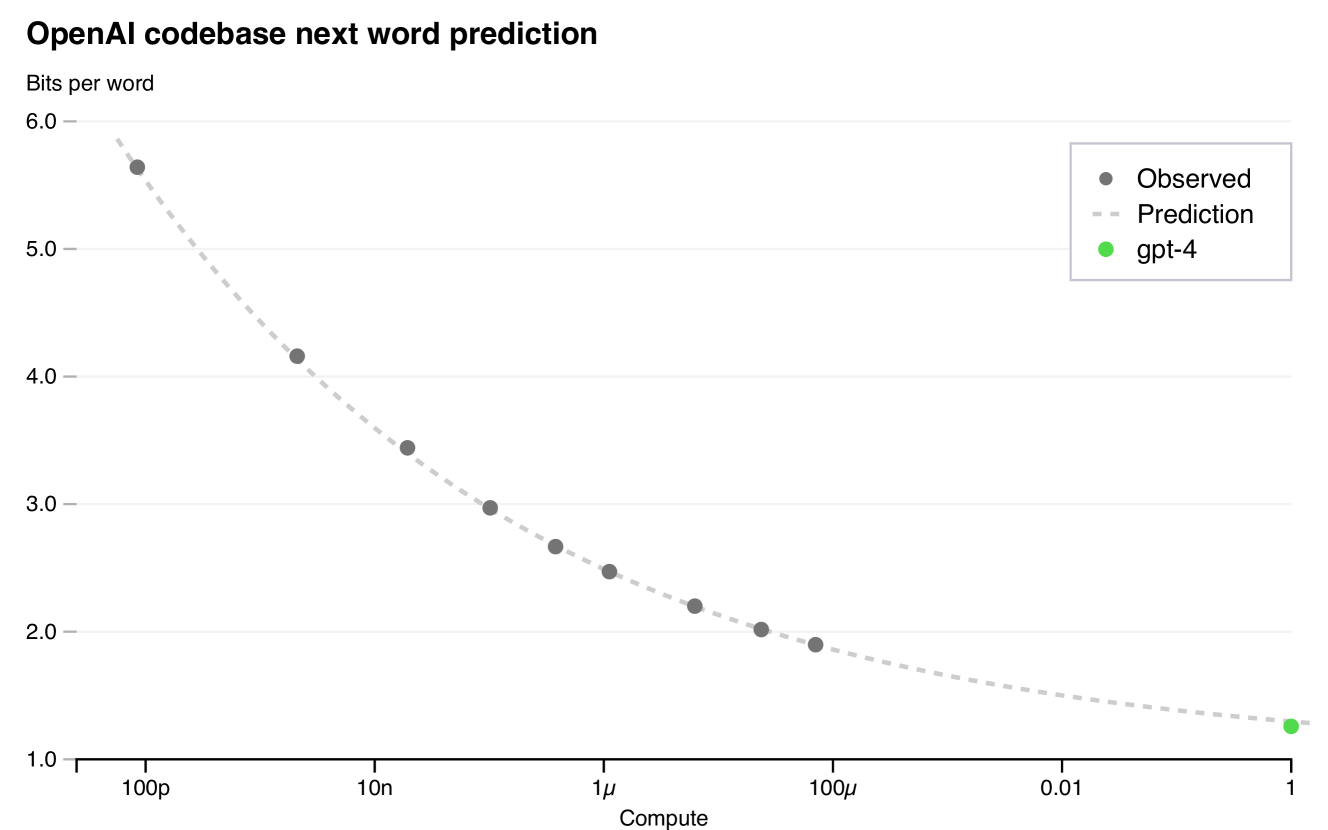
支持者认为,大语言模型为预测下一个词元必须学习世界规则,如GPT-4能生成LaTeX独角兽,表明其形成了内部世界模型。怀疑者反驳,智能不仅是信息压缩,梯度下降找到的压缩未必等同于人类洞察式学习。文章附录还讨论了“grokking”现象,但怀疑者指出模型仍缺乏基于洞察的快速学习能力。这提示读者,模型是否真正理解世界仍是开放问题。
作者的概率判断与不确定性来源
作者估计2040年前实现AGI的概率约为70%,失败概率30%。这一判断基于规模化趋势、算法进步和硬件发展,但也承认支持规模化持续有效的理论依据不清晰,且基准测试的普适性存疑。作者还提到,AI实验室保密导致公开研究稀少,可能遗漏关键证据。读者应理解,这一概率是个人主观估计,并非共识,实际进展可能因未公开的技术突破或瓶颈而偏离预期。
Q&A
AI规模化面临的最大瓶颈是什么?
最大瓶颈是高质量语言数据可能即将耗尽。怀疑者指出,要实现能撰写科学论文的AI,需要约1e35 FLOPs的计算量,而现有数据量比需求少5个数量级(即10万倍)。即使通过算法改进、多模态训练、重复利用Token等方式,也难以弥补这一巨大缺口。
自我对弈和合成数据为什么难以解决数据短缺问题?
自我对弈面临两大难题:一是评估困难,许多推理任务没有明确的胜利条件,大语言模型无法自我纠正推理错误;二是计算成本极高,在思维空间中进行树状搜索所需的计算量比当前最大模型还要高出多个数量级。此外,目前尚无公开证据表明合成数据在大规模上有效。
当前AI基准测试能证明模型具有真正的智能吗?
不能完全证明。怀疑者指出,MMLU、BIG-bench等基准测试主要考察记忆和回忆能力,问题多是谷歌搜索的第一个结果,不能代表智能。而真正检验长期问题解决能力的测试(如SWE-bench)中,GPT-4表现仅1.7%,Claude 2仅4.8%,说明模型在复杂任务上仍远落后于人类。
支持者认为大语言模型已经理解世界了吗?依据是什么?
支持者认为模型通过预测下一个token必须自学世界规则,从而形成对世界的内部理解。证据包括:GPT-4能编写LaTeX代码绘制独角兽,尽管训练数据中可能没有此类示例;在Othello游戏实验中,Transformer仅通过分析游戏记录就能重建棋盘状态,表明其发展出了内在表示。
作者对2040年前实现AGI的概率估计是多少?
作者估计有70%的概率通过规模扩大、算法进步和硬件发展,在2040年前实现AGI;另有30%的概率怀疑者是对的,即大语言模型等技术可能无法成功。
灵长类大脑的进化对AI扩展性有什么启示?
灵长类大脑的神经元数量随大脑质量增加而线性增长,扩展性优于啮齿动物。这暗示灵长类的神经结构具有更好的扩展性,类似于Transformer相较于LSTM的扩展优势。进化在灵长类中发现了智能边际增加被强烈奖励的规律,支持了规模化可能有效的观点。
