

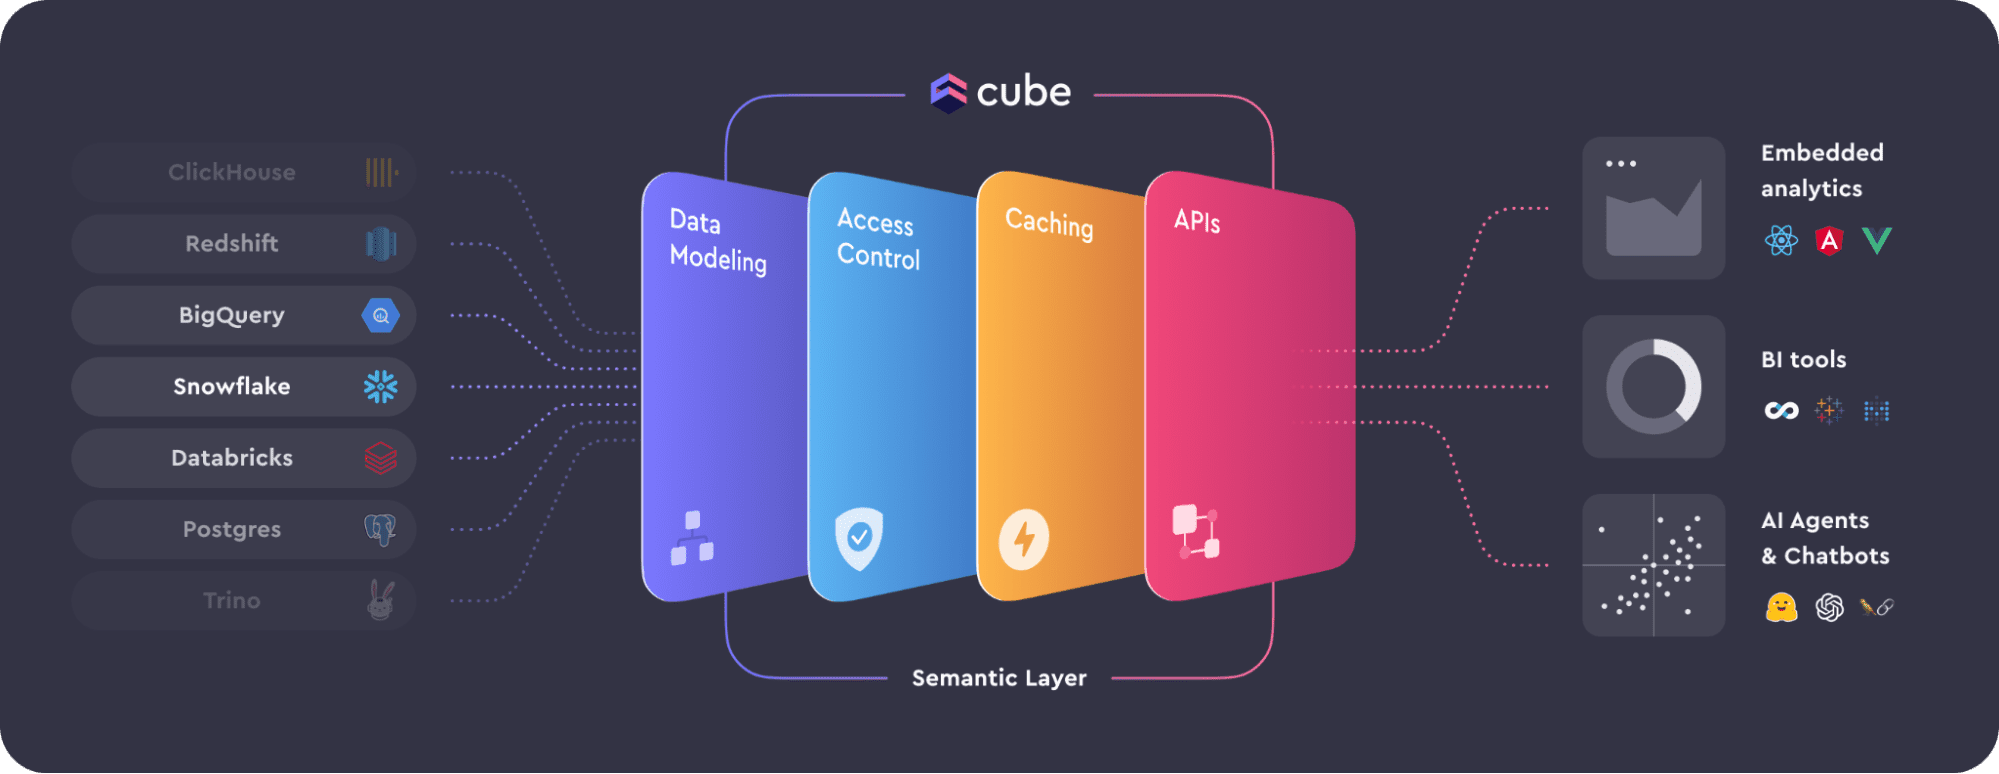

通用语义层对您的数据堆栈有益的6个原因
内容提要
语义层在数据堆栈中的作用和优势,连接数据源和分析工具,提供有意义的数据给用户。包含业务规则、数据定义和元数据,标准化报告工具和数据源之间的词汇。关键层次有数据建模、数据访问控制、缓存和API。好处包括数据一致性、数据安全、数据性能、堆栈灵活性、快速上市、未来可扩展性。应用包括嵌入式分析、商业智能和人工智能。
延伸解读
语义层如何充当数据堆栈的“中间件”
文章将语义层定位为数据源与分析工具之间的桥梁,其核心作用是抽象原始数据并以业务可理解的方式呈现。它通过预定义的业务规则、数据定义和元数据,统一了报告工具与数据源之间的词汇。这种中间件角色意味着,无论底层数据源如何变化,上层应用都能通过语义层获得一致的指标和见解,从而降低现代数据环境的复杂性。
四个关键层次的实际意义
语义层包含数据建模、数据访问控制、缓存和API四个层次。数据建模集中管理指标定义,避免各工具各自为政;访问控制在上游统一管理权限,降低安全风险;缓存通过存储数据减少冗余查询,提升响应速度并降低成本;API确保不同数据源与下游应用的兼容性。这四个层次共同支撑了语义层在一致性、安全、性能和集成方面的价值。
语义层对开发效率与业务敏捷性的影响
文章指出,语义层能显著缩短开发者创建或维护数据应用和数据模型的时间,嵌入式分析场景下开发周期可从数月缩短至数天。同时,由于数据逻辑被抽象,团队可以灵活选择工具而不牺牲创新。语义层还能适应业务需求变化和新数据源,为长期敏捷性提供保障。这些优势直接关系到上市时间和数据团队的生产力。
Cube在报告中的定位与启示
文章提到Cube在GigaOm Sonar报告中被评为领导者和快速移动者,其优势包括强大的代码优先导向、原生API支持,以及通过缓存和预聚合实现的分析预处理。这提示读者,在选择语义层方案时,可关注其是否具备代码优先、API原生和缓存优化等特性,这些特性与文章强调的性能、灵活性和开发效率直接相关。
Q&A
什么是语义层?它在数据堆栈中起什么作用?
语义层是一种中间件,充当数据源和分析工具之间的桥梁。它作为上下文过滤器,抽象原始数据并以有意义的方式呈现给最终用户。它包含预定义的业务规则、数据定义和元数据,标准化报告工具和数据源之间的词汇。
语义层包含哪四个关键层次?各自有什么功能?
语义层的四个关键层次是:数据建模(组织数据并提供一致的见解和指标)、数据访问控制(集中管理授权用户的数据访问)、缓存(存储数据以避免冗余查询,优化性能)、API(确保不同数据源和下游应用程序之间的兼容性)。
为什么数据堆栈需要语义层?主要好处有哪些?
语义层能带来六方面好处:确保数据一致性、增强数据安全(集中访问控制)、提升数据性能(缓存优化响应时间)、提供堆栈灵活性(工具选择不影响创新)、加快上市时间(减少开发维护时间)、实现未来可扩展性(适应变化和新数据源)。
语义层如何帮助提升数据安全性?
语义层通过集中控制数据访问来降低安全风险。它在一个位置管理授权用户的数据访问,确保遵守数据隐私法规,从而减少数据泄露的可能性。
语义层在嵌入式分析中有哪些应用和优势?
在嵌入式分析中,语义层能加速应用开发,将开发时间从几个月缩短到几天。它解决跨堆栈不兼容问题,支持自定义数据体验,并提升应用性能。
语义层如何支持人工智能和基于LLM的应用?
语义层促进专有数据与人工智能的轻松集成,简化复杂的连接,并提升查询响应时间。其缓存层优化响应时间,对实时处理和人工智能应用至关重要。
Cube在语义层领域获得了什么认可?其优势是什么?
Cube在GigaOm Sonar报告中被评为领导者和快速移动者。其优势包括强大的代码优先导向、原生API支持,以及通过缓存和预聚合实现的分析预处理。
