

简单聊聊因果推断
内容提要
文章以药企提升患者用药依从性为例,说明许多问题需从系统层面厘清各因素关系,而非简单归因。作者介绍因果推断:相关性不等于因果性,需警惕混杂因子造成的伪相关;并梳理潜在结果模型、随机实验、因果图与后门准则等工具,以及Uplift模型在营销中识别增量收益的应用,认为因果推断前景广阔但仍待发展。
延伸解读
从系统视角看问题:避免局部优化
文章以药企提升患者用药依从性为例,指出若仅归因于患者个人动机,可能忽略医生支持、医保报销、社区资源等系统因素。这提醒我们,面对复杂问题时,应厘清各元素间的因果关系,而非简单归因。局部优化往往无法解决根本问题,需要从系统层面寻找杠杆解。
因果推断的核心工具:潜在结果与因果图
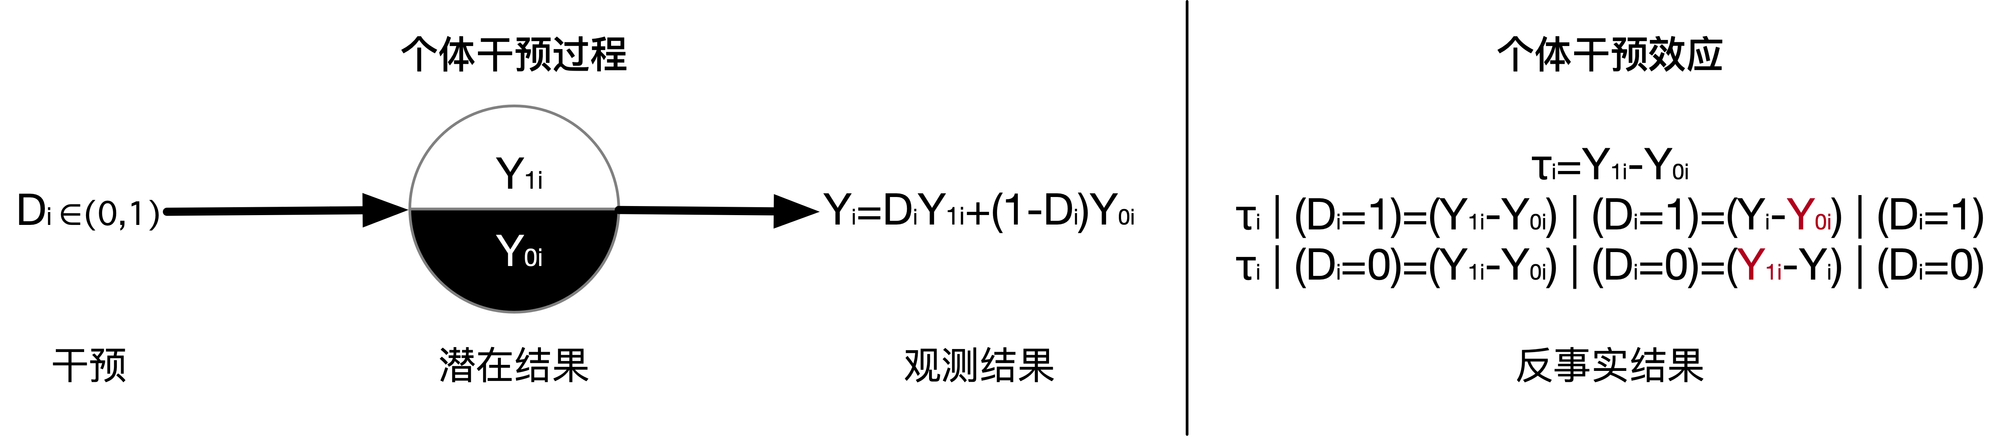
文章介绍了潜在结果模型和因果图。潜在结果模型通过比较同一对象在不同处理下的结果来定义因果效应,但面临“因果推理的基本问题”。因果图则用有向无环图表示变量关系,借助后门准则识别混杂因子,从而消除伪相关。这些工具为从观察数据中推断因果提供了结构化方法。
Uplift模型:识别增量收益的实践应用
在营销场景中,传统模型只能预测用户购买意愿,无法区分自然转化和受活动刺激的增量。Uplift模型通过预测处理变量带来的增量反馈,帮助找到对活动最敏感的人群(persuadables),避免对“sleeping dogs”等无效人群投入。这体现了因果推断在互联网业务中的实用价值。
现状与挑战:因果推断仍待发展
文章指出,因果推断在AI和互联网具体场景中仍很原始,因果发现、因果强化学习等子方向还在蓬勃发展中。现实中干预目标的已知因子和混杂因子非常多,如何找到合适因子是一大难题。尽管前景广阔,但实际应用仍需谨慎,避免过度简化复杂系统。
Q&A
为什么说相关性不等于因果性?能举个例子吗?
相关性只描述变量之间的统计关联,无法处理共同混杂因子,容易产生伪相关。例如抽烟的人容易黄手指,也容易得肺癌,但黄手指并不会导致肺癌,抽烟是两者的混杂因子,造成了黄手指与肺癌的伪相关。
因果推断的三个层级分别是什么?
朱迪尔·珀尔提出因果阶梯论,分为三个层级:第一层是相关(association),涉及预测和变量关联;第二层是干预(intervention),涉及因果性;第三层是反事实(counterfactuals),回答“如果情况不是这样会怎样”的问题。
潜在结果模型是什么?它为什么被称为因果推断的基本问题?
潜在结果模型由内曼提出,指一个或多个处理作用在个体上产生的预期效果。由于个体只能观察到一种处理下的结果,另一种潜在结果无法观测,这种缺失被称为“因果推理的基本问题”。鲁宾将其扩展为鲁宾因果模型,用于观察性和实验性研究。
随机实验如何帮助估计因果效应?如果无法做随机实验怎么办?
随机实验通过随机分配处理组和对照组,使各组平均相等,从而将结果差异归因于处理,计算平均处理效应。当随机实验因伦理或实际问题不可行时,可采用倾向得分匹配等统计方法,通过寻找类似处理单元的控制单元来纠正非随机分配机制。
因果图中的混杂因子是什么?如何消除它的影响?
混杂因子是因果变量之间的共因,能阻断因果变量之间所有后门路径的变量。例如抽烟是黄手指和肺癌的混杂因子。可以通过后门准则,阻断所有后门路径来消除混杂因子的影响,从而识别因果关系。
Uplift模型在营销中有什么作用?它和传统预测模型有什么区别?
Uplift模型用于预测一个treatment的增量反馈价值,即用户被干预后购买意愿的增量。传统模型只能预测用户购买意愿,无法区分自然转化人群和对活动敏感人群。Uplift模型通过给每个用户一个lift score,帮助找到“persuadables”人群,精准定位对营销活动最敏感的用户。
