


大语言模型的对抗攻击
内容提要
本文综述大语言模型的对抗攻击。攻击分为白盒与黑盒:白盒利用梯度,如GBDA、HotFlip、UAT、GCG;黑盒包括token替换、越狱提示、人工与模型红队。防御手段有对抗训练、困惑度过滤、复述与重分词。核心是攻击与防御的持续博弈。
延伸解读
白盒与黑盒攻击的差异
白盒攻击假设攻击者能获取模型权重和梯度,从而使用GBDA、HotFlip、UAT、GCG等方法优化对抗输入;黑盒攻击仅能通过API访问模型,依赖token替换、越狱提示或红队测试。白盒攻击通常更高效,但仅适用于开源模型;黑盒攻击更贴近现实威胁,但难度更高。两者在威胁模型和实际可行性上存在根本区别。
对抗攻击的常见类型
文章将对抗攻击分为五类:token操纵、基于梯度的攻击、越狱提示、人工红队和模型红队。token操纵和越狱提示属于黑盒,基于梯度的攻击属于白盒。人工红队和模型红队则从不同角度模拟攻击者。这些分类有助于理解攻击的多样性和防御的针对性。
防御策略与持续博弈
针对对抗攻击,文章提到对抗训练、困惑度过滤、复述和重分词等防御手段。这些方法旨在检测或消除对抗性输入的影响。然而,攻击与防御是持续博弈的过程,单一防御可能被新攻击绕过。读者应关注防御方法的局限性和自适应攻击的挑战。
Q&A
大语言模型的对抗攻击主要分为哪几类?
根据文章,对抗攻击主要分为五类:Token操纵(黑盒)、基于梯度的攻击(白盒)、越狱提示(黑盒)、人工红队(黑盒)和模型红队(黑盒)。
白盒攻击和黑盒攻击有什么区别?
白盒攻击假设攻击者完全掌握模型权重、架构和训练流程,可以获取梯度信号,仅适用于开源模型;黑盒攻击假设攻击者只能通过API访问模型,提供输入并获得输出,无法获知模型内部信息。
有哪些基于梯度的对抗攻击方法?
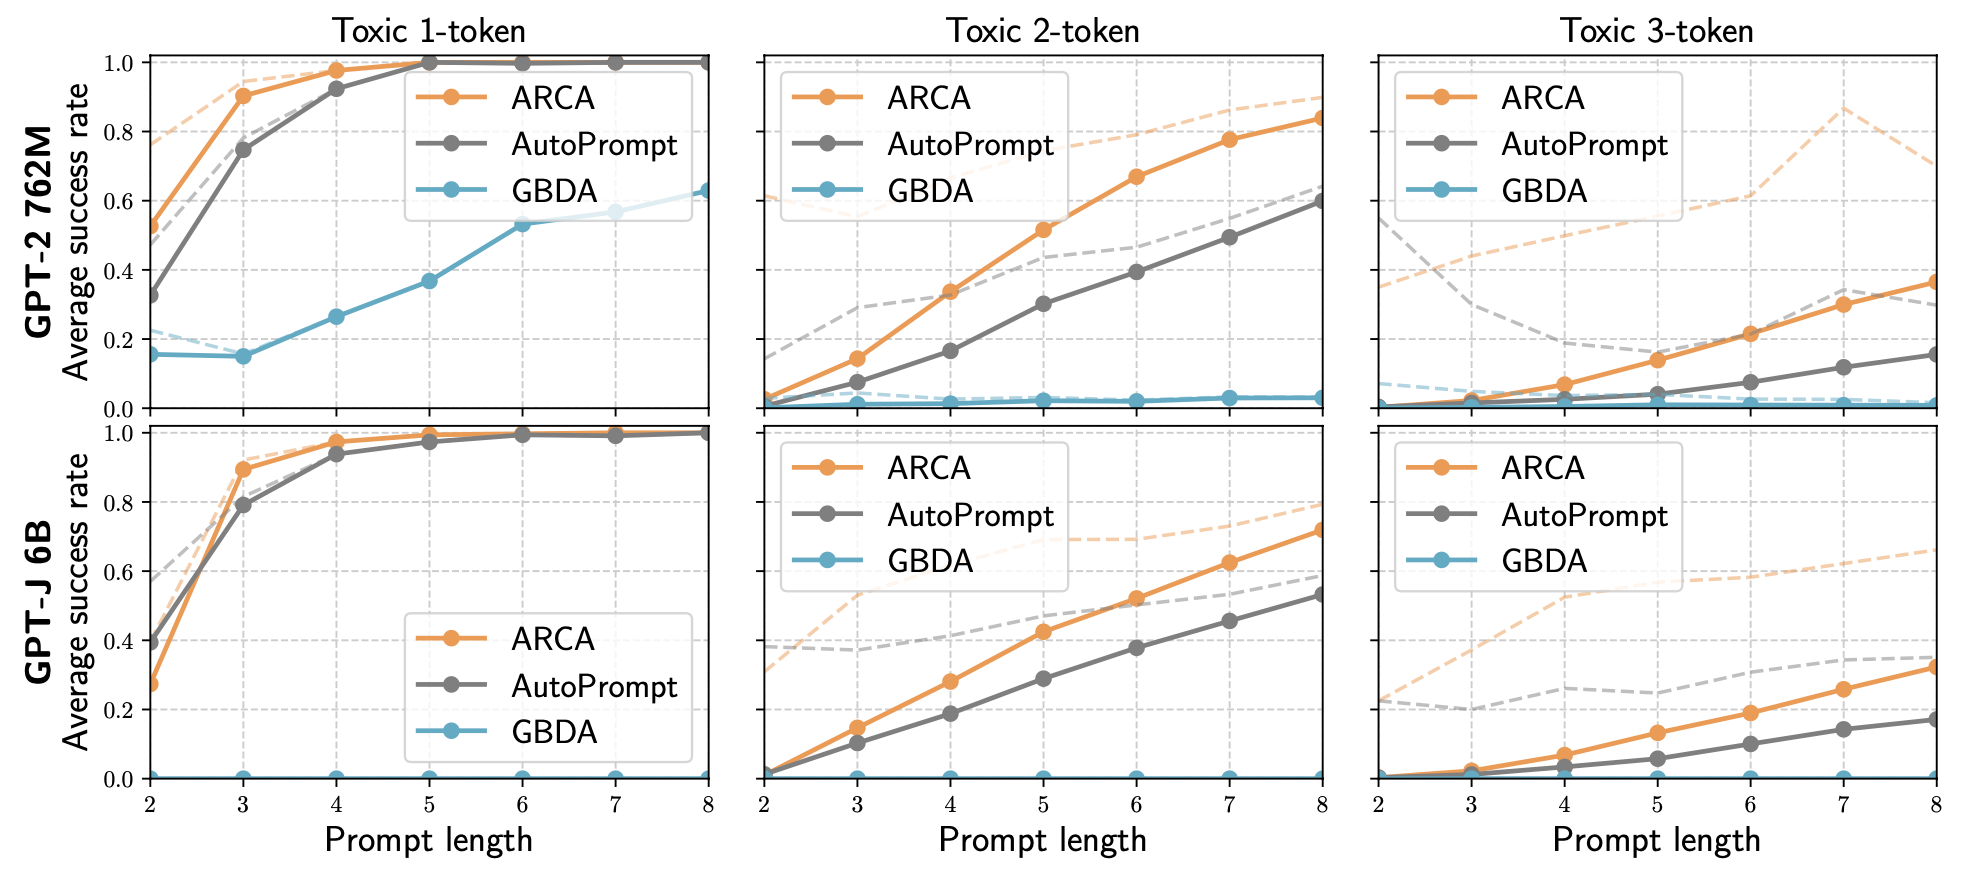
基于梯度的攻击方法包括:GBDA(使用Gumbel-Softmax近似使对抗损失可微)、HotFlip(将文本操作视为向量空间输入,用一阶泰勒展开近似损失变化)、UAT(通用对抗触发器,通过梯度引导搜索找到输入无关的触发词)、AutoPrompt(利用梯度搜索寻找有效提示模板)、GCG(贪婪坐标梯度搜索)和ARCA(自回归随机坐标上升)。
什么是越狱提示攻击?
越狱提示攻击是一种黑盒攻击,通过启发式或手动设计的提示词触发大语言模型输出本应被缓解的有害内容。它利用两种失败模式:竞争目标(如模型能力与安全目标冲突)和泛化不匹配(安全训练未能泛化到某些领域)。常见技巧包括前缀注入、拒绝抑制、风格注入、角色扮演、特殊编码、字符变换等。
模型红队是如何工作的?
模型红队使用一个红队模型(red-teamer)来对抗目标LLM,以触发不安全响应。主要挑战是判断攻击是否成功,通常使用一个有害内容分类器作为奖励信号。训练红队模型的方法包括零样本生成、随机少样本生成、监督学习和强化学习。
对抗攻击的防御手段有哪些?
文章提到的防御手段包括对抗训练、困惑度过滤、复述与重分词。核心是攻击与防御的持续博弈。
