
GSoC 2026:将 LLVM-libc 的浮点例程共享给 compiler-rt
内容提要
GSoC 2026 项目将 LLVM-libc 的浮点数学例程共享给 compiler-rt,取代其各架构独立的软浮点实现,统一为单一来源。通过 CMake 宏按需启用,覆盖算术、类型转换与比较等约七十个内建函数。项目解决了自调用、16 位浮点、x87 80 位格式及符号冲突等难题,并用生成器统一管理。后续将进行基准测试与优化。
延伸解读
统一软浮点实现的意义
文章指出,LLVM 长期维护两套软浮点实现:compiler-rt 的 builtins 和 LLVM-libc 的数学例程。两套代码独立演化,导致修复和测试重复,且 compiler-rt 的版本更旧、验证更少。本项目将 compiler-rt 的 builtins 改为转发到 LLVM-libc 的共享例程,从而消除重复,让 LLVM 只需维护一份经过充分测试的代码。这有助于减少不一致和潜在错误。
按需启用的构建策略
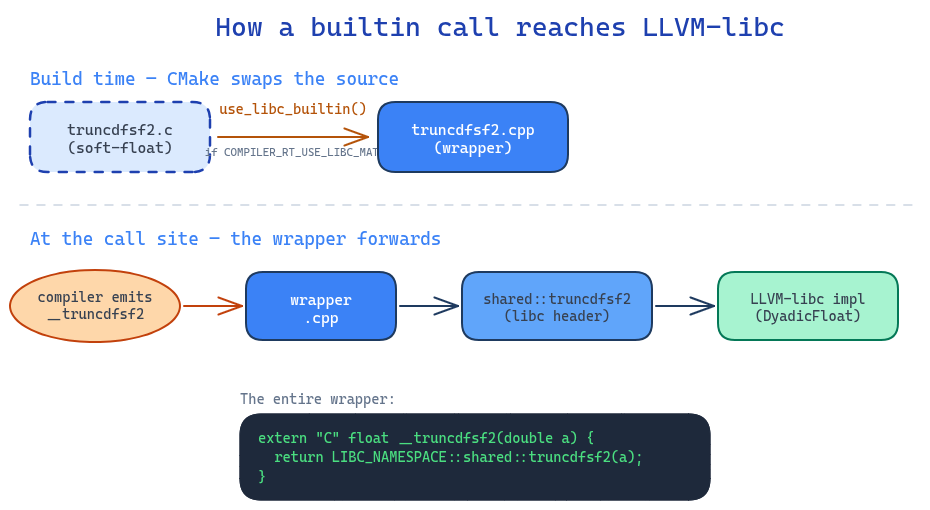
共享通过 CMake 宏 use_libc_builtin() 实现,并受 COMPILER_RT_USE_LIBC_MATH 选项控制。这意味着发行版可以选择启用基于 libc 的路径,而其他用户保持原有行为。这种设计降低了迁移风险,允许逐步采用,同时为未来默认切换奠定基础。文章提到,该宏将 .c 文件替换为调用 shared:: 命名空间的 .cpp 包装器。
技术挑战与应对
项目遇到多个难题:某些转换例程在无 FPU 目标上会自调用导致无限递归,解决方案是改用纯整数表示;16 位浮点类型并非所有目标都支持,因此例程通过原始位和格式描述来重建数值;x87 80 位格式布局特殊且需要 128 位整数,在 32 位 x86 上不可用,故仅在支持处编译并通过标准 double/float 转换;符号冲突通过私有命名空间避免。这些方案确保了共享例程的可用性。
后续工作与优化方向
功能合并后,下一步是基准测试与优化。将在软浮点 Arm、无 SSE 的 x86 和裸机嵌入式配置上比较每个 builtin 的延迟和代码大小,并使用 Raspberry Pi Pico 2 进行测试。优化将关注热点路径和代码大小。同时,伴随项目引入模拟的 Float128、Float80 和 float16 类型,有望消除自调用变通方法,简化转换并释放优化空间。
Q&A
GSoC 2026 中这个项目的主要目标是什么?
将 LLVM-libc 的浮点数学例程共享给 compiler-rt,取代其各架构独立的软浮点实现,统一为单一来源。
为什么需要将 LLVM-libc 的浮点例程共享给 compiler-rt?
因为 LLVM 维护了两套独立的软浮点实现,导致代码重复、维护成本高,且 compiler-rt 的版本更旧、验证不如 libc 严格。共享后可以统一为单一来源,减少重复。
这个项目具体是如何实现共享的?
LLVM-libc 将例程以 freestanding 头文件形式暴露在 LIBC_NAMESPACE::shared:: 下,compiler-rt 的每个 builtin 变成薄包装,转发到对应的 libc 例程。通过 CMake 宏 use_libc_builtin() 控制,由 COMPILER_RT_USE_LIBC_MATH 选项启用。
项目覆盖了哪些类型的浮点 builtin?
覆盖算术 builtin(float、double、float128 的加、减、乘、除)、浮点与整数之间的转换(各种整数宽度)、浮点格式之间的扩展和截断(包括 x87 80 位、half、bfloat16)以及比较例程。
在共享过程中遇到了哪些主要技术挑战?
主要挑战包括:例程自调用问题(转换被编译器转回 builtin 导致无限递归)、16 位浮点类型在目标上不存在、x87 80 位格式不符合标准 IEEE 布局且需要 128 位整数、以及符号冲突。
如何解决例程自调用的问题?
通过内部仅使用整数的表示来进行转换,这样编译器不会将其转回浮点 builtin,从而打破循环。
项目接下来的计划是什么?
下一步是进行基准测试和优化。将在软浮点 Arm、无 SSE 的 x86 和裸机嵌入式配置上比较 libc 支持的 builtin 与 compiler-rt 原始版本的每次调用延迟和代码大小,并在 Raspberry Pi Pico 2 上测试。同时,随着模拟软浮点类型的引入,转换将简化,优化空间更大。
