
模型蒸馏入门指南
内容提要
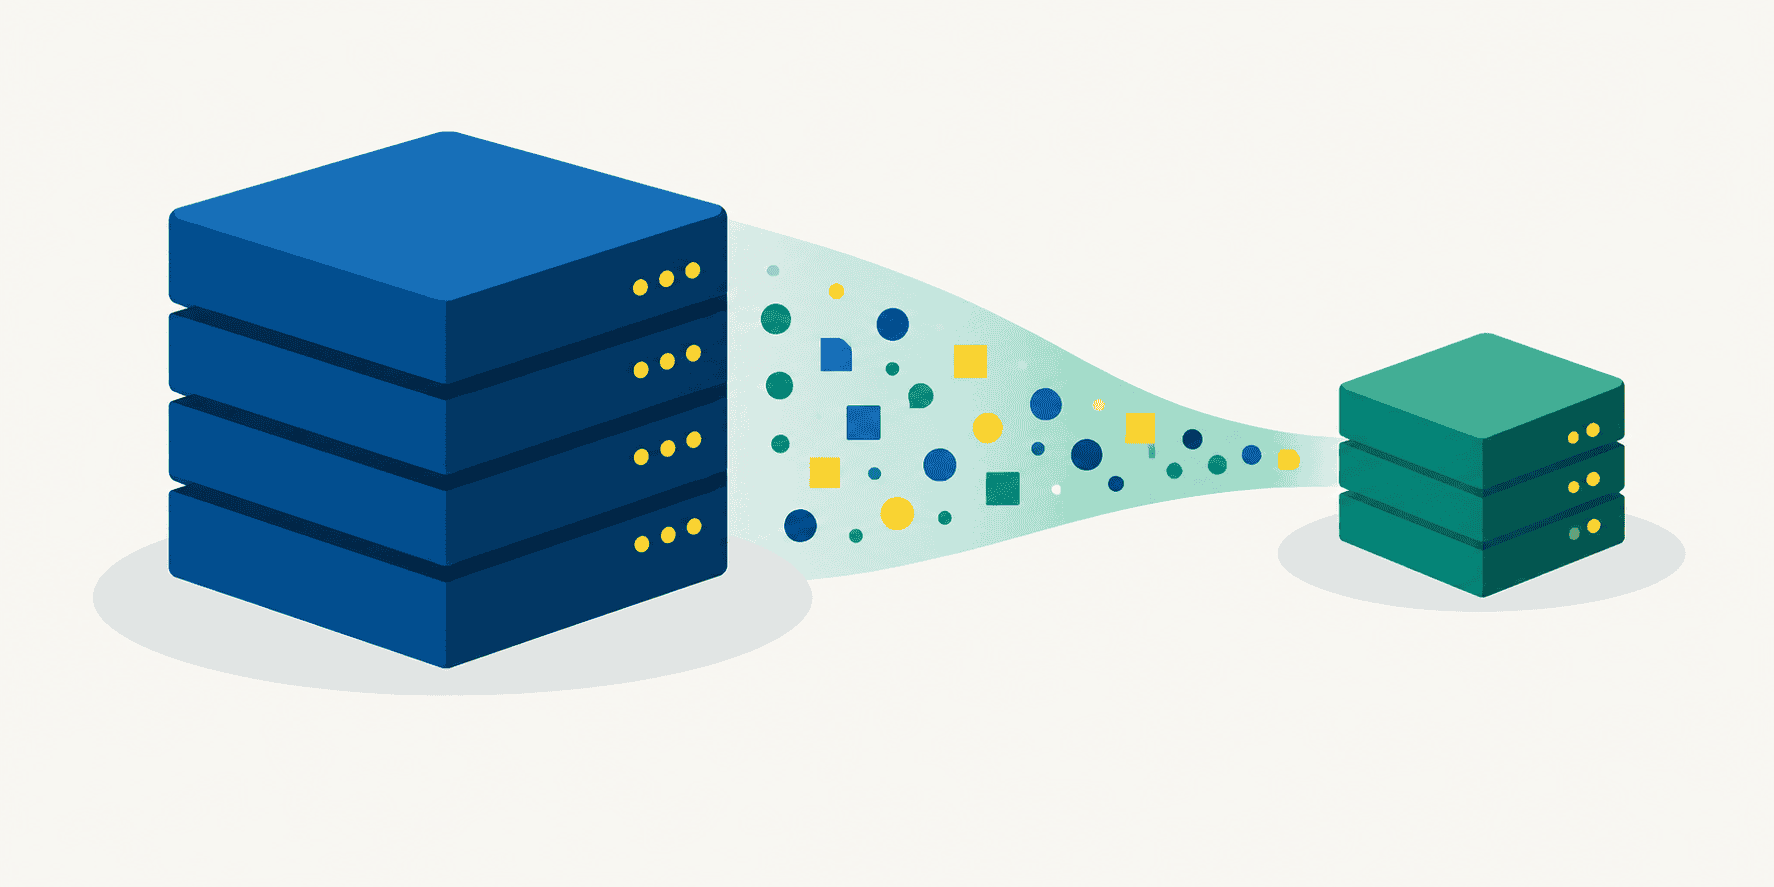
模型蒸馏让小模型学习大模型行为,降低成本和部署门槛。经典方法通过软标签和温度缩放传递暗知识;大模型时代主要依赖合成数据、特征和logit蒸馏。蒸馏本身是常规工程实践,但未经授权的大规模蒸馏引发行业与法律冲突,目前尚无清晰解决方案。
延伸解读
蒸馏技术为何从经典方法转向合成数据
经典蒸馏依赖教师模型的软标签和温度缩放,但大语言模型输出词汇量巨大且序列生成,直接匹配概率分布不现实。因此现代蒸馏主要采用合成数据:教师生成高质量文本,学生直接学习。这种方法只需API访问,不涉及模型内部,降低了技术门槛,也使得未经授权的蒸馏更容易发生。
未经授权蒸馏的争议核心:规模与权限
蒸馏本身是行业常规做法,但争议在于未经许可的大规模蒸馏。2026年多家实验室指控对手通过虚假账户和路由手段系统性提取能力,规模达数千万次交互。这不同于研究者实验,而是有组织地绕过访问控制,针对特定能力。法律上,由于AI输出通常不受版权保护,执法依赖服务条款,对境外实体效果有限。
蒸馏争议暴露的结构性矛盾
模型通过API提供商业服务时,其输出必然包含足够信号训练出能力相近的小模型。因此,让模型可用与保护其研发投资之间存在根本张力。行业尝试的防御手段如输出水印、异常检测和限流各有局限:水印可被去除,限流影响正常用户,司法管辖区差异使法律执行复杂。这一问题尚无清晰解决方案。
Q&A
模型蒸馏是什么?它为什么能降低部署成本?
模型蒸馏是一种让较小的“学生”模型学习复制更大“教师”模型行为的技术。学生模型最终只有教师模型的一小部分大小,但保留了相当多的能力,从而降低计算成本和部署门槛,使模型能运行在手机、浏览器等资源受限环境中。
经典蒸馏中的“暗知识”和温度缩放分别指什么?
“暗知识”是Hinton提出的概念,指教师模型输出的概率分布中蕴含的、硬标签无法体现的类别间相似性信息。温度缩放是一种技术,通过提高温度来“软化”教师模型的输出分布,使类别间的细微差异变得可见,从而让学生模型学习到更丰富的信号。
现代大语言模型蒸馏主要采用哪三种方法?它们对教师模型的访问要求有何不同?
现代大语言模型蒸馏主要有三种方法:合成数据蒸馏、特征蒸馏和logit蒸馏。合成数据蒸馏只需访问教师的文本输出(如API),是当前主流;特征蒸馏需要访问教师内部架构的中间层激活;logit蒸馏需要白盒访问教师的完整token概率分布。后两者通常用于组织内部蒸馏自己的模型。
为什么未经授权的大规模蒸馏会引发行业争议?
争议不在于蒸馏技术本身,而在于未经许可跨组织边界大规模提取他人模型能力。2026年初,多家AI实验室指控有组织通过虚假账户、第三方路由等方式系统性地绕过访问控制,针对特定高级能力(如代理推理、工具使用、编码)进行蒸馏,规模巨大。这引发了法律和行业冲突,而现有法律框架尚不明确。
蒸馏是合法的工程实践吗?行业内部如何使用它?
是的,蒸馏是完全正常的工程实践。Meta设计Llama 3.1 405B时明确将其作为教师模型,许可使用其输出训练更小的变体。每个主要AI实验室都 routinely 将自己的大模型蒸馏为更小、更便宜的版本,用于不同产品层级和部署场景。开源生态中的Alpaca、Vicuna等也基于合成数据蒸馏。
针对未经授权蒸馏,目前有哪些技术或法律应对措施?效果如何?
技术防御包括异常检测、输出水印和速率限制;法律策略包括更积极地执行服务条款和立法倡导。OpenAI、Anthropic和Google已开始共享反蒸馏情报。但这些措施都不完美:水印可被剥离,速率限制影响合法用户,管辖权缺口使法律执行复杂。目前尚无清晰解决方案。
