
推出 Postgres 专用只读副本
内容提要
PlanetScale 推出 Postgres 专用只读副本,支持异步复制主集群。用户可通过仪表盘、API 或 CLI 创建和管理,并独立配置实例大小与磁盘。该副本可降低全球用户的读取延迟,也能在同一区域内分流向量搜索、分析等查询,避免影响生产。
延伸解读
异步复制的含义与影响
专用只读副本通过异步复制从主集群同步数据,这意味着副本上的数据可能略有延迟,无法保证与主集群实时一致。因此,它适合对延迟不敏感或可接受最终一致性的读取场景,如全球用户读取、向量搜索和分析查询。若应用需要强一致性读取,则不应依赖只读副本。
灵活配置满足多样需求
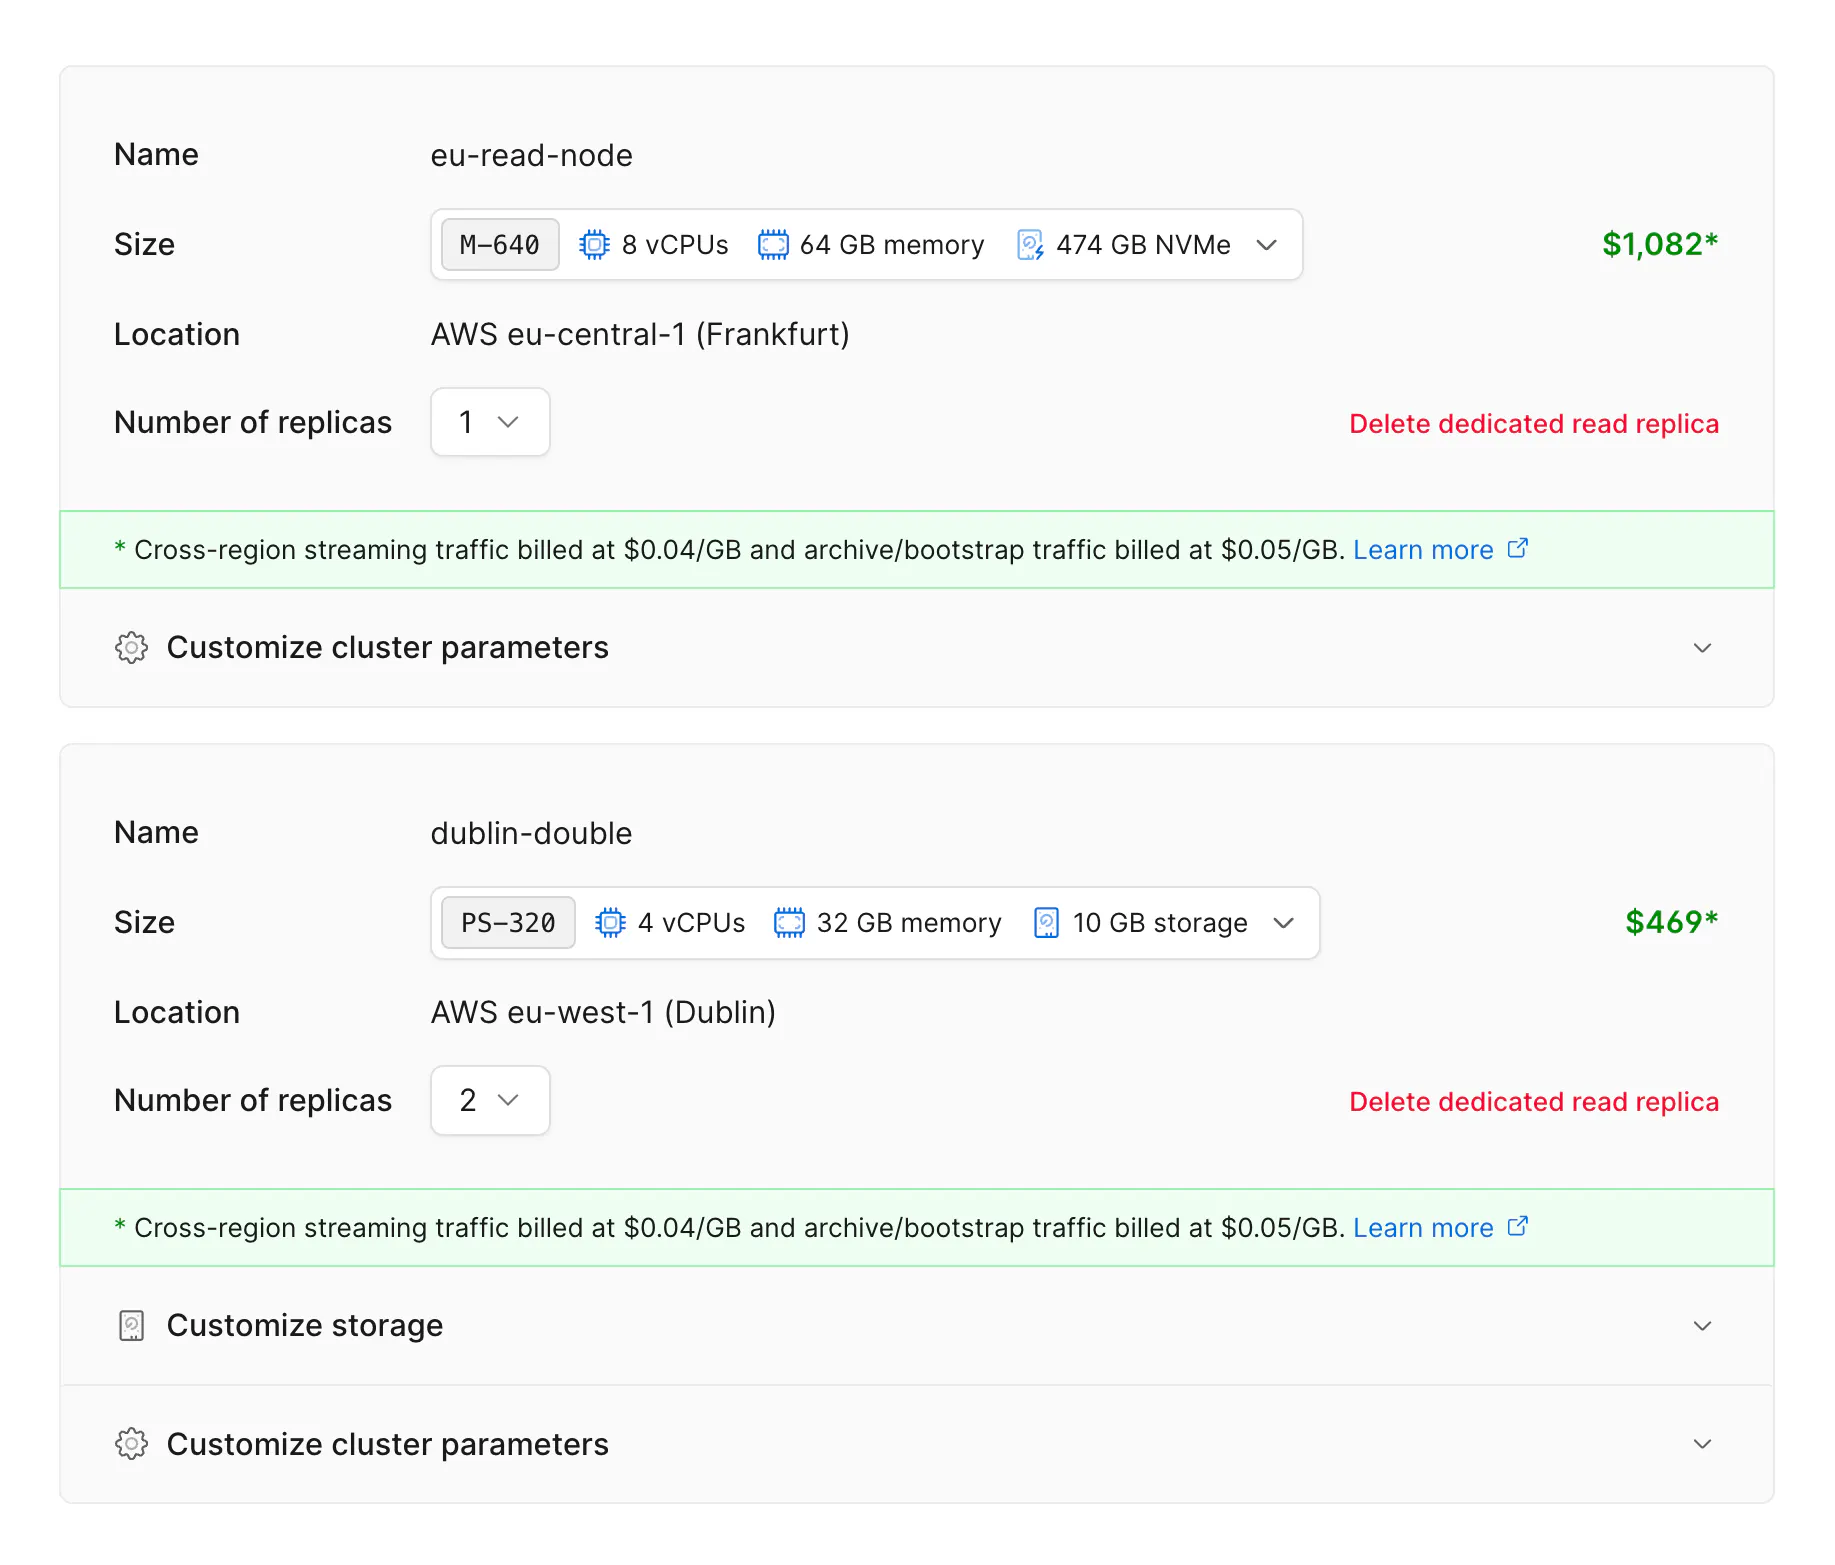
每个只读副本可独立配置实例大小和磁盘特性,例如内存、vCPU、存储类型、IOPS 和吞吐量。用户可以根据不同工作负载(如向量搜索需要大内存,分析查询需要高 IOPS)为每个副本选择合适规格,从而优化性能和成本,而不必与主集群配置绑定。
同区域内分流查询的实用价值
即使不需要全球分布式数据库,只读副本也能在同一云区域内发挥作用。通过为不同副本创建独立的连接凭证,可以将向量搜索、分析等长查询定向到专用副本,避免这些查询影响主集群上的生产 OLTP 流量,从而提升整体稳定性。
Q&A
PlanetScale 的 Postgres 专用只读副本是什么?
专用只读副本是额外的 Postgres 实例,它们从主集群异步复制数据。
专用只读副本如何帮助降低全球用户的读取延迟?
主数据库集群位于一个区域(如 us-east-1),而专用只读副本可以部署在欧洲数据中心(如 eu-west-1 和 eu-central)。欧洲客户的读取流量可以定向到这些节点,从而加快最终用户体验。
我可以在同一个区域内使用专用只读副本吗?
是的,即使不需要全球分布式数据库,专用只读副本在单个云区域内也很有用。你可以在同一区域创建一个或多个专用只读副本,并创建针对它们各自的连接凭证,从而精确控制每个副本的工作。
如何创建和管理 Postgres 专用只读副本?
你可以从 PlanetScale 仪表板的“Clusters”页面、API 或 CLI 创建和管理专用只读副本。
我可以为每个只读副本单独配置实例大小和磁盘吗?
是的,每个副本对 RAM、延迟和性能可能有不同要求。你可以配置每个节点的实例大小和磁盘特性,例如磁盘大小、IOPS 和吞吐量,从而针对每个用例进行调优。
专用只读副本有哪些典型用例?
典型用例包括:降低全球客户的读取延迟;在同一区域内分流特定工作负载,例如使用 pgvector 进行向量搜索,或处理分析和长时间运行的查询,以避免影响生产环境。
