


当 Agent 的记忆变成垃圾场:多轮对话 Agent 的 AgentCore Memory 使用实践
内容提要
文章总结多轮对话Agent使用AgentCore Memory的实践:记忆系统只会放大输入内容。核心做法是用“三过滤测试”界定值得记的信息,实时可查数据不入记忆;写入侧设四道关卡,按回复类型门控、模型自报要点、喂入真实工具轨迹、规则脱敏;跨用户经验用共享actor模式,写入严格匿名化;检索按记忆类型分型触发,namespace锚定actor层。最终实现记忆质量提升与成本下降。
延伸解读
记忆系统的质量取决于输入与读取时机
文章指出,AgentCore Memory 是被动系统,不拦截工具调用,只能处理显式写入的内容。记忆质量等于喂入抽取管道的内容乘以读取时机。因此,治理重点不在记忆服务本身,而在写入前的筛选和检索时的触发规则。这提醒开发者,接入记忆功能前应先定义“什么值得记”,否则垃圾输入会被放大并产生抽取费用。
用三过滤测试界定记忆边界
作者提出三过滤测试:一个月后是否成立、系统能否实时查到、知道后是否会改变回复。实时可查的余额、状态等数据不应入记忆,否则过期快照可能与实时接口冲突。值得记的只有用户稳定信息和任务执行经验。这一口径同时用于模型自报、代码门控和服务端抽取指令,形成多层一致的标准。
写入侧四道关卡与规则优先原则
写入侧设置确定性门控、模型自报要点、喂入真实工具轨迹、规则脱敏四道关卡。回复类型门控和脱敏黑名单用规则保证零方差和可测试;只有“复杂”“意外”等主观状态交给模型自报,并把判断口径改写成可对照检查的事实。episodic 必须包含 TOOL 轨迹,否则服务端只能从回复措辞反推成败,导致经验不可信。
共享 actor 模式与检索分型触发
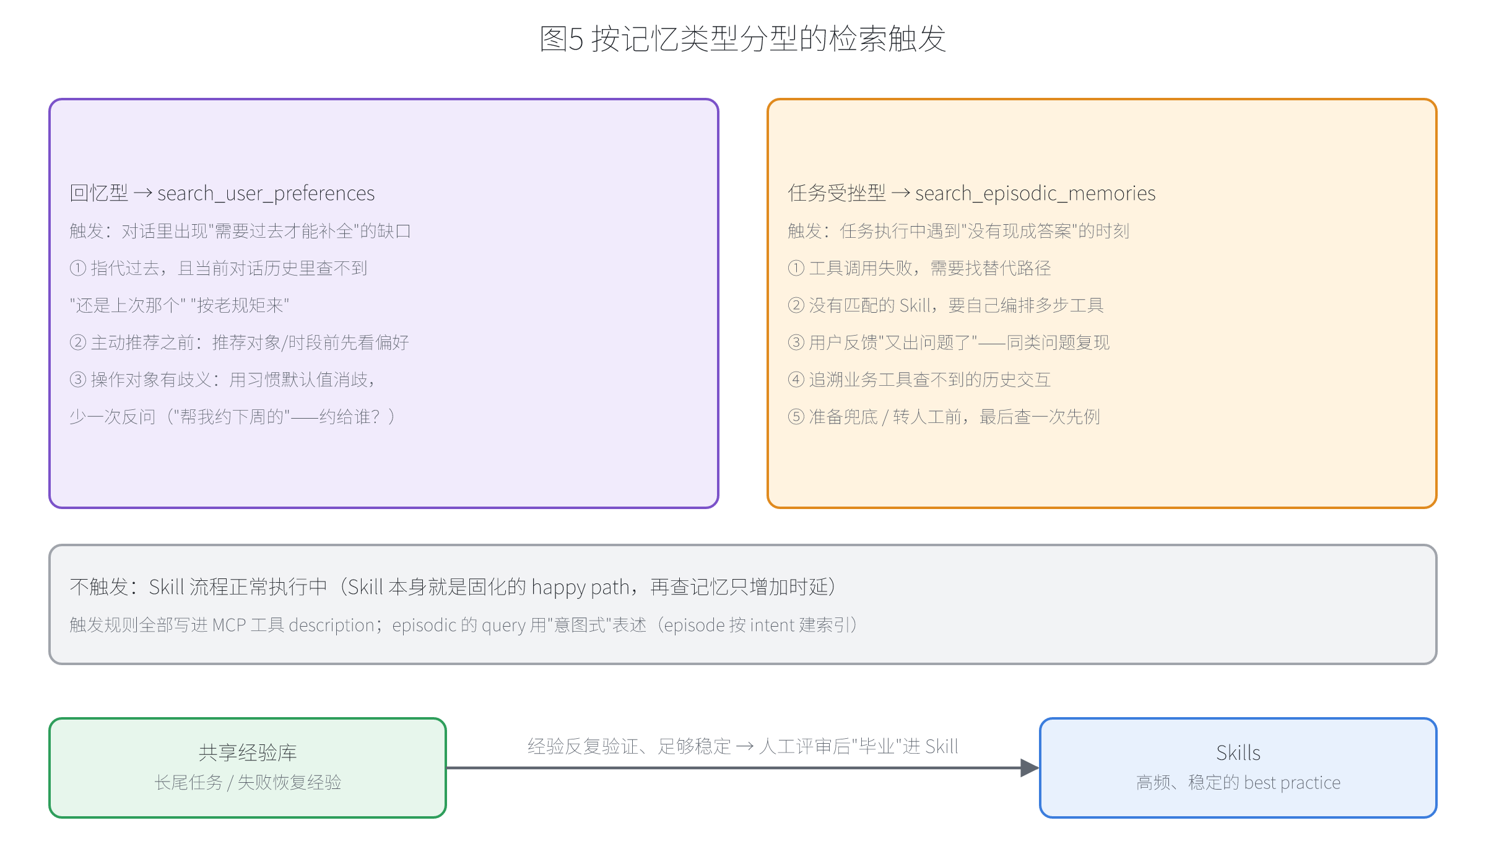
跨用户经验共享采用合成 actorId 的共享 actor 模式,写入前严格匿名化且 fail-closed,避免 PII 落库。检索按记忆类型分型:偏好与事实走回忆型触发,经验走任务受挫型触发,触发条件写入工具 description 而非 Skill。namespace 必须锚定 actor 层,拿不到 strategyId 时宁可读空也不放宽前缀,防止跨租户泄露。
Q&A
AgentCore Memory 是什么?它有哪些核心组件?
AgentCore Memory 是 Amazon Bedrock 的托管记忆服务,由 memoryId 标识的顶层容器,配置短期记忆保留期(3–365 天)。核心组件包括:actor/session(记忆归属和会话来源)、event(短期记忆,原样保存对话,到期清理)、strategy(长期记忆加工规则,每种类型最多一个实例)、namespace(长期记录存放路径,支持占位符)、memory record(策略加工出的结构化记录)。数据流为抽取→整合→反思(仅 episodic)的异步流水线,每步都是 LLM 调用。
多轮对话 Agent 应该记住哪些信息?如何判断一条信息值不值得记?
文章提出“三过滤测试”作为统一口径:1)保质期——一个月后还成立吗?如“活动还剩5天截止”不该记;2)真相源——系统能实时查到吗?能查到就不记,如余额、状态、配额;3)行为改变——下次知道这条会改变回复吗?如“用户上传了一张截图”不该记。值得记的只有两类:用户的稳定信息(时区、沟通语言、偏好对象和时段、长期意向)和任务执行经验(什么调用链成功了、在哪一步失败、后来怎么修正)。
写入 AgentCore Memory 时如何避免垃圾记忆?四道关卡具体是什么?
四道关卡:1)确定性门控——只有正常回复且确认送达的轮次才进入抽取管道,转人工、静默、兜底等不保存;2)模型自报——在结构化结果中增加 memory_note(值得长期记住的用户稳定信息)和 notable_execution(值得作为经验的执行),判断口径要写成可检查的事实(如“未加载 Skill 且自行编排了 ≥2 个业务工具”),而非“难不难”;3)喂入真实工具轨迹——以 TOOL 角色写入工具名、脱敏参数和真实成败,让 episodic 的 assessment 有依据;4)规则脱敏——用键名黑名单(含 id/name/url/token/phone/image/query 的参数丢弃)和值超 60 字符截断,不用模型。
如何实现跨用户经验共享而不泄露隐私?共享 actor 模式怎么用?
合成一个 actorId = shared_experience,将匿名化后的“经验型”轮次(副作用操作、工具失败、notable)额外写一份到共享库,只有 memory_note 的轮次属于个人信息只进个人库。匿名化有方向:写共享库采用 fail-closed(Guardrail 未配置或失败时用占位符替代原文,绝不落库),读个人库采用 fail-open(Guardrail 失败时返回原文,因 namespace 已隔离)。共享库隐私由三层组成:轨迹黑名单 + 写入 fail-closed 匿名化 + 读取 fail-open 兜底。
Agent 应该在什么时候去检索记忆?触发条件怎么设计?
按记忆类型分型触发:偏好与事实走回忆型触发(search_user_preferences),适用于指代过去而当前对话查不到、主动推荐之前、操作对象有歧义时用习惯默认值消歧。经验走任务受挫型触发(search_episodic_memories),五个时机:①业务工具调用失败或结果不符预期;②当前任务没有对应 Skill 流程;③用户反馈问题复现;④追问过去的非实时事项且业务工具查不到;⑤准备以兜底回复收尾之前。不要调用:Skill 流程正常执行中、纯查询、FAQ、简短确认。query 写法用“任务类型 + 遇到的问题”的意图式描述。
AgentCore Memory 的 namespace 如何设计才能既隔离又共享?
写入侧 namespace 由策略配置模板生成,建库时一次定型,支持 {memoryStrategyId}、{actorId}、{sessionId} 占位符。episode 总是从单个 session 产生;reflection 的 namespace 必须与 episode 同一模式但可以更浅——写到 actor 层就只在同一 actor 的 episode 之间归纳,写到 strategy 层才会跨 actor 归纳(需考虑隐私影响)。读取侧 RetrieveMemoryRecords 支持 namespace 精确匹配和 namespacePath 前缀匹配:前缀锚定到 /strategies/{id}/actors/{actorId} 可跨 session 读同一用户全部记录;只到 /strategies/{id} 会读到所有用户数据。检索时 strategyId 从 GetMemory 动态读取,拿不到时宁可读空,绝不退回宽前缀。
AgentCore Memory 的四种策略分别产出什么?各自适合什么场景?
SEMANTIC 产出事实型陈述,用于用户画像、领域知识;USER_PREFERENCE 产出偏好型陈述,用于个性化推荐、默认值消歧;SUMMARY 产出会话摘要,用于长会话压缩;EPISODIC 产出 episode(situation/intent/assessment/justification/reflection)及跨 episode 归纳的经验法则,用于任务经验、失败恢复。每种策略有三种使用形态:内置(全托管)、内置+override(用 appendToPrompt 追加业务指令,可换模型)、自管(服务端触发并投递到 S3/SNS,加工后用 BatchCreateMemoryRecords 写回)。
IngestData 和 CreateEvent 有什么区别?工程上要注意什么?
CreateEvent 先存短期 event 再异步抽取,可用 extractionMode=SKIP 跳过抽取;IngestData 不存短期 event,直接进入长期抽取。文章因对话原文已由业务侧保存、raw event 从未读回,选择了 IngestData。两个坑:Runtime 执行角色要显式授权 bedrock-agentcore:IngestData,否则会静默回退;需要 botocore ≥ 1.43.98,boto3 和 botocore 要一起锁版本。另外保存必须 await 完成(同步 boto3 调用放进 asyncio.to_thread),不能 fire-and-forget,且 interrupt 前要主动保存(Stop hook 不会派发)。
