Databricks推出自主AI同事Genie,可在用户设定的护栏内主动跟进并持续执行长期企业任务。其依赖Genie Ontology提供业务上下文,Genie Search跨湖仓与业务系统检索,Unity Gateway管控工具访问、审计与成本。Genie支持邮件、Slack、Teams等渠道,可生成幻灯片、仪表板等成品,并通过MCP连接外部工具。基准测试中正确率达91%,为最强前沿智能体的1.6倍,token用量不到一半。
Databricks与Turing合作开发企业数据智能体基准,在真实Databricks工作区对比Genie与两个前沿智能体。Genie借助Genie Ontology理解企业业务知识,正确率达91%,另两者仅45%和58%;速度分别快4倍和3倍,token用量不到一半。该基准包含笔记本、仪表板、SQL查询等企业知识资产,更贴近真实场景,表明上下文对企业数据智能体至关重要。
Fable 5.2发布后引发实测热潮:有人用约2.5万个Agent生成450多个3D世界,有人将达·芬奇手稿转为可交互3D模型。该模型在编程、科研等基准测试中超越Opus 5.5,输出更快、价格降低20%。网友还用它制作地球游戏地图、3D竞技游戏、赛博海底游戏、钢琴奏鸣曲、AI纪录片和产品宣传片等。但也有用户反映Token消耗快、部分任务提升有限且价格偏高。
文章对比了本地Scikit-Ollama与云端Groq支持的Scikit-LLM零样本情感分类基准,用统一辅助函数测量耗时与准确率。本地Llama3耗时80.71秒、准确率80%,成本为零且隐私性强;云端gpt-oss-20b仅2.02秒、准确率100%,免费层零成本、部署更简单。结论:本地受GPU显存与生成速度限制,云端延迟低、配置少,但本地数据完全不出机器。
文章探讨基于LMDB的零拷贝SQL计算:利用LMDB只读事务中页地址稳定、大值连续存储的特性,让字符串以“指针+长度”形式从存储一路借用到查询结果,避免SQLite中取列和映射结构体时的两次拷贝。基准测试显示,LMDB SQL分配量与数据大小无关,长字符串及多重物化算子下优势明显,短数据则与SQLite相当。
Klavis AI 论文提出 Multi-step SWE 基准,用 69 个任务、574 步连续改动测试编程智能体能否在自身代码上持续开发。最强模型 Claude Opus 5.5 单步通过率 56.8%,但整任务解决率仅 18.5%,Pass@4 为 31.9%,其余 8 款模型均不超 17.8%。错误从第一步起累积,多数失败源于方向走错而非算力不足。局限包括验证器误判、能力与脚手架未分离,且题目偏底层语言,结论不宜外推为通用编程能力。
Discord宣布客户端全面改用Rust,移除Electron和React Native,桌面与移动端共享Rust代码,界面采用GPUI,但社区指出其系统集成与无障碍功能仍不足。rustc十一月性能月记介绍span压缩等优化,增量编译改进显著,平均墙钟时间降低2.85%。systemd合并可选Rust支持,仅限叶子组件,默认auto。benchfmt.rs对接Go benchstat,基准显示Rust解码更快,但堆内存占用更高。
11月5日,百度开源基座模型文心5.5 Flash Base,采用MoE架构,总参数2800亿,每Token激活140亿,预训练使用33.5万亿Token,支持最长100万Token上下文,多项基准达同尺寸SOTA。模型围绕效率优化:提出Latent-Gated Sparse Attention降低长上下文开销,Multi-Router Latent MoE改善专家路由,ECHO复用主干末层提升推理与代码能力,并优化分布式Muon优化器与FlashMask-4算子。
OpenAI发布GPT-6.1 Terra,称其在科学编程和电脑操作任务上接近Opus 5.5且成本更低。作者自建三项测试:发布分诊两者打平;细胞追踪Terra得分更高;大表格任务Terra完成而Opus因超输出上限未作答。Terra总成本约为Opus的12%,耗时更短,但大表格数值仍有错误,结果不具可重复性。
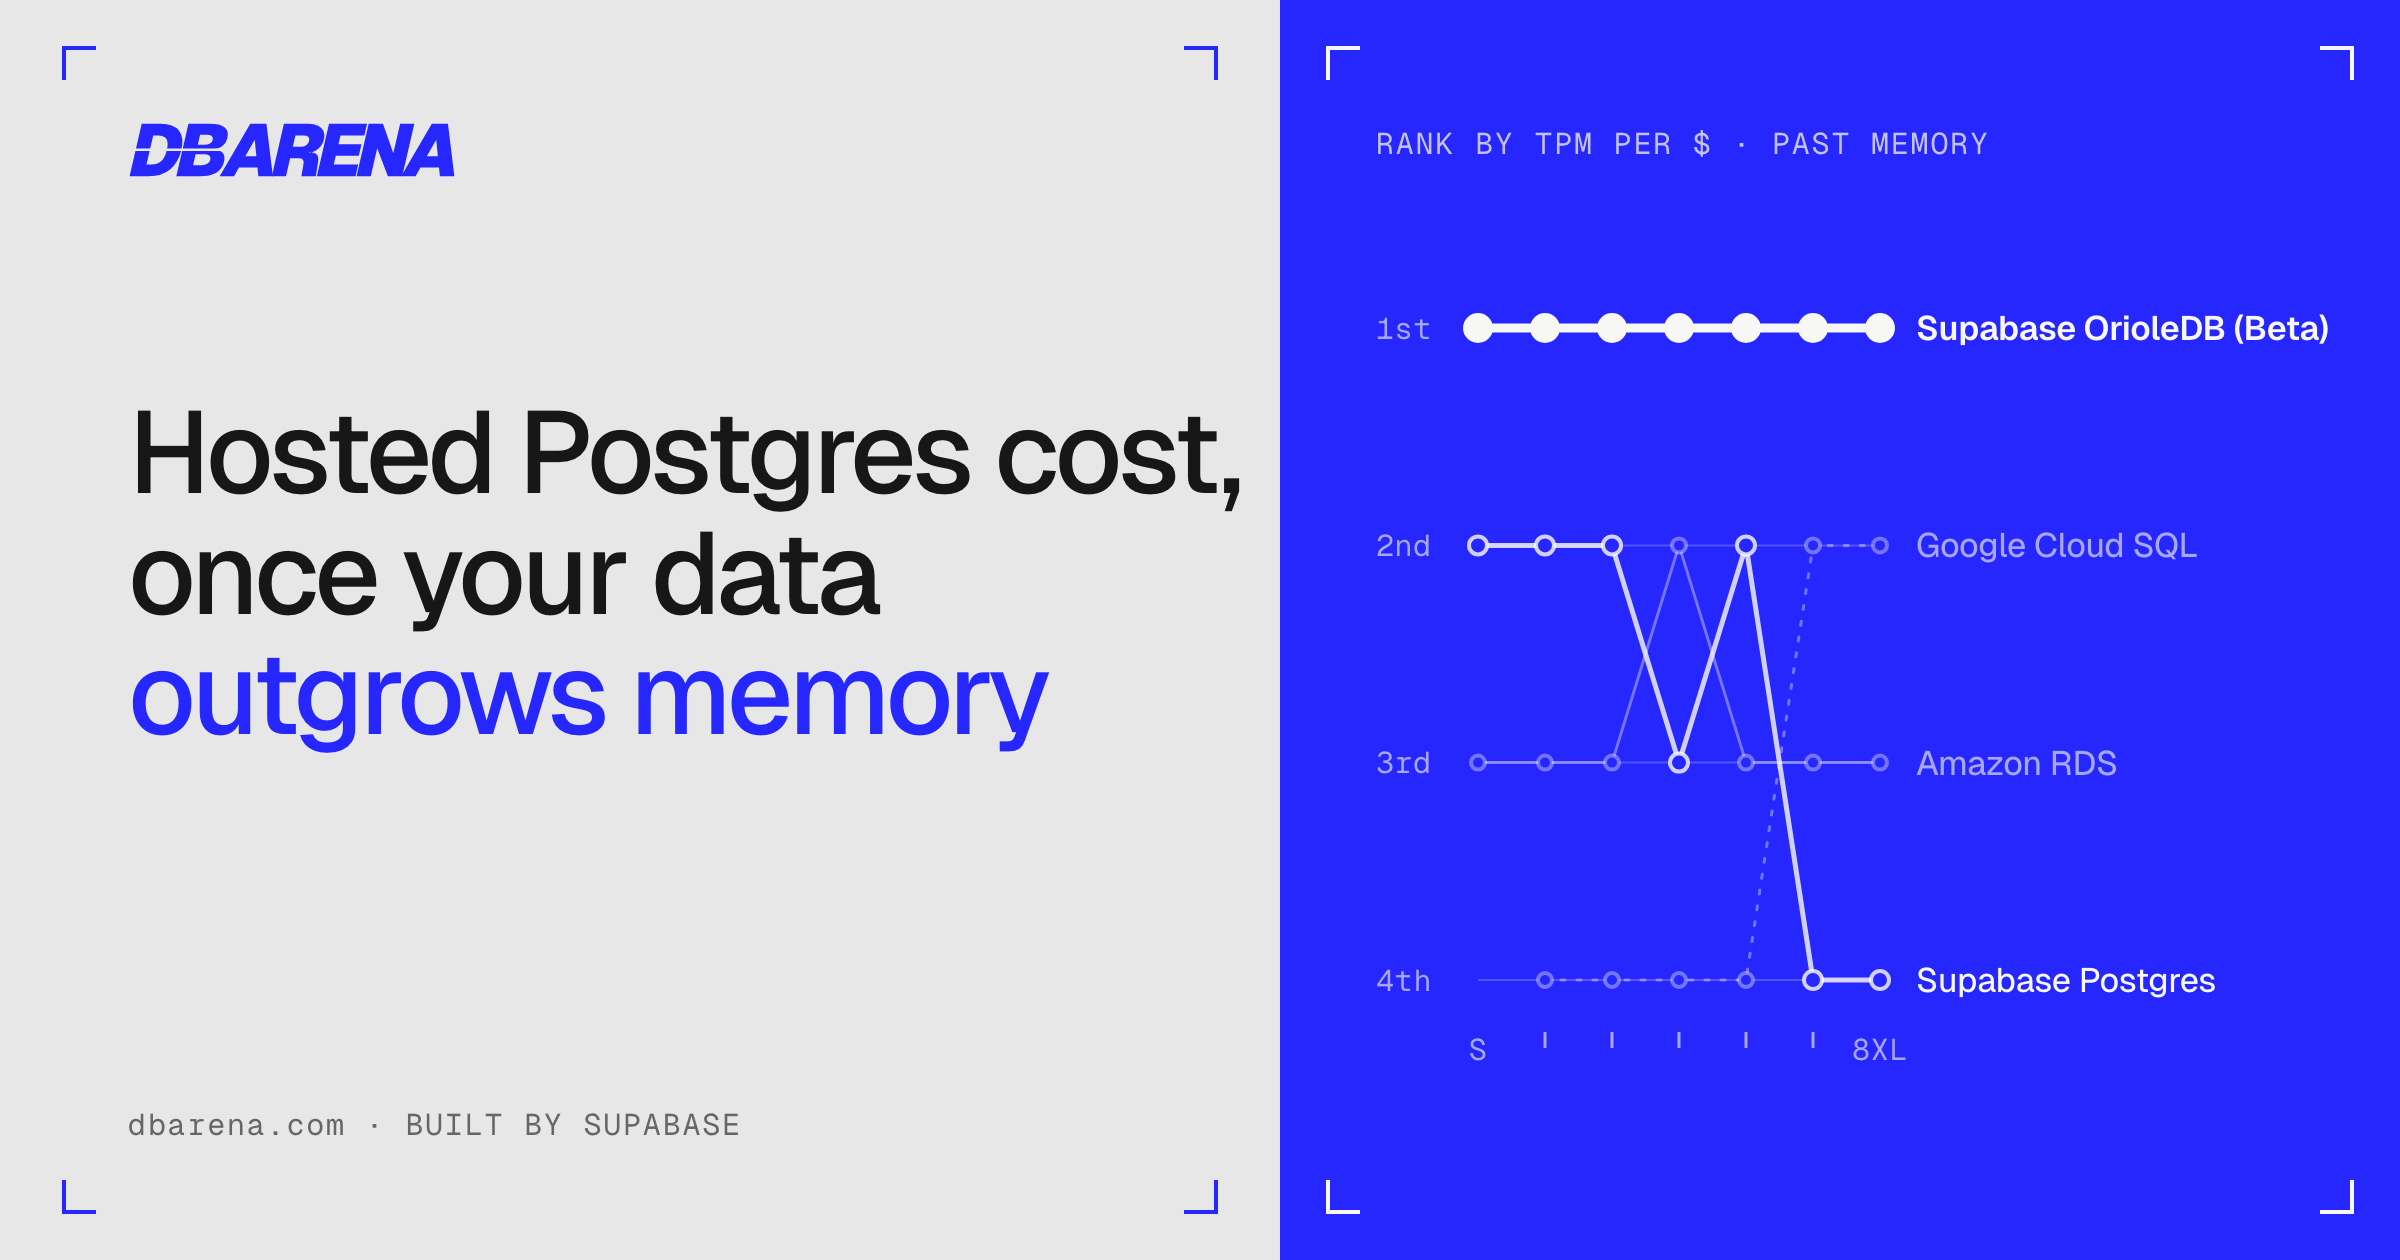
DBArena发布托管Postgres基准测试,首批对比Supabase(默认存储及OrioleDB)、Amazon RDS和Google Cloud SQL,覆盖最多七种计算规格,测量吞吐量、性价比和p95延迟。测试按vCPU匹配、使用默认配置,基于TPC-C工作负载,涵盖缓存命中与超内存两种场景。方法公开、工具开源,每个结果附原始数据可复现;首批62项结果来自750多次运行。局限包括单一工作负载、无思考时间、仅单区域及按标价计费。
本文介绍在无运行服务器的情况下,从InnoDB、MyISAM和MyRocks文件中提取数据的MySQL数据恢复技术。
谷歌发布新模型Gemini 4 Carbon,在编程、智能体任务和网络安全方面显著提升,在Artificial Analysis智能指数等基准上领先Claude Opus 5.5和GPT-6 Astra,并在漏洞发现与利用测试中排名第一。该模型擅长长时间多步骤任务,能抵抗提示注入,减少无依据说法。目前仅向部分网络安全公司开放,定价与Argon相同。
作者在ARM64架构的GB10(sm_121)上测试Strata 0.2.7.1。新版本提供官方ARM64预编译包并默认启用四项优化。基准测试显示预填充明显加速,4K提示延迟降低近20%,符合官方约1.2倍的说法,但短解码略慢。作者用ABBA方式单独开关STRATA_SPEC_COST,发现进程间自然波动(约200–300毫秒)大于该开关影响且方向会反转,因此解码变慢不能归因于它,避免了错误上报。
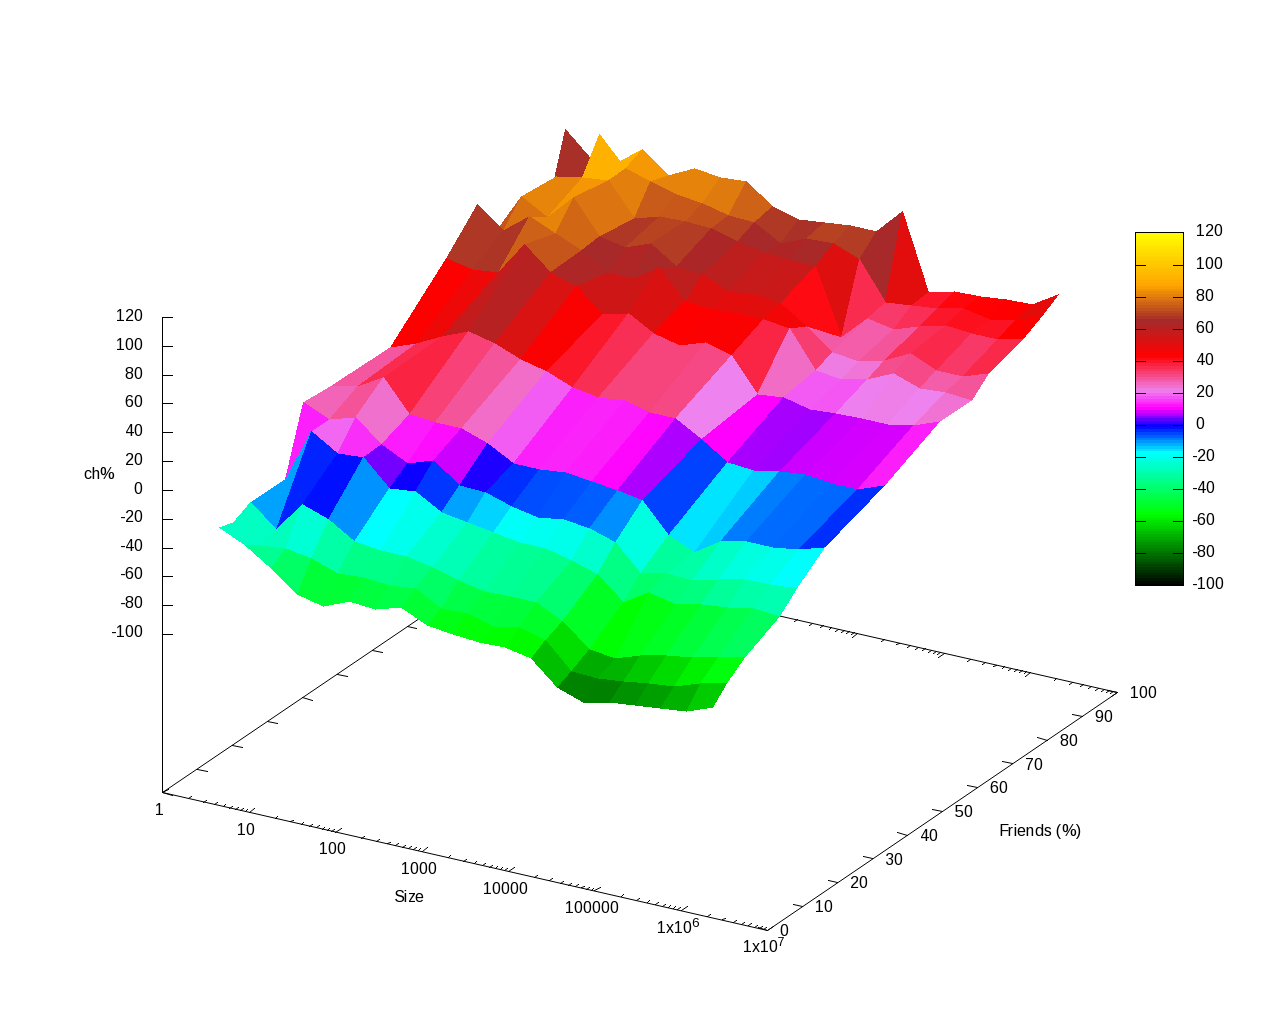
文章比较了在Perl中按@order顺序排列@friends的两种方法:一是用哈希记录位置后排序;二是用哈希标记好友,再遍历@order筛选。基准测试显示,好友比例小时第二种更快,好友接近全部时第一种更快。
Databricks 用同一 AI 代理对 528 个数据管道进行基准测试,比较过程式 PySpark 与声明式 Spark Declarative Pipelines。结果显示:声明式可在运行前预检结构错误,集群计算时间减少约 34 倍;代码量约为过程式一半(中位数 64 行对 131 行),且更一致;但两者对逻辑错误的检出率相近。声明式前期 LLM 令牌成本约高 2.3 倍(约 0.50 美元对 0.26 美元),但令牌成本固定,而集群浪费随数据规模增长,故生产规模下声明式更划算。
谷歌推出前沿模型Gemini 4 Argon,擅长编程、金融、法律、网络安全和科学等领域的复杂多步骤任务,在多项基准测试中领先。社区开发者基于该模型打造了五个项目:3D水上飞机模拟、实时野火与地震波3D地球、交互式涡扇喷气发动机、由单张图片生成的3D马车,以及多人夺旗网页游戏。该模型已通过API及多个谷歌平台向开发者和订阅用户开放。
文章基于1000万行数据实测PostgreSQL 18各类索引:B-tree为默认首选,等值查询约0.11毫秒;哈希索引无优势且体积大3倍;BRIN仅72 KiB,适合时间有序大表,但慢约3倍;部分索引只含0.85%的行,体积小160倍且速度相当;覆盖索引快1.4倍但大4.4倍,且UPDATE后失效;GIN适合数组、jsonb和全文检索,匹配稀少时快129倍;GiST/SP-GiST用于几何与范围查询。每增加一个索引都会拖慢写入,应据查询选型并清理未用索引。
Letta发布FrontierMemory基准,用于测试AI智能体能否从过往经验中学习并提升后续任务表现,而非仅检索记忆。结果显示智能体框架影响显著:Letta Dream以73.3%居首,Prime Agent为60%,OpenAI Agents SDK为40%,Claude与Hermes更低。在模型生成记忆能力上,Claude Opus 5.5与GLM-5.3并列第一,但GPT-6.1 Sol成本更低。该基准目前仅含15项任务,后续将加入更长任务与在线记忆更新。
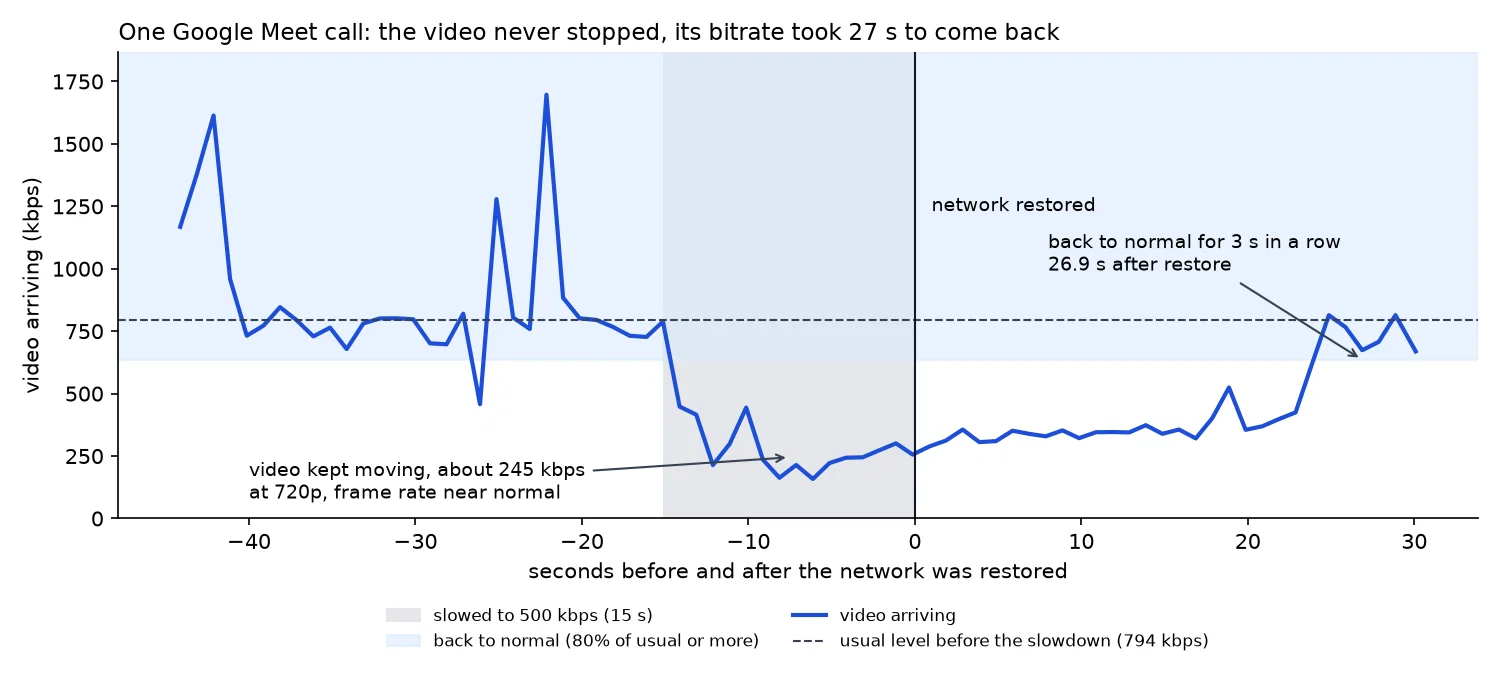
WebRTC基准测试须先验证限速是否真实生效:Chrome内置限速未附着于通话连接,导致Meet视频绕过限制;Zoom Web视频经数据通道传输,标准统计中无帧率数据。测试显示Meet媒体未中断,但码率稳定常超20秒,或30秒内未恢复;Zoom因限速前码率已低于500kbps,多数接收端未真正受扰。建议将“稳定恢复”纳入验收标准,区分通话运行、遥测完整与质量恢复,缺失数据不得记为零。
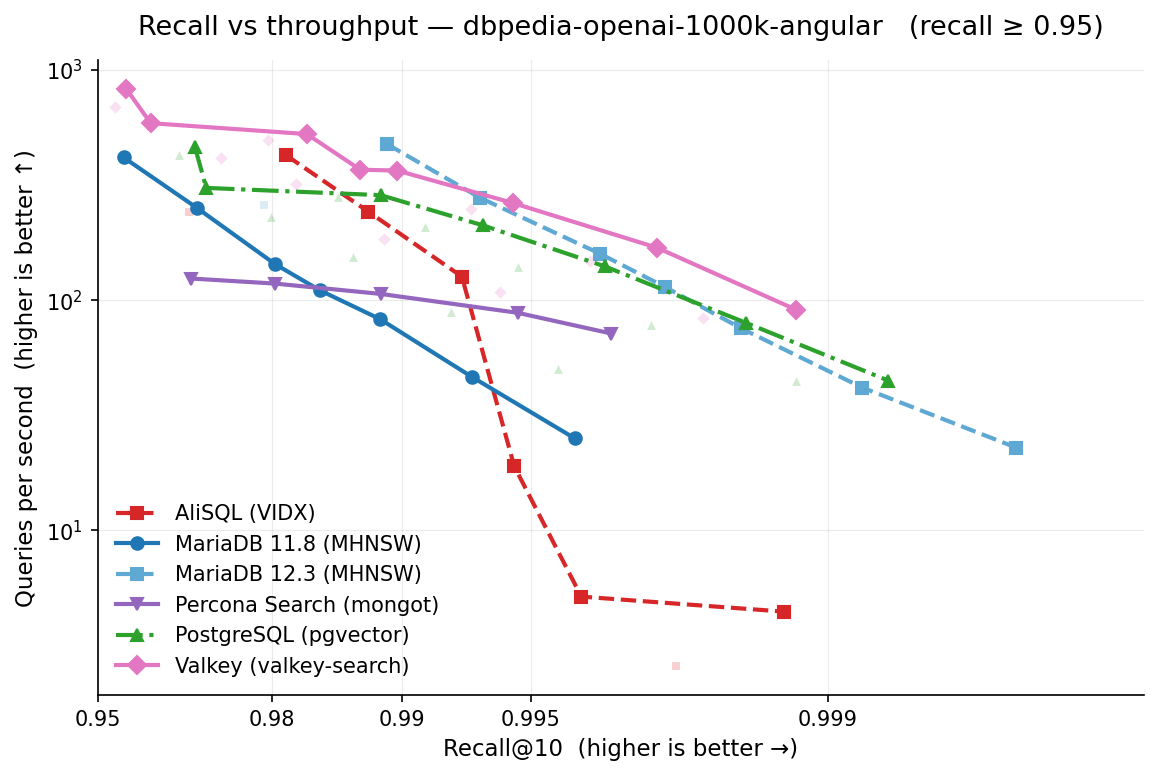
文章比较了pgvector与专用向量数据库。pgvector是Postgres扩展,可在同一数据库内同时存储向量与关系数据,支持多种向量类型和距离函数。作者用Docker在本地对pgvector和Qdrant做基准测试,但10万向量的规模太小,难以得出结论。文章引用Tiger Data的5000万向量生产级测试:在99%召回率下,pgvector配合pgvectorscale吞吐达471 QPS,远超Qdrant的41 QPS;但Qdrant尾延迟更优,p99为38.71ms对74.60ms,索引构建也快约3.4倍。结论:千万级以下、需要事务一致性的场景选pgvector;超大规模、严格尾延迟SLA或零运维需求的场景选专用数据库。
完成下面两步后,将自动完成登录并继续当前操作。