大语言模型将“氛围编程”从软件延伸到硬件,用户只需向Claude Code等工具输入提示,即可改造电视、相机、合成器和游戏机。安卓设备最易操作,ESP32模块成为低成本实验平台。厂商开始加强DRM和法律保护,用户则面临保修失效、设备变砖等风险。
文章介绍从零手写大语言模型训练脚本,将预训练与全参数SFT合为一体,复用MiniMind的tokenizer和chat_template。脚本涵盖设备与随机种子初始化、数据集构建、梯度累积、AdamW参数更新、余弦学习率衰减、梯度裁剪与混合精度,并实现RMSNorm、RoPE、GQA注意力、MoE前馈层及负载均衡辅助损失,支持检查点续训与权重导出。
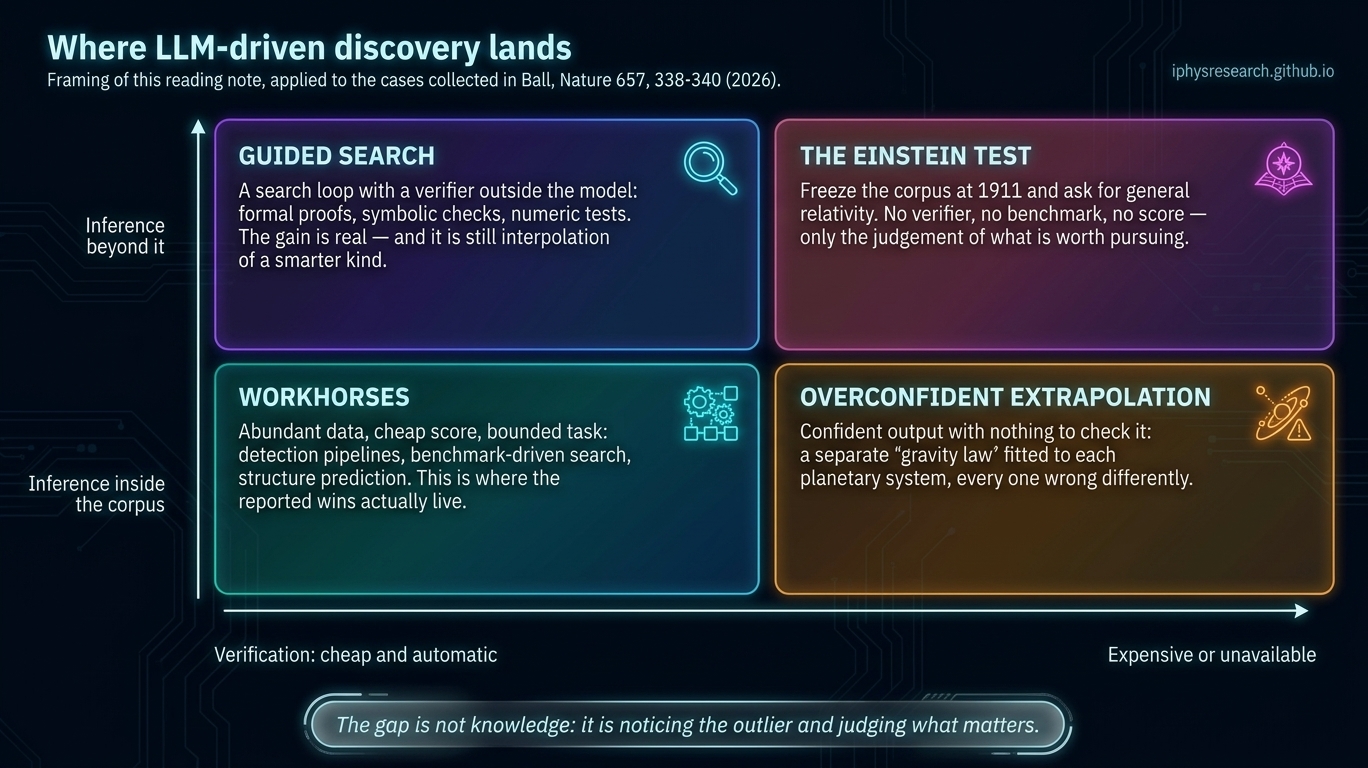
Philip Ball在《自然》综述中指出,“爱因斯坦测试”类实验(用截止某年数据训练模型,检验其能否重推相对论)结果几乎全为负面。核心限制在于LLM缺乏溯因推理,只能归纳;虽能生成大量理论,却无法判断哪个正确或重要,且倾向平均掉关键“离群值”。作者认为应明确LLM边界,目标应是融合物理世界与数学结构的“数理世界模型”。
MIT与丹娜—法伯癌症研究所团队用大语言模型审查近4000篇临床预测模型研究及相关代码库,发现两大缺口:共享代码仍不普遍(约八分之一研究报告共享),且公开代码未必附带可复用的文档与支持信息。共享做法在期刊和国家间差异很大,部分期刊虽有政策但共享率仍低。研究还发现合成数据集等良好实践,成果正用于制定TRIPOD-Code报告指南,明确应共享哪些代码要素。
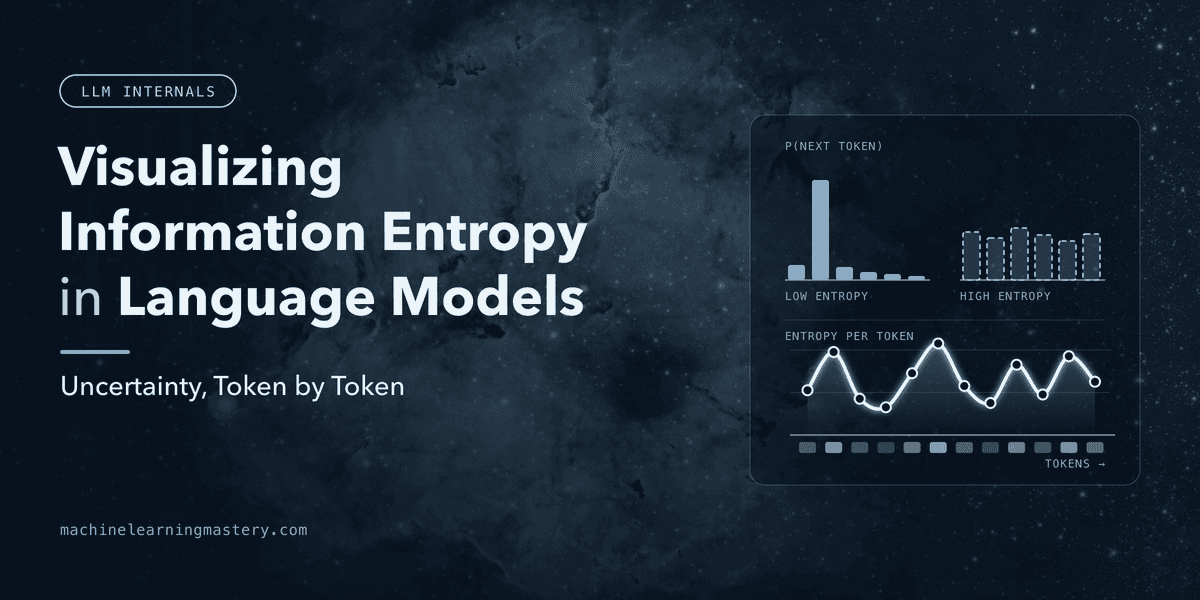
文章阐述信息熵与交叉熵损失如何连接信息论与大语言模型训练:熵衡量概率分布的不确定性,分布越均匀熵越高,越集中熵越低;大语言模型逐词预测下一词,训练时以交叉熵损失比较模型预测分布与真实目标分布,最小化该损失即促使模型对正确词更有信心。文中用含五个词的词表及三种模型预测(自信且正确、自信但错误、完全不确定)在Python中计算并可视化熵与交叉熵,说明训练同时降低不确定性与错误预测。
论文提出PIPETTE框架,用于大语言模型智能体的提示注入紫队测试。作者指出,RL-Hammer和PISmith等强化学习红队方法存在模式崩溃,攻击成功率虽高,却无法提升对抗训练带来的鲁棒性。PIPETTE采用基于字典学习的奖励以扩大攻击策略覆盖,并结合面向间接提示注入防御的在线对抗训练。在AgentDojo和ASB基准上,防御后静态攻击成功率接近零,能抵御强自适应攻击,且正常任务效用接近未防御基线。
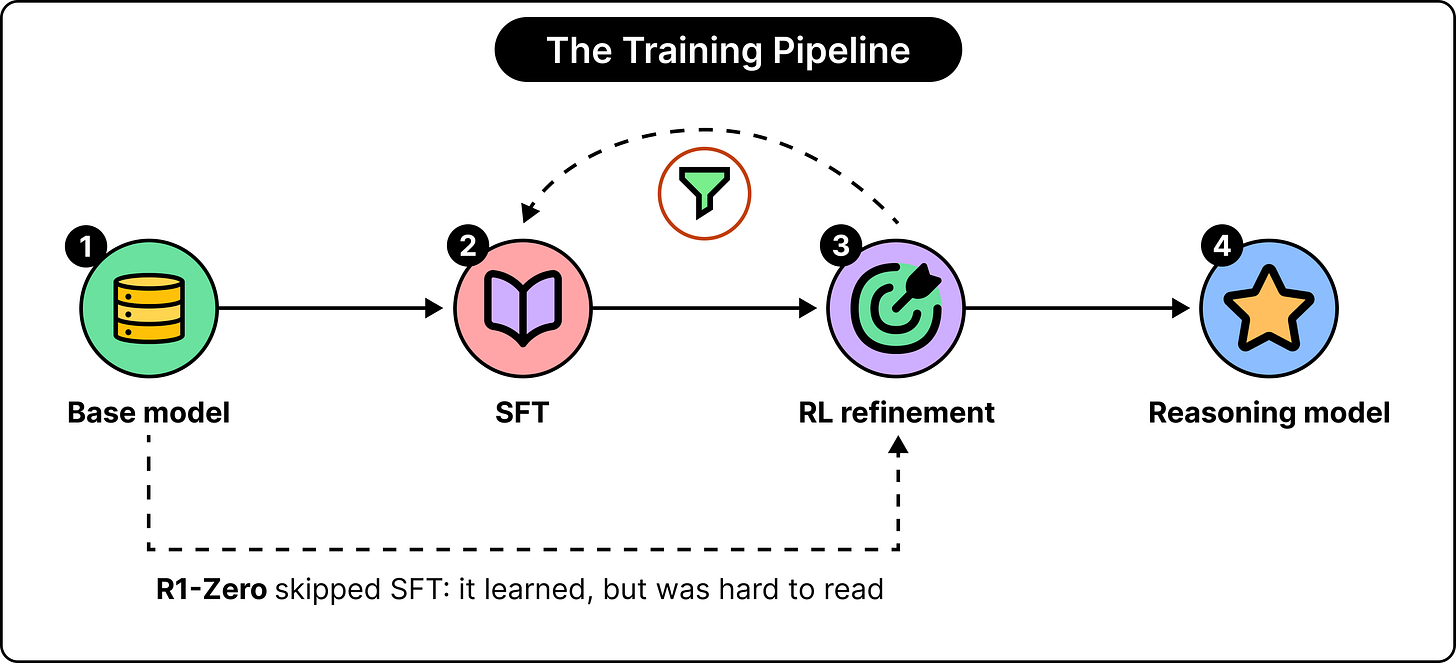
文章探讨推理型大模型“想得越多反而越笨”的现象:模型逐词生成,早期内容会影响后续推理,多步思考既能纠错,也可能带偏正确直觉。DeepSeek用强化学习训练模型回溯检查,但题目简单时模型仍会反复验证、引入无关假设,把正确答案改错。因此何时停止思考是独立能力,额外推理对难题有益,对简单题可能有害。
MIT副教授Jacob Andreas研究语言学习的计算基础,致力于让AI模型用人类可理解的语言解释自身内部运作,而非依赖外部工具“读心”。他关注大语言模型的算法机制与训练方法,开发可解释性技术,为神经网络节点赋予自然语言描述并预测模型行为。他认为AI领域变化极快,学生需深入理解底层原理;未来希望提升AI智能体的安全性,助其表达科学数据中的隐含知识。
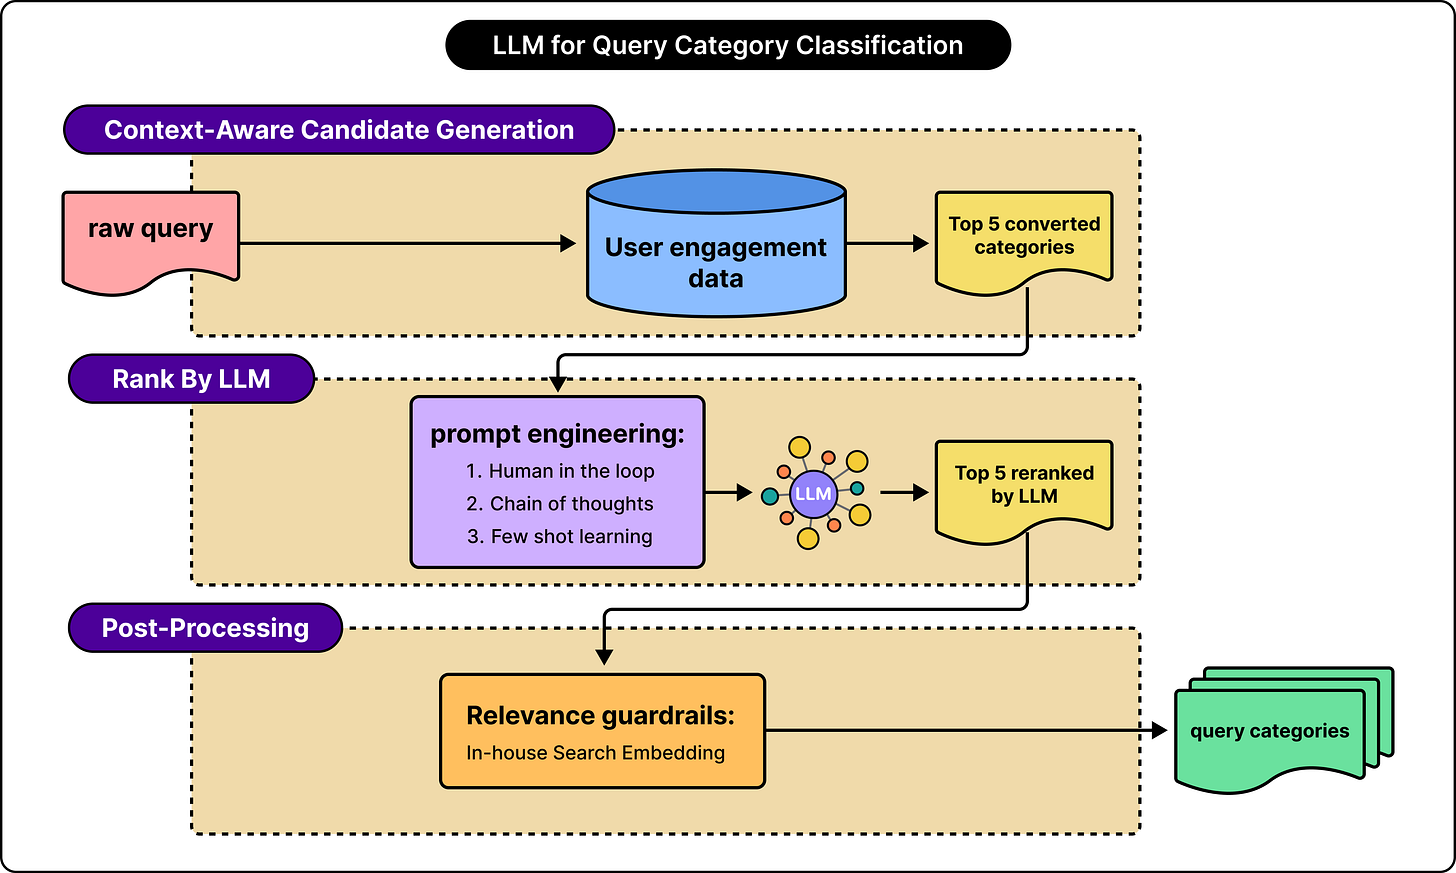
Instacart 利用大语言模型改进电商搜索的查询理解。旧系统依赖点击购买数据训练,存在标签噪声大、长尾查询覆盖不足、多模型维护成本高的问题。新方案结合历史购买候选、LLM 重排类目路径与嵌入相似度校验来提升类目识别;查询改写分为同义、放宽、替代三类,覆盖率从 50% 提升至 95% 以上;结构化标签采用离线大模型生成高质量样本,蒸馏微调 Llama-3 8B 用于实时推理,并缓存高频查询。经 LoRA 合并、H100 升级和缓存优化,延迟降至约 300 毫秒。A/B 测试显示长尾查询滚动深度下降 6%,投诉减半。
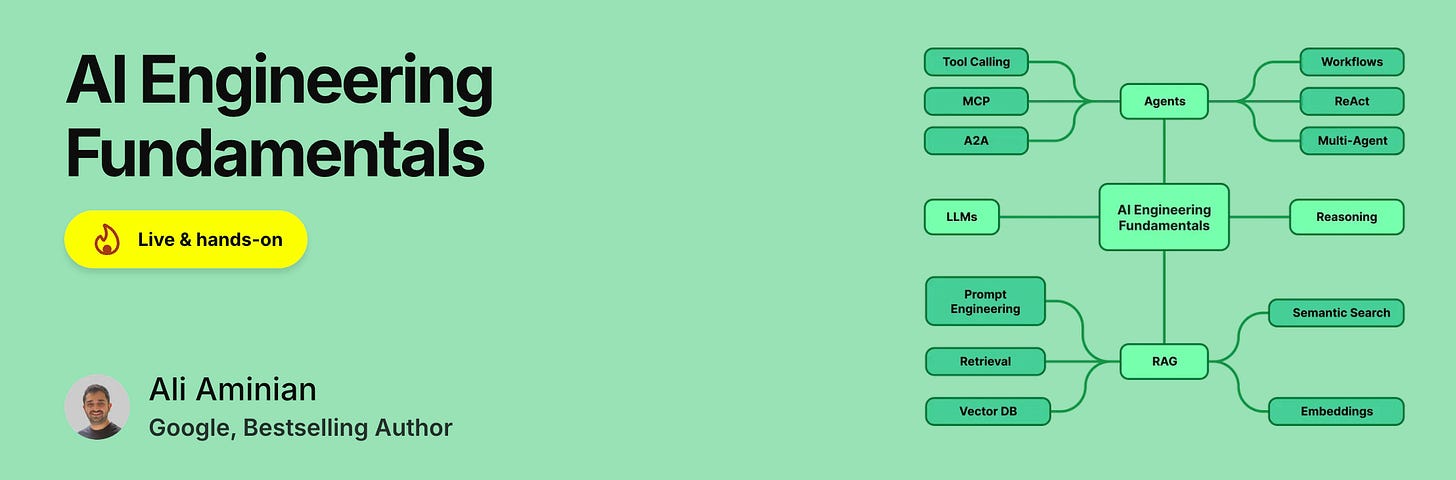
ByteByteGo推出AI工程基础课程,由谷歌工程师Ali Aminian主讲,11月16日开课,报名24小时内截止。课程涵盖大语言模型理解与选型、RAG检索生成流程构建、可使用工具并完成多步任务的AI智能体创建,以及推理模型与高级提示技巧应用,四周内完成四个实战项目。
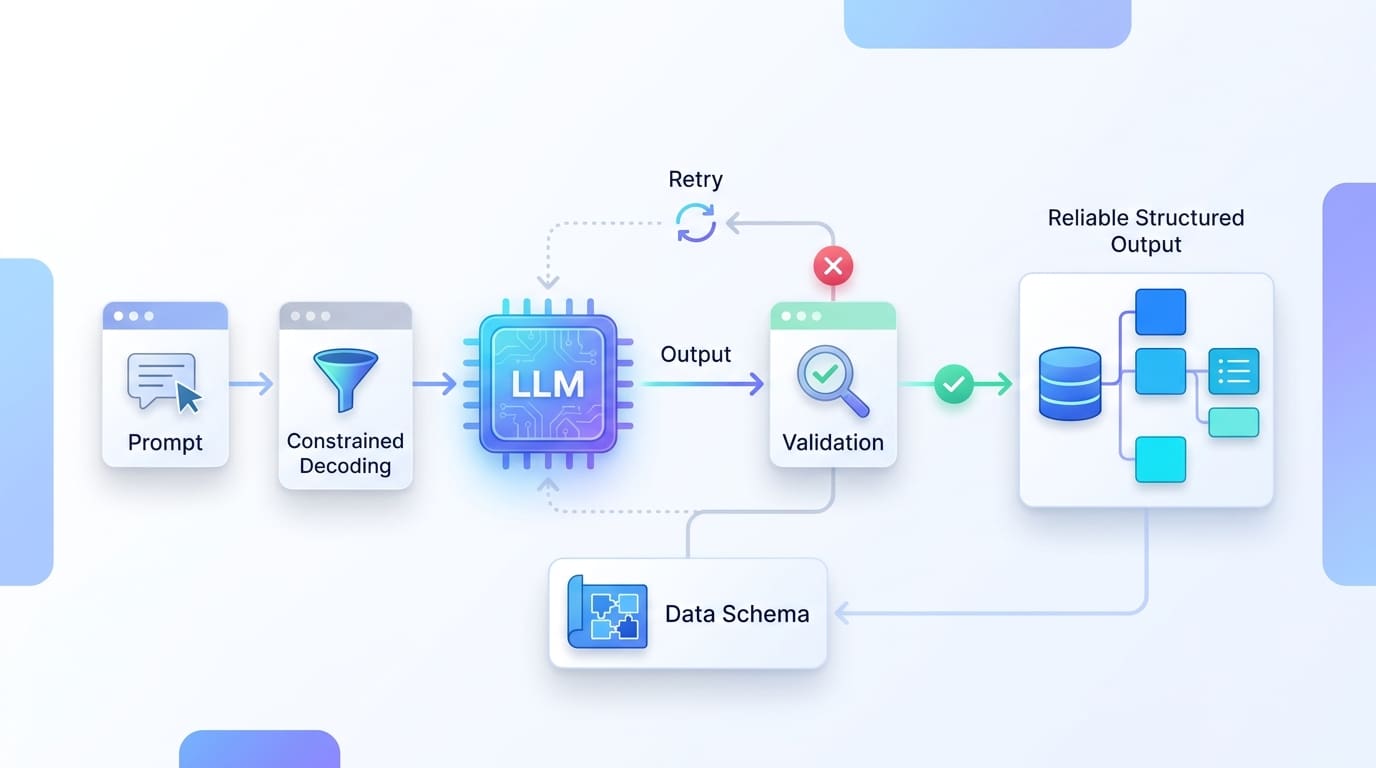
文章指出,仅靠JSON解析或模式校验不足以保证LLM结构化输出正确,例如发票金额12500与原文1250.00不符。应建立三层防护:用严格Pydantic契约校验形状;对照源文本检查引用、币种和金额一致性;仅在形状错误时有限重试(最多三次),并关闭SDK隐藏重试。优先使用约束解码减少格式错误,但保留源校验。结果分为接受、需人工复核、拒绝和形状错误,只有接受结果进入下游。
Meta推出“Your Algorithm”系统,允许Facebook用户用自然语言直接说明想看或不想看的内容,偏好同时作用于Feed和Reels。系统利用多个大语言模型生成兴趣档案、校验并丰富用户修改,再通过检索、排序、重排和设备端缓存失效等环节落实偏好,兼顾响应速度与内容平衡。
该论文评估大语言模型作为评判者评估个性化写作风格的能力:用四个模型完成三项长文写作任务,收集人类偏好标注并与模型评判对比。结果显示,评判质量与MMLU通用能力仅弱相关(ρ≤0.2),且随任务和标准变化;成对比较比独立打分更一致有效;最强模型未必最贴合人类判断,可能因对细节过度敏感。
文章探讨大语言模型对PostgreSQL社区的影响。作者通过邮件列表数据发现:pgsql-bugs的新缺陷报告自2025年中明显增加,pgsql-general邮件量大幅下降,IRC、Slack和Discord讨论也显著减少。作者认为LLM既帮助更多人发现缺陷,也取代了向社区提问;explain.depesz.com访问量下降,反映人们更依赖机器优化查询而非自行阅读执行计划。
MIT与纽约大学团队开发FLEX系统,使机器人能通过自然语言指令理解隐含意图。系统分三步:添加用户提及的物体、用大语言模型泛化出更高层规则(如避开所有易碎或电子物品)、移除已不在环境中的物体。在咖啡、蜡烛、保龄球等模拟任务中,机器人能举一反三,无需用户逐条说明规则。
文章探讨机器是否具备意识。作者指出“计算功能主义”认为意识可由计算实现,但这过度简化:人脑大量计算与意识无关,大语言模型的“智能”也不等于意识,人们因拟人化而误判。作者强调意识是人类特质,机器并不理解。
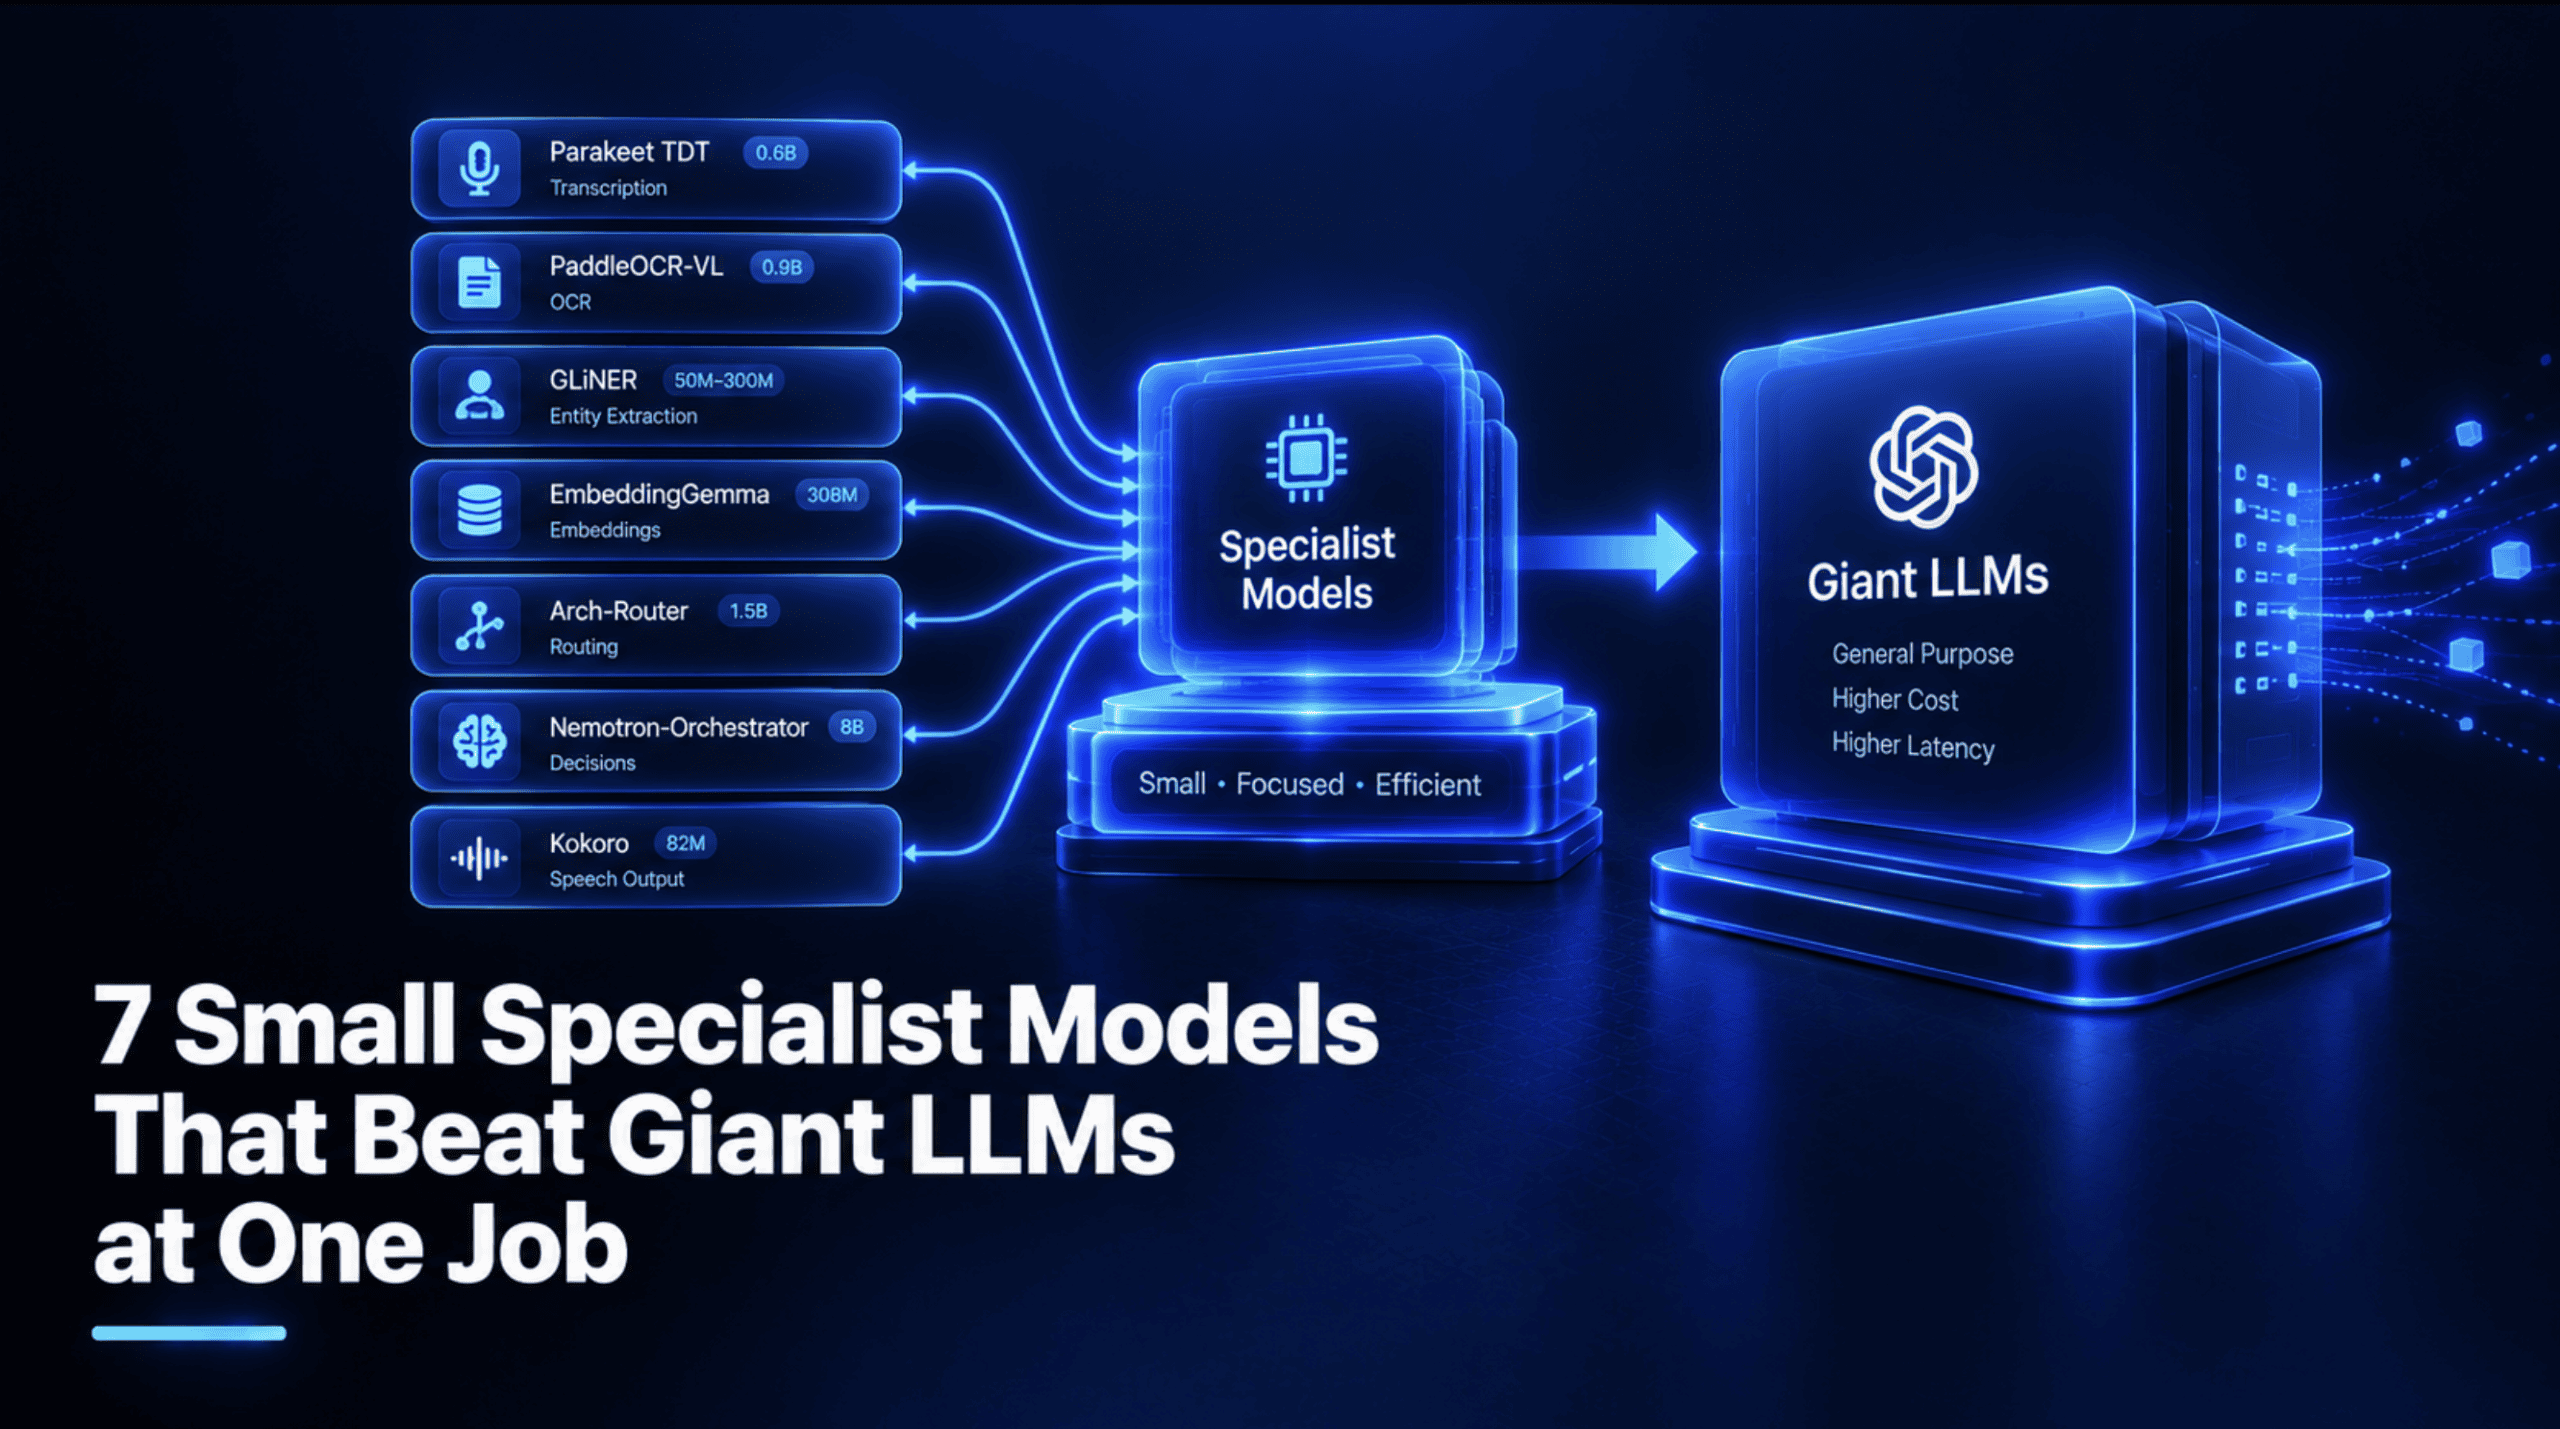
文章介绍七个参数量均低于100亿的开源专用小模型,可分别替代大模型完成单一任务:Parakeet转写、PaddleOCR-VL文字识别、GLiNER实体抽取、EmbeddingGemma向量嵌入、Arch-Router路由、Nemotron-Orchestrator决策、Kokoro语音合成。文中给出各模型的规模、许可证、对比大模型的公开证据及本地运行代码,并指出语言覆盖窄、仅限研究用途等局限。作者建议按任务替换试用,保留大模型处理其独有能力。
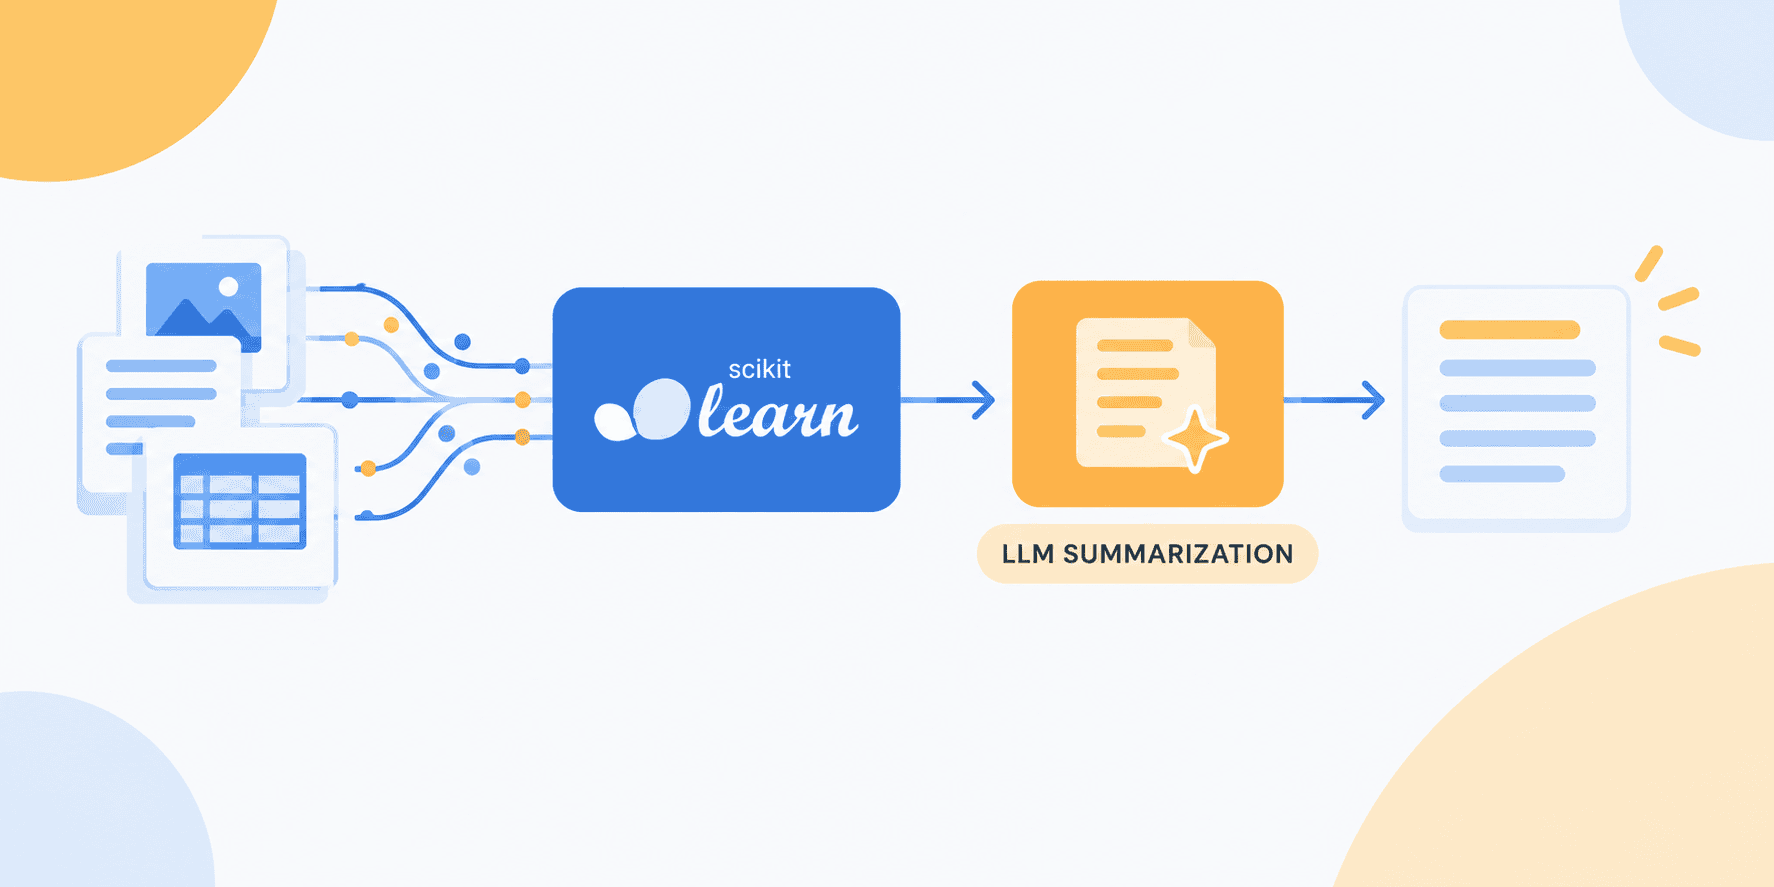
文章介绍如何用Scikit-LLM将大语言模型摘要功能嵌入scikit-learn流水线:先用Groq免费模型将冗长嘈杂文本压缩为简短摘要,再用TF-IDF向量化,最后用逻辑回归分类。整个流程可端到端训练和预测,仅需少量示例即可完成能源、金融、医疗等主题分类,兼顾LLM与传统轻量模型的优势。
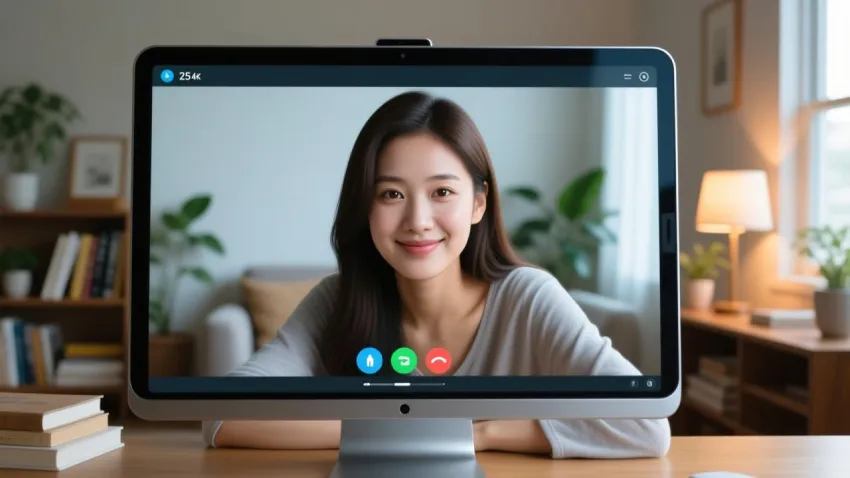
AI女友正从文字聊天升级为视频通话,角色能注视用户、用自身声音回应并做出表情动作。该技术由三部分协同实现:大语言模型生成对话,文本转语音合成声音,视频则通过实时拼接预制动作片段完成,而非逐帧生成。数据显示多数会话很短,中位约4条消息、两分半钟,但用户会主动要求角色在视频中做动作。选择此类应用时,应留意其是否坦诚说明视频为动作拼接而非实时生成。
提供的文本仅包含网页导航和作者信息,没有实质性文章内容,无法进行总结。
完成下面两步后,将自动完成登录并继续当前操作。