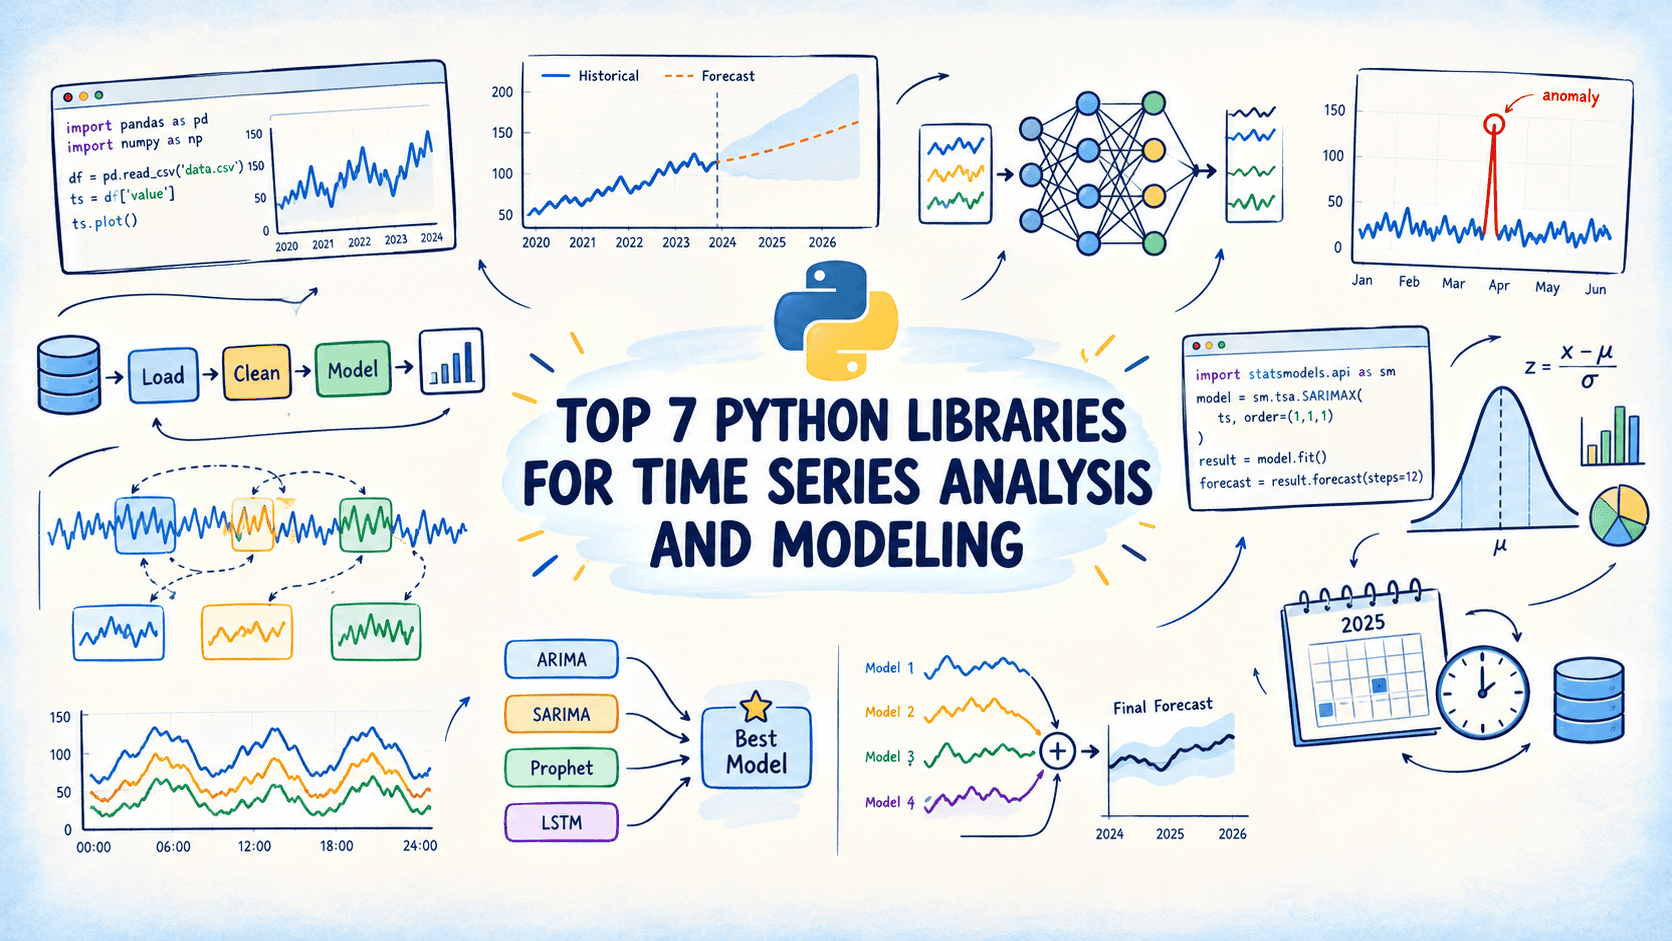
文章介绍了七个Python时间序列库:statsmodels用于可解释的ARIMA等统计建模;pmdarima自动搜索ARIMA阶数;sktime提供统一的机器学习接口与防泄漏交叉验证;Darts支持概率预测、多序列全局模型及异常检测;stumpy通过矩阵轮廓发现模式和异常;PyOD汇集60多种异常检测算法;NeuralForecast提供30多种深度学习预测架构。建议在同一数据集上对比使用这些库。
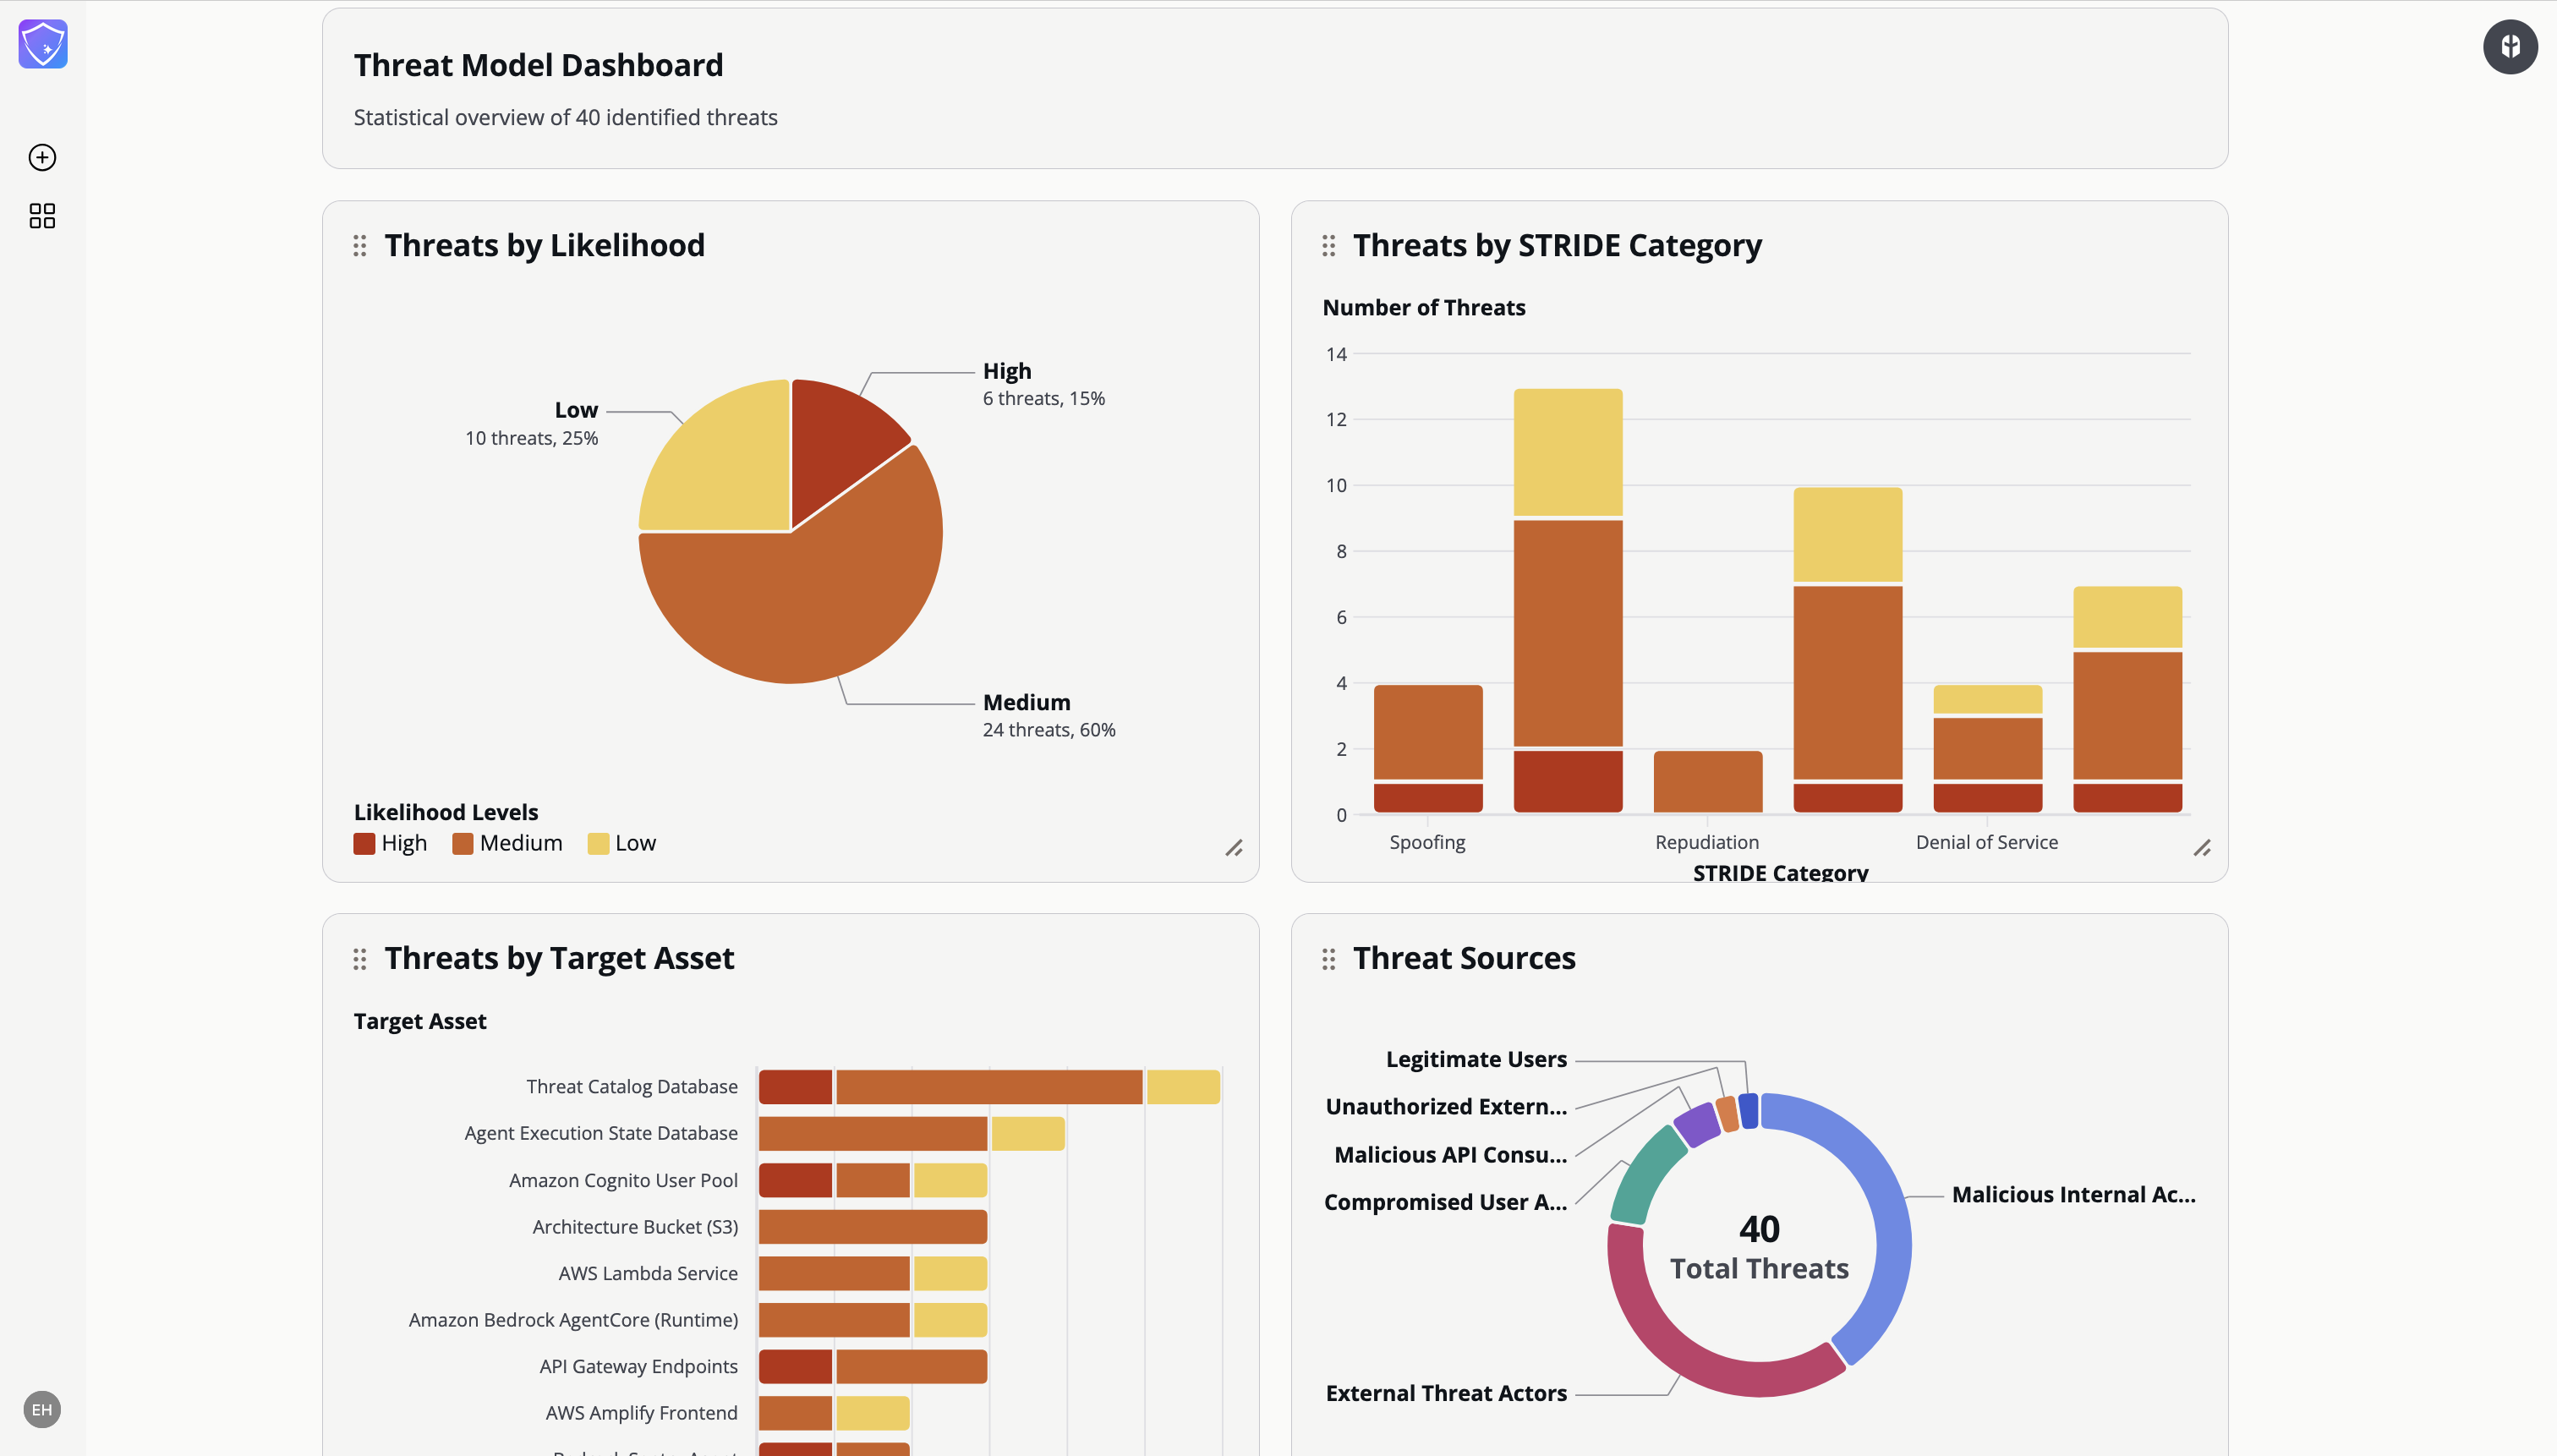
TUI安全团队仅4人,却需服务100多个产品团队,人工威胁建模每次耗时4–6小时,每月仅能完成3–4次。团队借助Amazon Bedrock(Claude Sonnet 4.5)与AgentCore构建智能体工作流,通过元数据筛选标准(上下文缩减94%)、自校正威胁生成与联网搜索缓存实现自动化威胁建模。上线后单次评估时间最多减少70%,月处理量增至10–12次,威胁识别达40–60个,标准应用100%一致,并已在全公司推广。
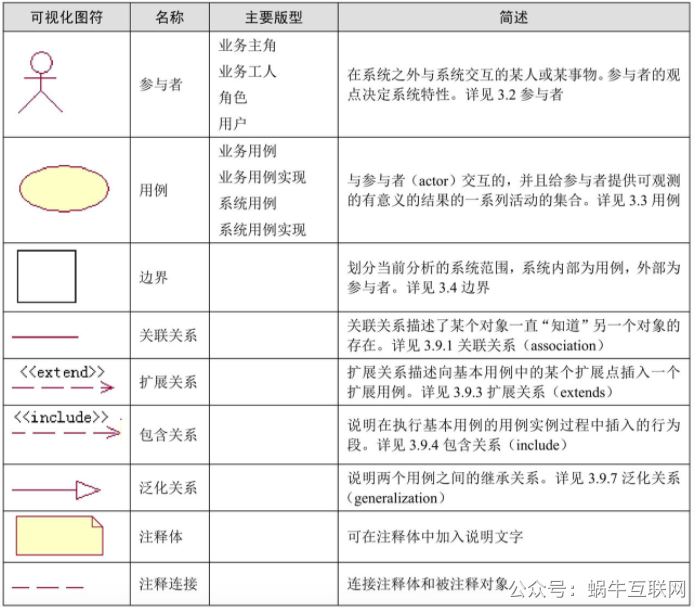
本文是UML视图常用元素参考,按图类型列出常用元素,包括用例图、类图、活动图、状态图、时序图和协作图,供建模时查阅。
本文介绍MongoDB Search的搜索数据建模与模式设计,核心原则包括:按最终搜索体验建模,将可搜索实体作为一等文档;同名字段保持类型一致;遵循“一起搜索的数据一起索引”。推荐采用实体模式,将电影、演员、类型等统一存入实体集合,以支持输入即建议、按类型过滤、分面与加权排序,并通过聚合管道从源数据同步生成实体。
本文是MongoDB搜索模式设计指南第一部分,聚焦物理约束与基础概念。核心观点:文档分组由工作负载决定。$search须为聚合管道首阶段,通过mongot调用Lucene,返回按相关性排序的批量结果,应限制结果并分页。每个索引最多约20亿个索引对象,嵌套文档映射会成倍增加对象数。设计要点:字段名与类型须一致,避免混用;建议用typeSet精简字符串索引以减小体积;可用视图实现部分索引、字段扁平化、向量降维和文本化。
软件团队应关注交付价值而非成本。AI时代开发提速后,瓶颈转向客户注意力,需优先做真正有价值的功能。因价值归因困难且滞后,建议用AARRR等代理指标建立财务模型,预测净现值,并联合销售、财务等部门参与。模型虽不完美,但能暴露假设、辅助优先级决策,是战略落地的重要工具。
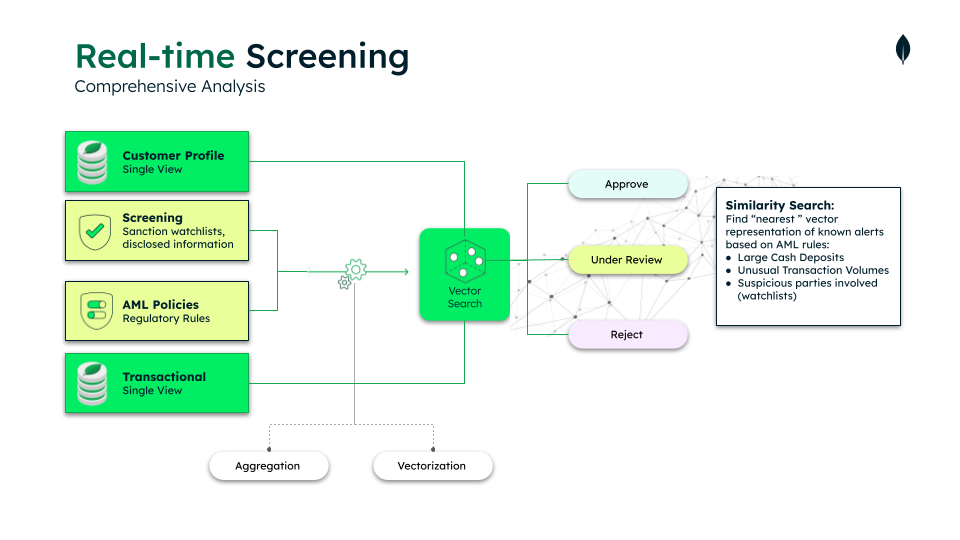
本文介绍如何用MongoDB构建金融犯罪防控平台。传统规则系统难以应对实时支付等场景,需将规则与行为风险建模相结合。MongoDB的灵活文档模型可整合交易、行为、地理等多源数据,变更流支持事件驱动的实时风险模型更新;向量搜索通过相似度比对识别可疑交易,减少误报,并将高风险交易转交深入调查。其模式灵活、实时更新、版本控制与审计等能力,使行为风险建模和情境化欺诈检测在技术上可行。
AI生成3D模型实测对比OpenSCAD与CadQuery:两者成品均达3D打印标准,迭代次数相当,主要差距在出错模式。CadQuery报错显性、会中止运行,问题前置;OpenSCAD极少报错,隐性几何错误多,易输出报废零件。渲染预览无法发现致命缺陷,须靠体积、干涉等数值核验。简单结构选OpenSCAD,高精度组合件选CadQuery,成品还需独立网格检测。
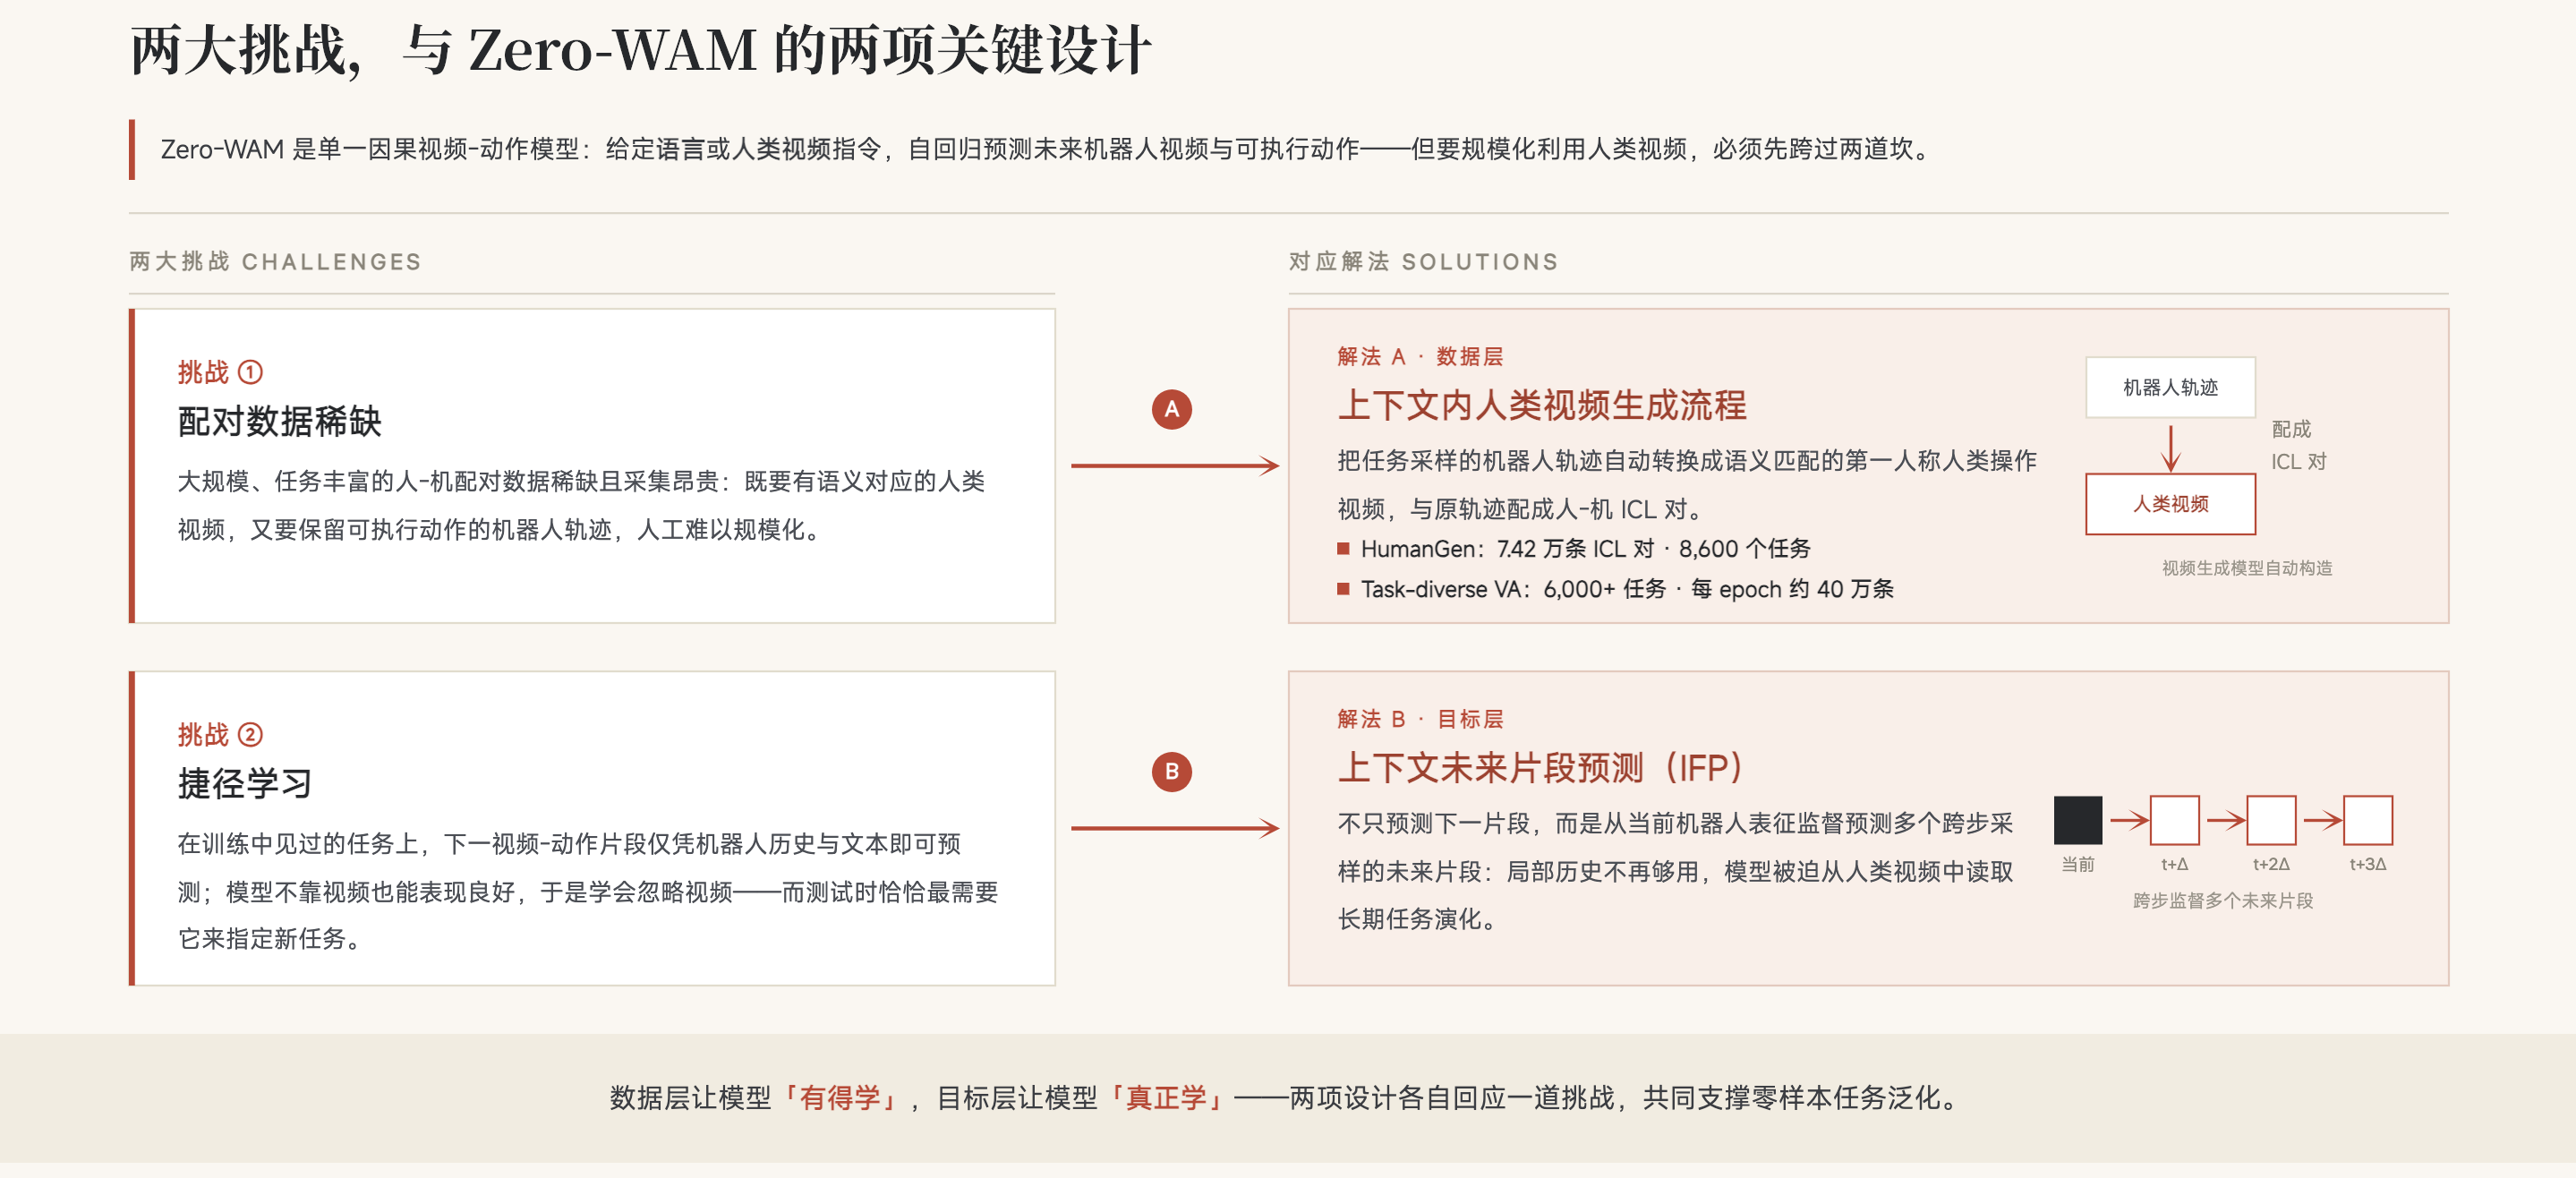
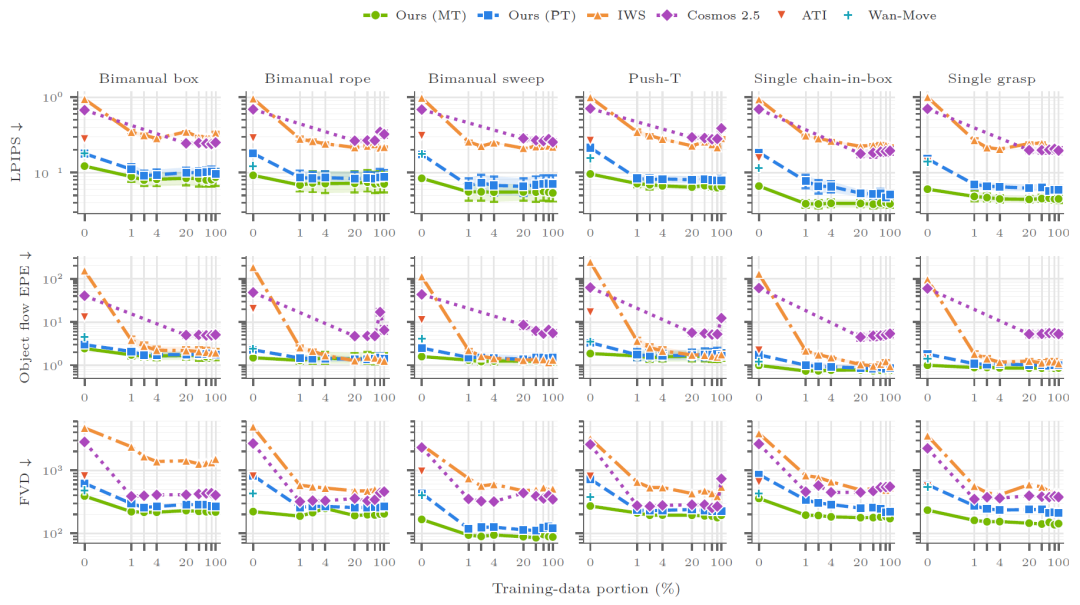
蚂蚁灵波与港科大联合提出Zero-WAM,一种因果视频-动作模型,通过上下文学习实现机器人零样本跨任务泛化。它利用人类视频作为任务描述,并构建HumanGen数据集(含8.6K任务、74.2K人机样本),提出上下文未来片段预测目标,避免模型走捷径,从而从视频中提取任务信息执行未见任务。
英伟达与哈佛等团队提出Hydra-0,一种以动作流为条件的通用世界模型,将机器人动作表示为像素运动,统一跨本体、任务和环境的预测。该模型降低机器人运动误差90.4%,物体运动误差60.2%,支持零样本组合,并在RoboLab中预测成功率与真实结果高度相关(r=0.96),同时实现高效推理和真实世界验证。
本文区分系统设计中两种抽象:模块化抽象(如Java)通过隐藏内部细节简化使用,建模抽象(如TLA+)通过削减无关信息提炼核心以精确推理。前者隐藏并发,后者暴露并发以验证安全性。工业界如亚马逊已用TLA+发现深层缺陷,但模型回填真实系统仍存挑战。
fable51-worlds项目利用AI智能体集群,在数天内将旧金山街区数据转化为可交互三维场景,替代了传统数千小时的人工建模。该项目通过Claude Fable 5.1调度研究、建模、质检智能体,成本极低,并成功处理NASA数据生成金星地形图,展示了通用空间智能引擎自动生成可交互世界的能力。
SwiftData 处理大数据集时性能不佳,主要因为缺少惰值机制,查询即加载全部属性,导致内存占用高。建议按使用频率拆分模型,将详情字段放入关联对象,列表仅加载轻量数据。临时方案可用 fetchIdentifiers 配合 HistoryObserver,但非最佳。核心是设计时避免宽模型,以提升列表性能。
宇树科技发布四足机器人消防应急方案,推出智能水炮、侦测、搬运等多款机器狗,具备双向语音对讲、实时三维建模、高速高负载等特性,强调协同作战,实现人机配合的智慧消防闭环,提升救援效率与安全性。
复旦大学王烁团队提出“生命算子”框架,将生命视为多尺度动力系统,通过感知、演化、生成三类算子及尺度桥,实现从细胞到器官的跨尺度推演。该框架已在消化内镜、肾癌、心脏等领域应用,并孵化Cardio-World项目,旨在构建可验证的虚拟临床系统,推动医疗智能发展。
论文提出BayesBeliefAgent,针对多智能体系统中伙伴中途换策略而智能体反应迟缓的问题,结合GPT-4o规划器与贝叶斯追踪,仅在动作与推断技能矛盾时触发重规划。在Overcooked基准上,该法将信念-行动差距从0.41降至0.20,重规划次数减少20-80倍,但Forced Coordination布局收益有限。
本文介绍2019年Song与Ermon提出的基于分数的生成建模框架。该方法不直接学习数据分布,而是学习其分数(对数密度梯度),通过分数匹配训练噪声条件分数网络(NCSN),并用退火朗之万动力学从噪声中采样。多级高斯噪声扰动解决了流形假设和低密度区域问题,在CIFAR-10上取得先进结果,为现代扩散模型奠定基础。
本文探讨云原生交付中的“影子AI”风险,即未经批准的AI工具或代理在软件生命周期中访问代码、密钥和云环境。文章按开发笔记本、源码控制、CI/CD、Kubernetes运行时等阶段进行威胁建模,并提出治理措施:为AI代理分配身份、最小权限、短期凭证,使用Kyverno、Falco、SPIFFE/SPIRE等CNCF工具加强策略、检测和供应链安全,强调人类审批和防御纵深,确保AI可控可审计。
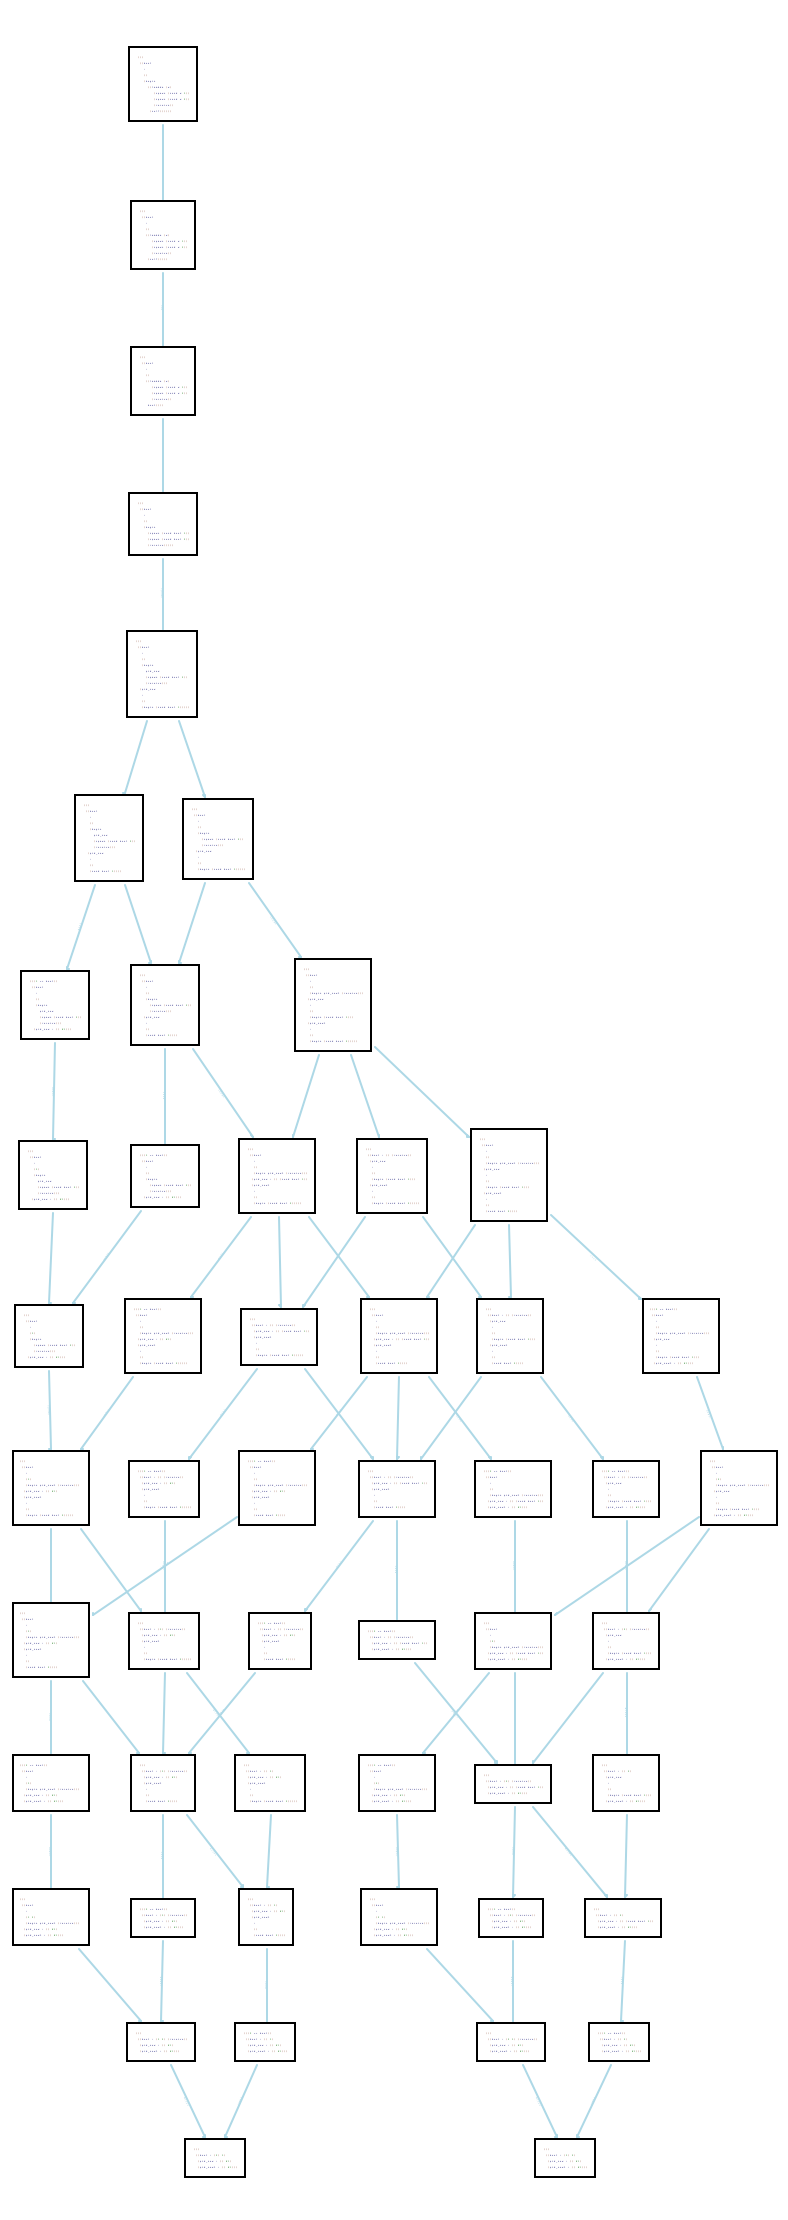
本文介绍使用PLT Redex建模Actor系统时,通过减少不可观察的非确定性来提高效率。作者将内部计算与通信效果分离,合并发送和投递规则,并采用贪婪归约,使示例程序的评估时间从1015毫秒降至2毫秒,状态数从74减至13。最终模型更简洁,能更真实地反映Actor的观察能力,但要求Actor不发散。
本文介绍使用Amazon Athena分析Kiro团队用量报表的实践。针对CSV中动态模型列可能导致数据错位的问题,通过ETL将宽表转为长表,采用Parquet格式和Partition Projection建表,实现稳定查询。方案完全Serverless化,月成本低于1美元,并接入Amazon QuickSight构建看板,便于团队观测用量、治理额度。
完成下面两步后,将自动完成登录并继续当前操作。