小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
沉浸式翻译 immersive translate
Dify.AI
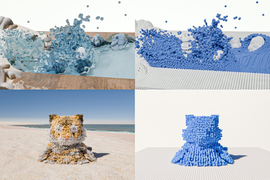
单一AI模型可模拟多种物质的行为,从滑动的沙粒到折叠的蛋白质

麻省理工学院等机构研发统一深度学习系统WorldParticle,将沙粒、蛋白质等各类物质表示为粒子,用神经网络逐步预测粒子运动,无需为每种现象单独编写求解器。该系统能泛化到未见材料和外力,模拟精度高于传统数值方法,蛋白质模拟速度约快100倍,有望用于软体机器人、材料发现等领域。

单一AI模型可模拟多种物质的行为,从滑动的沙粒到折叠的蛋白质

MIT News - Computer Science and Artificial Intelligence Laboratory (CSAIL) MIT News - Computer Science and Artificial Intelligence Laboratory (CSAIL) · 2026-11-09T05:00:00Z
仅需25%采样,帧率最高提升至 4 倍,深度学习革新活细胞纳米荧光成像

瑞典与德国等团队将深度学习与RESOLFT纳米显微结合,开发了HDN分层去噪网络和Fast-MoNaLISA稀疏采样重建框架,以解决光开关疲劳与成像耗时问题。HDN可在光剂量降低10倍时恢复低信噪比图像,使活细胞延时成像延长至5倍;Fast-MoNaLISA在25%采样下实现最高4倍帧率提升并减轻伪影,成功观测线粒体囊泡、肌动蛋白网络等亚细胞动态过程。

仅需25%采样,帧率最高提升至 4 倍,深度学习革新活细胞纳米荧光成像

HyperAI超神经 HyperAI超神经 · 2026-10-23T06:03:47Z
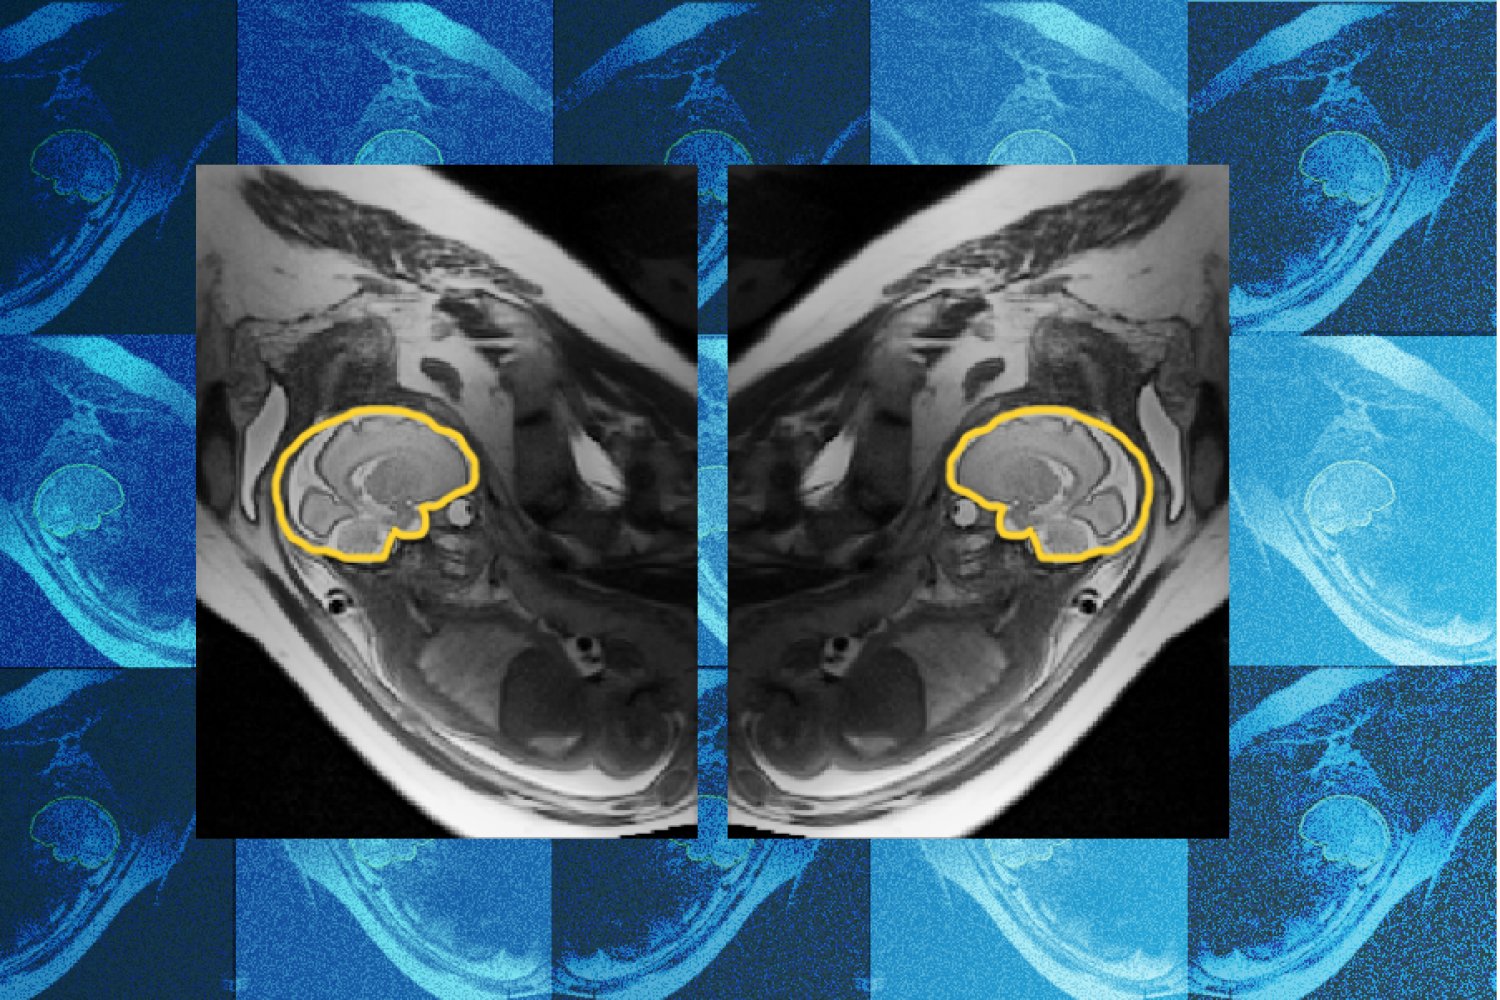
为何教AI理解对称性能让产前诊断更可靠

麻省理工学院与波士顿儿童医院等机构开发出深度学习模型E(3)-Pose,可在胎儿头部移动时实时校正MRI扫描,生成高分辨率三维图像,减少运动导致的图像缺口和误诊,并避免孕妇重复检查。该模型将左右对称等物理原理嵌入网络结构。研究团队希望未来将其扩展至更小、活动更多的孕中期胎儿,以便更早发现脑部异常。

为何教AI理解对称性能让产前诊断更可靠

MIT News - Computer Science and Artificial Intelligence Laboratory (CSAIL) MIT News - Computer Science and Artificial Intelligence Laboratory (CSAIL) · 2026-10-19T18:20:00Z
人工智能简史:从图灵测试到智能体 AI,70 年如何走到今天?

人工智能发展逾70年:1950年图灵提出测试,1956年达特茅斯会议正式命名AI。早期依赖人工规则,1997年深蓝击败卡斯帕罗夫,2011年Watson在《危险边缘》夺冠。2010年代机器学习和深度学习崛起,2022年ChatGPT引爆生成式AI。当前迈向能自主行动的智能体AI,终极目标是通用人工智能。

人工智能简史:从图灵测试到智能体 AI,70 年如何走到今天?

Java for You Java for You · 2026-10-15T01:31:24Z
AI来袭之年:创业教学将彻底改变

精益创业课程15年来让学生走出课堂访谈客户、验证假设。但2026年春季,AI使学生第一天就能做出完整产品,并用AI替代客户调研,把MVP变成推销而非实验,收集赞美而非反证,导致确认偏误、延迟转型和学习债务。教学团队反思认为,AI虽提升效率,却损害了深度学习,需重新设计课程。

AI来袭之年:创业教学将彻底改变

Steve Blank Steve Blank · 2026-09-23T13:00:12Z
深度学习实战演进——Geoffrey Hinton 的 AI 遗产

freeCodeCamp 发布 27 小时课程,用 PyTorch 复现 Geoffrey Hinton 的关键论文,涵盖玻尔兹曼机、反向传播、t-SNE、AlexNet、Dropout、知识蒸馏、胶囊网络、层归一化与前向-前向算法,梳理深度学习思想演变。

深度学习实战演进——Geoffrey Hinton 的 AI 遗产

freeCodeCamp.org freeCodeCamp.org · 2026-09-17T18:00:11Z
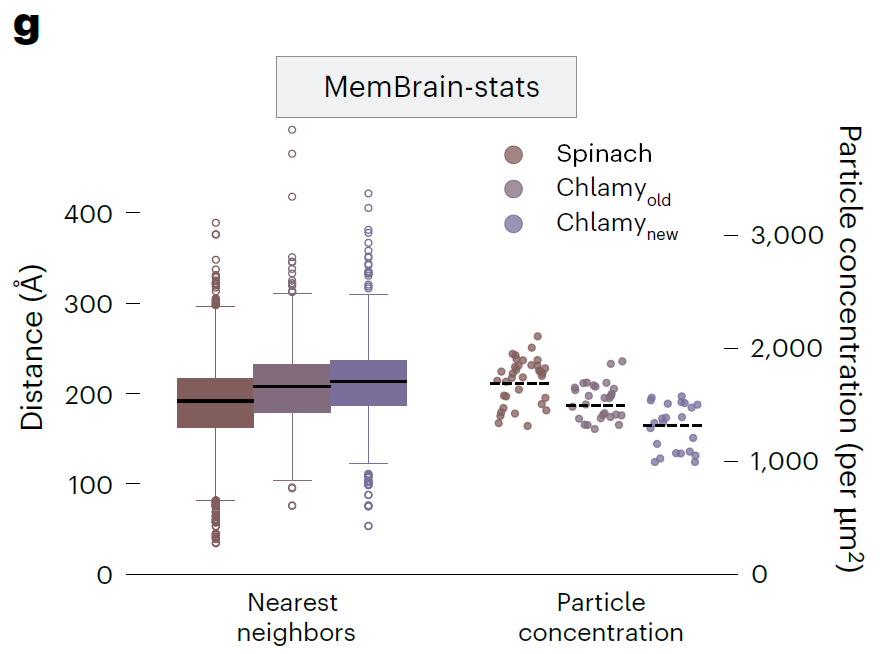
从膜分割到颗粒定位,深度学习框架MemBrain v2打通冷冻电镜分析全流程,显著提升分析速度和处理通量

冷冻电子断层成像的膜结构分析受低信噪比和缺失楔伪影限制。研究团队提出MemBrain v2端到端框架,包含MemBrain-seg(泛化性膜分割)、MemBrain-pick(膜结合颗粒定位)和MemBrain-stats(颗粒分布定量分析)。该工具在藻胆体链和核糖体组织分析中验证可靠,提升了速度与通量,减少人工标注依赖。

从膜分割到颗粒定位,深度学习框架MemBrain v2打通冷冻电镜分析全流程,显著提升分析速度和处理通量

HyperAI超神经 HyperAI超神经 · 2026-09-16T09:28:49Z

谷歌与NASA JPL联合发布AI模型MAPL-EMIT,利用太空数据追踪全球甲烷排放。该模型经360万模拟羽流训练,能识别比人类专家多50%的甲烷羽流,额外发现超2.3万个排放源,包括全球25个最大垃圾填埋场中的24个。数据已开源,助力气候缓解行动。

一种新的深度学习模型从太空绘制全球甲烷排放图。

The Keyword The Keyword · 2026-09-09T18:15:00Z
MediaGo三度蝉联全球科技奖广告技术卓越奖

MediaGo连续第三年荣获全球科技奖广告技术卓越奖。该平台基于深度学习,以SmartBid 3.0智能出价为核心,辅以AD Learning和AI审核助手,实现冷启动加速、预算完成率提升58%,并推出新功能优化广告效果与审核效率。

MediaGo三度蝉联全球科技奖广告技术卓越奖

全球TMT-美通国际 全球TMT-美通国际 · 2026-09-03T02:07:57Z
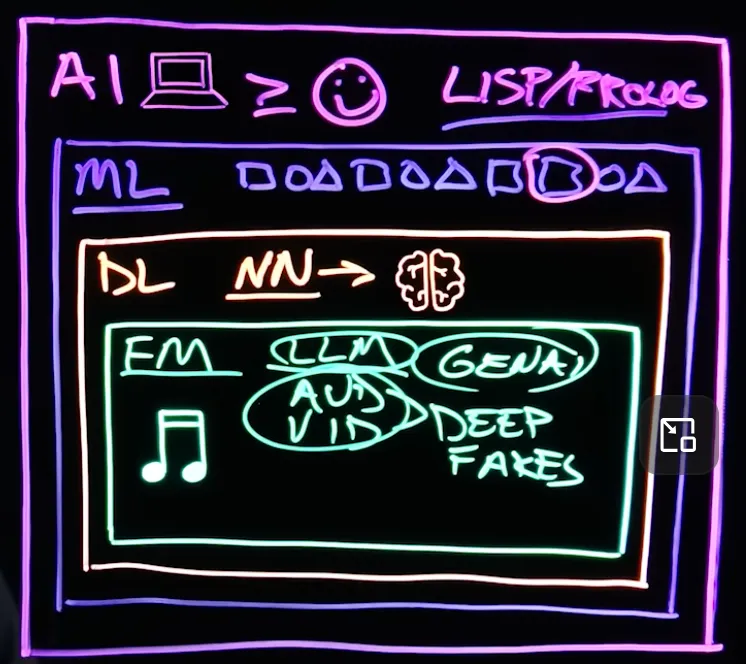
一张图看懂 AI、机器学习、深度学习和生成式 AI 之间的关系

本文通过图解方式厘清AI、机器学习、深度学习和生成式AI的关系。AI是总目标,机器学习通过数据学习,深度学习利用神经网络自动提取特征,生成式AI基于大模型创作内容。文章还简述了技术发展时间线,强调AI是工具,关键在于理解和使用。

一张图看懂 AI、机器学习、深度学习和生成式 AI 之间的关系

Java for You Java for You · 2026-08-21T10:57:35Z
EP222:什么是谷歌的TPU?

Google的TPU是其专为深度学习设计的定制AI芯片,不同于为图形而生的GPU。最新第八代分为两款:TPU 8t用于训练,侧重高吞吐量;TPU 8i用于推理,侧重低延迟和芯片间速度。两者共享Axion CPU、液冷和软件栈,代码可互用。

EP222:什么是谷歌的TPU?

ByteByteGo Newsletter ByteByteGo Newsletter · 2026-08-15T15:30:49Z
黄仁勋:不玩𝕏是我太内向,现在为AI必须站出来

黄仁勋在访谈中回顾英伟达创业历程:早期技术方向错误,靠自学OpenGL扭转局面;与世嘉合作失败后获500万美元续命。他分享了对深度学习、AI智能体、物理AI和自动驾驶的洞察,强调系统思维、开源生态和持续学习的重要性,并鼓励年轻人勇敢创业。

黄仁勋:不玩𝕏是我太内向,现在为AI必须站出来

量子位 量子位 · 2026-08-01T03:38:10Z
SIGGRAPH时间检验奖揭晓:这项研究,提前十年押中了物理AI

该文章介绍香港大学Taku Komura教授团队在动作生成领域的研究。其2016年论文获SIGGRAPH时间检验奖,首次用深度学习学习人类运动先验,生成自然动作。团队后续扩展至场景交互,开源项目AI4Animation获8000+星。研究正应用于物理AI,用消费级设备低成本采集人类操作数据,训练世界模型,推动具身智能走向真实生活。

SIGGRAPH时间检验奖揭晓:这项研究,提前十年押中了物理AI

量子位 量子位 · 2026-07-31T09:11:32Z
PyTorch深度学习教程

本文介绍PyTorch深度学习框架,涵盖其特性、张量操作、环境搭建及构建MNIST手写数字识别模型的全流程。教程指导使用PyCharm配置环境、定义神经网络、训练并评估模型,最终达到96.87%测试准确率,并提及GPU加速、分布式训练等进阶技术。

PyTorch深度学习教程

The JetBrains Blog The JetBrains Blog · 2026-07-29T16:18:55Z
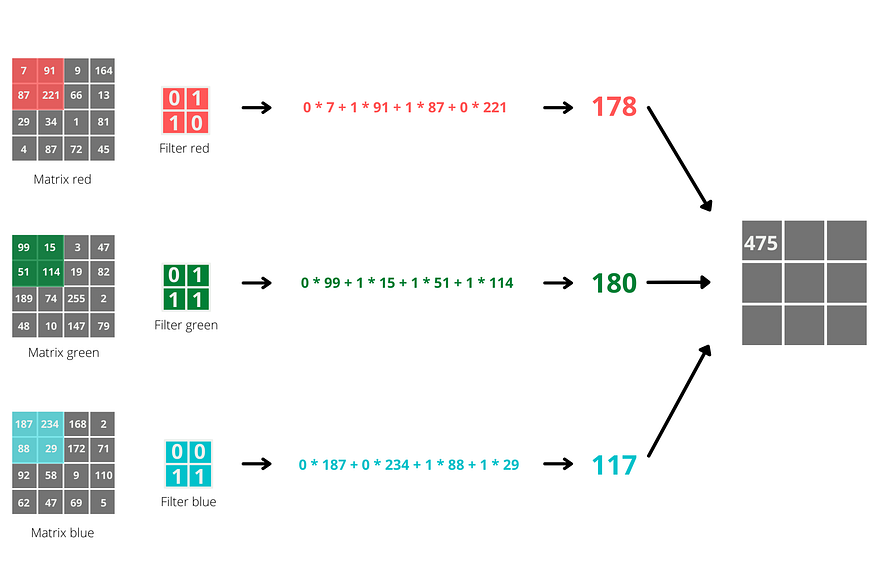
卷积神经网络、递归神经网络与变换器解析:深度学习关键概念的思维模型

深度学习是机器学习的一个子集,利用多层神经网络模拟人脑结构。主要类型包括卷积神经网络(CNN)、递归神经网络(RNN)和变换器(Transformers)。Keras是一个用户友好的深度学习API,简化模型构建和训练过程。

卷积神经网络、递归神经网络与变换器解析:深度学习关键概念的思维模型

freeCodeCamp.org freeCodeCamp.org · 2026-07-14T00:18:43Z
向量即一切:拆解ChatGPT底层的乘法加法与空间折叠

文章探讨了AI基础设施中的向量、神经网络和深度学习的核心概念。向量将词语转化为数字以计算相似度,点积运算用于衡量向量对齐程度。神经网络通过多层结构重塑输入,激活函数影响学习效果,损失函数定义错误,训练通过梯度下降优化模型参数。文章指出当前模型在处理上下文时的局限性,强调Transformer架构的重要性。

向量即一切:拆解ChatGPT底层的乘法加法与空间折叠

极道 极道 · 2026-07-10T04:28:00Z
微软开源了一个帮 Agent 打磨技能的工具,思路很野

SkillOpt 是一款优化工具,旨在提升技能文档质量。它通过模拟深度学习训练过程,记录 Agent 执行技能的情况,分析成功与失败的模式,并提出针对性的修改方案。经过验证后,只有有效的修改才会被接受。该工具已开源,适用于 Markdown 格式的技能文档,能够提高 Agent 的执行能力。

微软开源了一个帮 Agent 打磨技能的工具,思路很野

迷途小书童 迷途小书童 · 2026-06-29T15:57:58Z
GitHub 热门项目周刊 · 第 17 期 · 2026 年第 27 周

本期GitHub热门项目周刊精选了10个开源项目,涵盖AI、开发工具和云原生等领域,主要项目包括Codex-orange-book文档库、DeepSpec深度学习工具和Exploitarium漏洞利用库,适合开发者快速了解新工具和趋势。

GitHub 热门项目周刊 · 第 17 期 · 2026 年第 27 周

浅时光博客 浅时光博客 · 2026-06-29T01:02:36Z

GEMM(通用矩阵乘)是深度学习中的关键计算。通过优化实现,从朴素实现到共享内存和寄存器分块,显著提高了算术强度。寄存器分块的性能达到6375 GFLOP/s,接近FP32峰值的39%。未来的优化方向包括向量化、预取和更大的tile设计。

【GPU 算子工程】GEMM:从朴素实现到 shared memory tiling 与寄存器分块

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-06-28T00:00:00Z

Triton 是一种新型编程模型,简化了深度学习算子的开发。它通过编译器自动处理访存合并、共享内存管理和指令调度,减少了手动编码的复杂性。Triton 采用 tile 视角,允许开发者专注于数据块的处理,配合 autotune 功能自动优化配置,提升性能。总体而言,Triton 提高了开发效率,适合大多数自定义算子,但在极限性能和特定场景下仍需使用 CUDA。

【GPU 算子工程】Triton:tile 级编程模型与 autotune

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-06-28T00:00:00Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
友情链接: MOGE.AI 九胧科技 1tok 菜鸟教程 Remio.AI DeekSeek连连 53AI 神龙海外代理IP IPIPGO全球代理IP 东波哥的博客 匡优考试在线考试系统 开源服务指南 蓝莺IM Solo 独立开发者社区 AI酷站导航 极客Fun 我爱水煮鱼 周报生成器 He3.app 简单简历 白鲸出海 T沙龙 职友集 TechParty 蟒周刊 Best AI Music Generator 模力方舟 Gitee AI

小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码