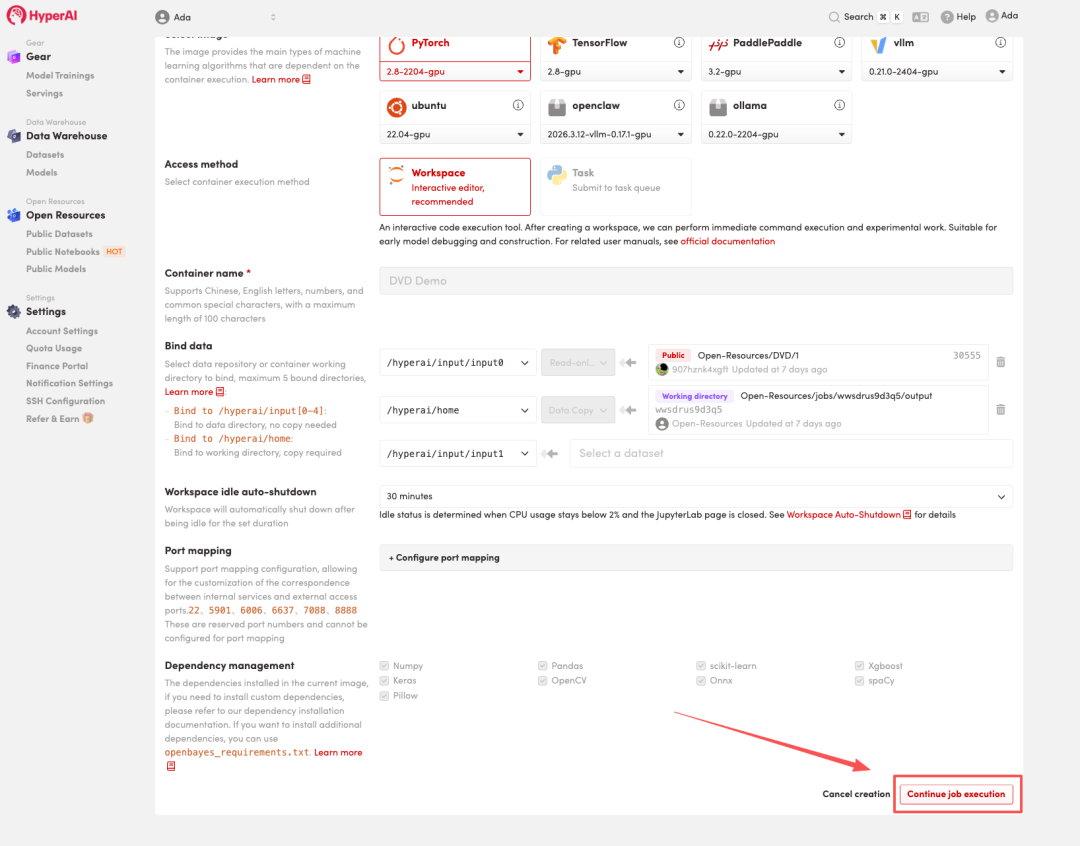
香港科技大学(广州)团队提出的DVD模型通过一次前向传播实现视频深度估计,提升了推理效率,解决了几何幻觉问题。该模型在多个基准测试中表现优异,仅需36.7万帧训练数据,显著降低了成本,为视频三维感知提供了新技术路线。
蚂蚁灵波科技开源了LingBot-Depth模型,提升机器人和自动驾驶的三维视觉能力。该模型利用“掩码深度建模”技术,解决透明和反光物体的深度感知问题,显著提高深度图的完整性和清晰度。
本研究提出了一种名为Ross3D的重构视觉指令调优方法,旨在解决大规模三维视觉-语言数据集的缺乏问题。该方法通过三维视觉监督,提升了三维场景理解的性能,并展示了未标记三维数据的潜力。
本研究分析了扩散模型在三维视觉中的应用,解决了效率和可扩展性的问题,尤其是提升了从二次数据恢复三维场景的准确性。通过优化计算效率和大规模预训练,显著提升了三维视觉任务的表现。
JARVIS-1 是一个智能体,在 Minecraft 中完成了超过 200 个任务,长期目标完成率为 12.5%。通过多模态记忆和决策制定,提升了智能和自主性。LEO 是一种通用代理,专注于三维视觉与语言的结合,表现优异。研究还提出了结合大型语言模型与机器人感知的双层架构,显著提高了任务执行能力。
本文介绍了一种新方法A$^{2}$-MAE,通过预训练不同类型的遥感图像和地理信息,重构遮蔽补丁,从而提升多种下游任务的性能。同时,研究探讨了自监督学习在三维视觉中的应用,提出基于掩码自编码器的模型,显著提高了三维物体检测的准确性。
本文介绍了多种基于拓扑的深度学习方法,如局部拓扑模型、拓扑神经网络和持久同调技术,旨在提升图分类和节点分类的性能。这些方法通过结合拓扑信息与图神经网络,显著提高了预测能力,尤其在医学图像分类和三维视觉对象分类中表现突出。
本文研究了密集三维视觉接地技术,提出了ConcreteNet网络,通过底层注意融合和对比训练提升物体定位性能。同时构建了Mono3DRefer数据集,利用文本嵌入进行多模态学习,提出了Mono3DVG-TR网络。文章还探讨了3D密集图像描述的任务定义及未来研究方向,强调大型语言模型在三维视觉定位中的应用。
该文汇总三维视觉研究,涵盖基于动态图卷积、递归图学习和单图指导的部件组装,以及3DMOTFormer、LEGO跟踪器、全局关联图模型等三维多目标跟踪方法,并涉及手物姿态联合追踪与RGB-D 6D姿态跟踪。
该文综述了360度全景图像三维视觉研究,涵盖空间变化光照、反射与几何估计,球面视差与深度估计,基于切线图像的高分辨率深度重建,全景视觉定位数据集360Loc,自监督球面视图合成,OmniFusion单目深度估计流程,无人驾驶全景深度与位姿恢复,球面图像增量式三维重建,以及室内场景三维布局恢复等方法。实验表明,这些方法在增强现实、定位和自动驾驶等应用中性能优越。
本文综述了多项利用几何先验的三维视觉研究:零样本点云语义分割框架借助几何基元实现类别间知识迁移,在S3DIS、ScanNet、SemanticKITTI上提升hIoU;主动学习利用几何先验简化三维体数据标注;此外还有基于预训练2D模型的单点提示3D医学分割、半监督形状估计和自监督预训练等方法,均在分割、检测等任务上提升了性能与效率。
完成下面两步后,将自动完成登录并继续当前操作。