Vercel 宣布其仪表盘和 Slack 中的 Agent 会话平均成本降低 67%。团队重构了 Agent 的上下文管理方式,减少每次会话所需 token 并提升提示缓存复用率,改进已生效且无需用户操作。主要变化包括:基于工作流的 CLI 技能为常见流程和错误恢复提供更清晰指引;增量上下文管理使长对话和长 Slack 线程处理更高效;改进提示缓存以复用更多上下文;更高效的编码与规划减少 token 消耗。计费费率不变,付费会话按模型提供商推理费率加每百万 token 0.25 美元的 Agent 费用计费。
本文介绍基于大模型构建Agent的方法:核心是“模型决策—程序执行工具—结果回传”的循环,需配置好Prompt、工具、上下文与记忆。文章给出Python最小实现,并强调保存完整输出、校验工具参数、设置停止条件。长任务需管理上下文,通过压缩历史保留目标与约束,但压缩有损,须能追溯原文。落地还需权限控制、超时重试、预算及可观测性评估。
以色列初创公司Uvi获750万美元种子轮融资,旨在解决AI代理重复搜集上下文导致成本虚高的问题。其平台通过语义层、知识图谱和推理层,集中管理企业分散在Slack、Jira等系统中的决策记忆,使代理一次获取精准上下文。测试显示,答案成本从0.75至1.41美元降至0.10至0.16美元,最高节省46倍。
文章提出以专用决策模型Jev重构编码智能体架构。现有Agent依赖KV缓存,导致仅追加式上下文,带来路由成本更高、工具挤占窗口、压缩丢失线索等六大缺陷。真实会话中写代码仅占Token消耗的4%–10%,文件读取与检索占近60%。新架构将状态显式类型化,由Jev每轮动态决定语块可见度、模型路由、工具披露与权限,并共享只读后台检索。
GPT-6 使用成本较高,文章建议通过以下方式节省 token:清理冗余 skill 与 AGENTS.md;任务不跨天,用简短 handoff 文件接续;同一窗口不切换模型;将上下文控制在 272K 以内;简单任务交给更便宜的模型。文章还介绍了 Jev 模型,其特点是输出结构化决策、速度快且成本低,可用于电脑操作、上下文压缩、模型路由和自动审核,并可利用 ChatGPT 网页版 GPT-6 Pro 额度。
Agent并非更聪明的模型,而是模型外加运行支架,用于管理上下文、工具、环境和会话状态。普通调用适合单轮任务,固定工作流适合步骤明确的场景,Agent适合需动态选路、跨步骤恢复的任务。常见误区包括:以为模型更聪明、工具越多越好、有记忆就不丢上下文、Agent会负责。判断是否使用Agent的标准:步骤能否预先列出、中间结果是否改变下一步、失败后是否需从检查点继续。
本文研究Claude Code的上下文管理,核心是Prompt Cache作为设计底座。文章提出三条铁律:前缀匹配、字节变化即失效、断点决定缓存起点。由此衍生四大策略(压缩、结构化笔记、子代理分解、按需检索)和31条具体机制,所有设计均以维持缓存稳定为目标。文章还列出8处官方文档与源码不符之处,并预告后续7篇系列文章。
文章聚焦AI代理基础设施中的上下文与状态层问题,指出模型本身并非失败主因,而是上下文管理不善导致性能下降和成本高昂。文中列举了上下文腐烂、记忆污染、token浪费和状态持久性不足等常见故障,并推荐使用Redis Iris作为整合方案,通过统一管理记忆、缓存和检索来提升代理可靠性。
长时智能体上下文管理采用两阶段预压缩:用量达90%时后台摘要前缀,达100%时仅合并摘要与尾部增量,减少主循环阻塞。压缩保留原始记录与本地JSONL恢复指针,并冻结系统提示以维持缓存命中。优先裁剪旧工具输出,避免不必要的LLM摘要。实测每轮输入token降低40%,上下文稳定在约28万。
文章介绍了AI编程中的“上下文开发生命周期”(CDLC)框架,强调技能、代理配置等上下文资产需像代码一样管理。CDLC包含生成、评估、分发、观察四个阶段,但多数团队忽视评估和观察。文章提出通过减少人工干预和提升复用率来扩展规模,建议平台团队建立共享基础设施,以治理和工具支持上下文管理,最终实现更可靠的AI辅助开发。
Claude Code配置复杂,九层体系(CLAUDE.md、钩子、MCP、子代理、代理团队)叠加易致上下文超载、成本高。建议精简CLAUDE.md至80行,钩子强制执行关键规则,MCP按需挂载,子代理限定输出,代理团队用于并行协作。上下文满时用/clear或重启,并警惕“上下文腐烂”问题。
本文介绍GeekAgent开发第5天实现历史压缩功能。当对话历史超过4000字符阈值时,自动将旧消息摘要为一条系统消息,保留最近6条完整消息,防止上下文溢出且不丢失关键信息。提供自动触发和手动/compact命令两种入口,压缩过程显示黄色进度提示。通过实测验证,压缩后模型仍能准确回答旧对话中的事实。
Claude Code Agent Loop的核心机制是:用户输入后,harness记录历史并循环调用LLM,执行工具调用并追加结果,直到无工具请求才结束。用户仅参与首尾,中间自动运行。真实产品需处理上下文满、API失败、中断、工具崩溃等复杂情况,并集成hooks、权限批准、maxTurns等机制。
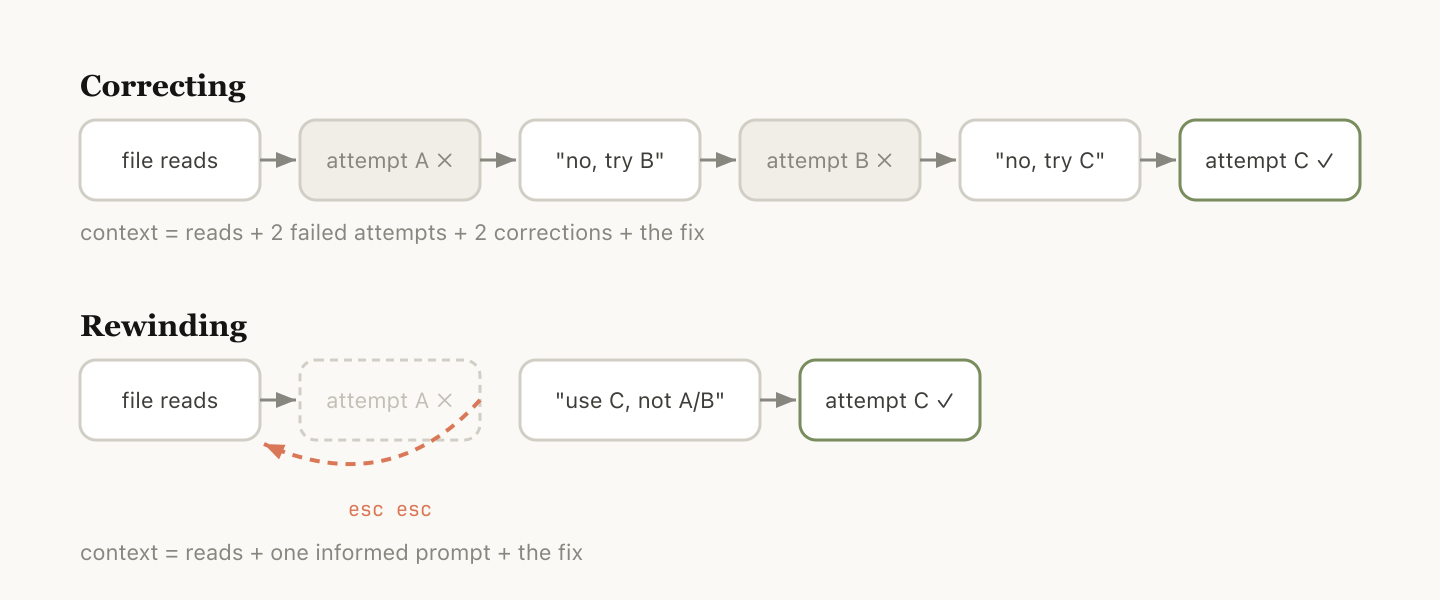
我们推出了新的命令/usage,帮助用户理解Claude Code的使用情况。用户在管理会话时存在差异,尤其是在使用一百万上下文的更新后。上下文窗口包含系统提示、对话、工具调用及其输出等。过多上下文会导致性能下降,称为上下文腐烂。用户可以选择继续、回退、清除或压缩会话,以更好地管理上下文。对于新任务,建议开始新会话。使用子代理可以处理大量中间输出,最终只返回结果。
用AI写代码三个月,发现Claude Code因上下文超载易产生幻觉代码。核心工作流:单任务单会话避免历史污染;分大脑窗(规划)与工作窗(执行);关键信息落盘文件防遗忘;用新聊天窗跳出错误循环;强制审计流程验证代码;用Git工作树并行开发。流程对抗AI偷懒,开发者需先想清楚再交给AI。
本文探讨了代理型AI循环中隐藏的令牌成本问题,指出成本会非线性复合增长。文章列举了五种成本陷阱:O(N²)上下文累积、无界重试循环、未过滤工具负载、单一模型路由和静态系统提示重复。解决方案包括上下文压缩、断路器、负载过滤、动态模型路由和运行时提示注入。最后强调应将上下文视为受限资源,从第一天起就进行管理。
循环工程是设计AI代理自主运行循环的实践,源于2026年6月的讨论,核心组件包括目标、工具、上下文管理、终止和验证。它从提示工程演进而来,基于ReAct和Reflexion研究,常见模式有重试、计划执行验证等,关键挑战是上下文管理、终止和验证,人类仍需在敏感决策中把关。
本文以“每月自动统计仓库变化并生成月报”为例,解释AI原生架构中Agent、Subagent和Skill的区别:Skill是静态操作指南和工具脚本,Subagent是独立上下文的专职子智能体,主Agent负责调度。通过Skill+Subagent协同,避免上下文污染,提升效率。Subagent既有运行态实体,也有静态配置持久化。设计时,静态流程写成Skill,复杂任务定义Subagent,主Agent保持轻量调度。
本文讨论了在智能代理系统中确保信息新鲜度的重要性,以避免因过时数据导致的错误。文章强调了上下文管理,并提出六个需要保持更新的组件,指出快速读取新数据的必要性。Redis Iris被介绍为一种实时上下文引擎,能够在数据写入和读取过程中保持新鲜性,从而提高代理的决策准确性。
选择合适的AI Harness对提高编程效率至关重要。普通用户应购买现成的Harness以简化操作,而工程师则可自定义以满足特定需求。Harness分为开发框架、可扩展核心和全家桶三类。评估时需关注上下文管理和模型灵活性等指标。未来,Harness将成为智能调度中心,优化任务分配和性能。
完成下面两步后,将自动完成登录并继续当前操作。