文章介绍用Java 17为视觉识别票据金额设置安全门禁:模型只负责提取字段,Java用BigDecimal、币种白名单和金额上限判断能否进入人工复核,避免浮点误差与误报销。代码无需外部依赖,并强调超时、幂等、原图留存与审计,适合低风险票据预分流,不适用于自动付款或税务认定。
本文介绍用 Python 调用 Gemini 结构化输出实现工单路由:通过 JSON Schema 限定 queue 和 priority 的枚举值,模型输出后由 safe_route 独立校验,越界即转人工复核。代码包含超时与异常降级,并强调 Schema 只约束格式、不保证事实正确,适合自动分流而非直接批准退款,需记录版本并抽样统计错分率。
文章介绍在Java中调用多模态模型抽取票据金额前进行本地校验:检查文件类型仅限JPG/PNG、大小不超过5MB,并用BigDecimal比对申报金额与识别金额,容差0.01元。示例基于JDK17+的HttpClient构造REST请求,显式处理密钥、超时和状态码,强调模型输出不可直接作为付款指令,需JSON解析与人工复核。
本文介绍用 TypeSafe Jev 模型构建简历筛选系统。Jev 不生成文本,只返回带校准概率的数值答案,避免大模型打分不可比、无法排序的问题。系统由 HR 按岗位编写评分标准,代码计算加权总分,低置信度结果转人工复核。实测 71 份简历,单次成本约 0.0002 美元,中位延迟 400 毫秒,60% 被标记复核。
机器人训练失败常源于数据质量而非模型规模。以LeRobot与LanceDB集成为例,数据版本化可让训练、搜索、质检指向同一份可复现数据。核心检查包括动作时延、异常抖动、切分泄漏等,并强调按地点、人员或批次分组切分,建立数据契约与人工复核门禁,避免标签错误和时序错位。
AI代码审计利用大模型语义推理,弥补传统SAST在复杂逻辑分析上的不足,已进入工程化落地阶段。在Gitee等平台可通过Webhook集成到PR流程,拦截硬编码密钥等低级漏洞,但存在幻觉与合规风险,需采用“AI初筛+人工复核”模式,而非完全替代人工。
AWS发布Deception Benchmark,测试AI能否识别看似危险但已被缓解的代码。结果显示通用模型难以兼顾误报与漏报;要求模型提供证明可减少误报,但会增加漏报。文章建议团队验收安全AI时同时评估误报和漏报,结合人工复核,并按资产等级设置阈值。
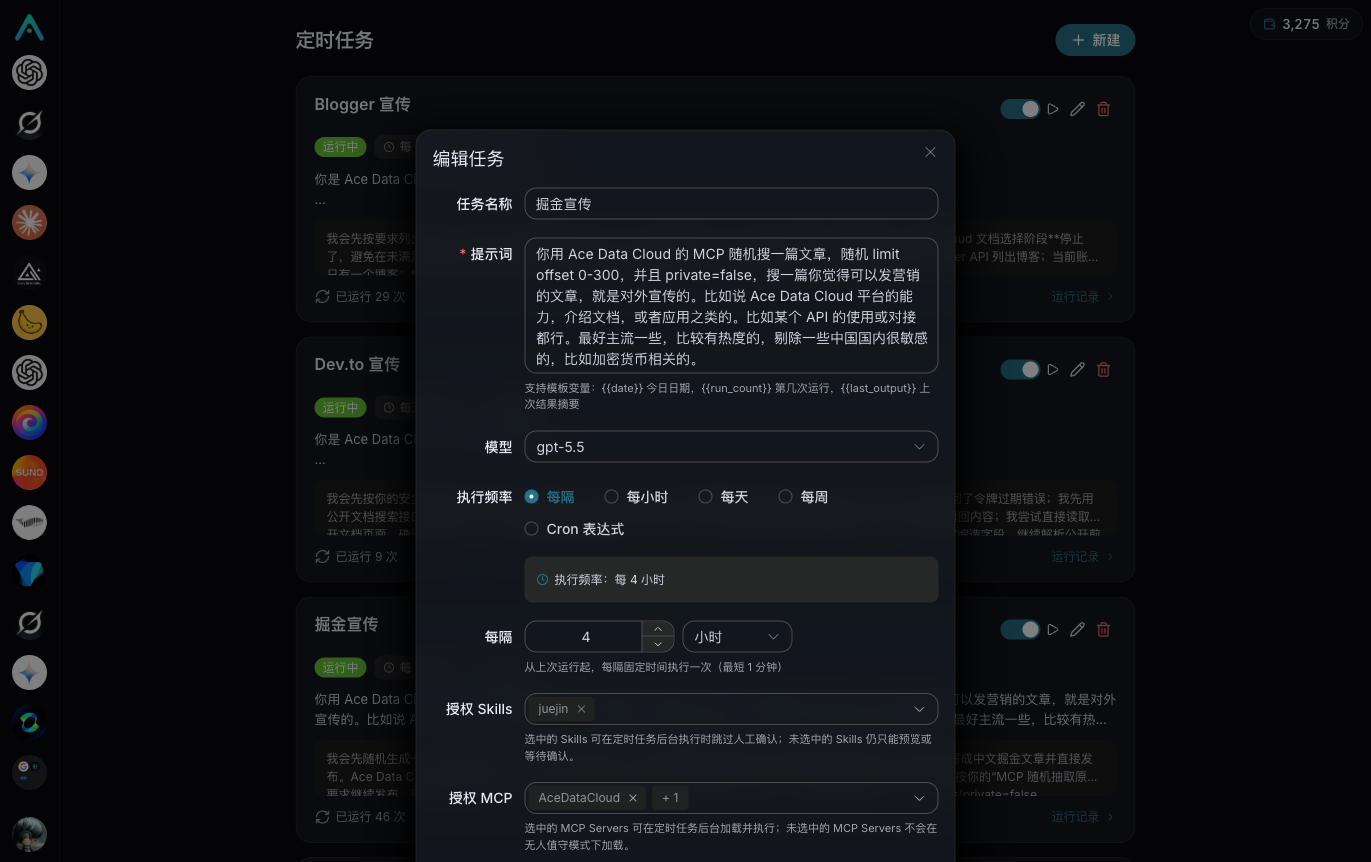
本文介绍Studio定时任务工作流,强调按计划生成、复核与发布内容。需配置允许列表、先手动验证再设计划、定期检查运行结果,并注意不适合无人值守的场景。任务成功依赖模型、凭证等,建议保存草稿并保留人工复核机制。
完成下面两步后,将自动完成登录并继续当前操作。