


Anthropic推出了“反思”功能,旨在帮助用户回顾Claude的使用情况。然而,工程师对其有效性表示怀疑,认为该功能缺乏深入分析,可能加深用户对AI的依赖。专家指出,AI工具无法替代人类判断,决策应由组织内部领导制定,而非依赖AI供应商。
本文探讨了大型语言模型(LLM)在工程中的应用,强调了从Prompt Engineering到Loop Engineering的四个阶段。每个阶段通过增加token提升模型的可用性,解决了模型在执行任务时的局限性。尽管工程不断优化,模型能力未显著提升,真正的挑战在于如何定义和维持任务完成标准,最终仍需人类参与判断。
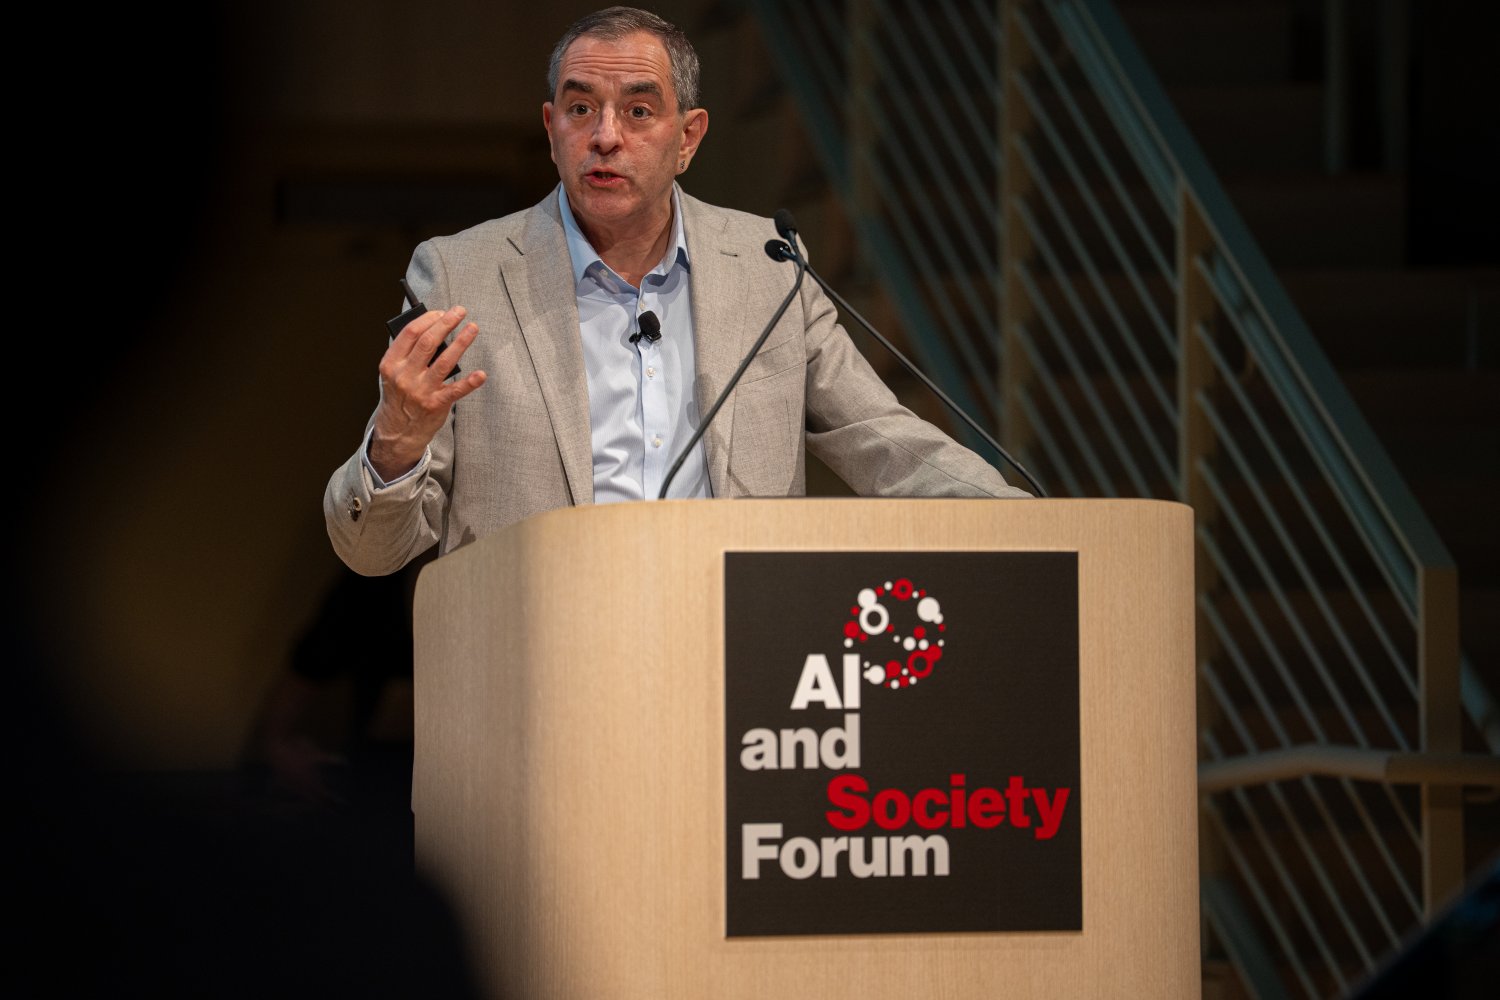
在麻省理工学院的AI与社会论坛上,专家们讨论了人工智能对就业和民主的影响。经济学家大卫·奥托指出,技术的影响取决于其对人类专业知识的稀缺性和价值的改变。与会者强调人类判断在决策中的重要性,并探讨了AI可能带来的新工作机会及其对民主程序的潜在威胁。
AI的真正价值在于上下文,而非模型本身。企业在AI应用中失败,往往是因为未重视上下文的构建。有效使用AI需要将隐性知识结构化为可复用的技能框架,以提升团队的决策能力。虽然AI能快速生成草稿,但最终的判断和修改仍需依赖人类。持续维护技能并将其融入日常工作是关键,才能真正发挥AI的潜力。
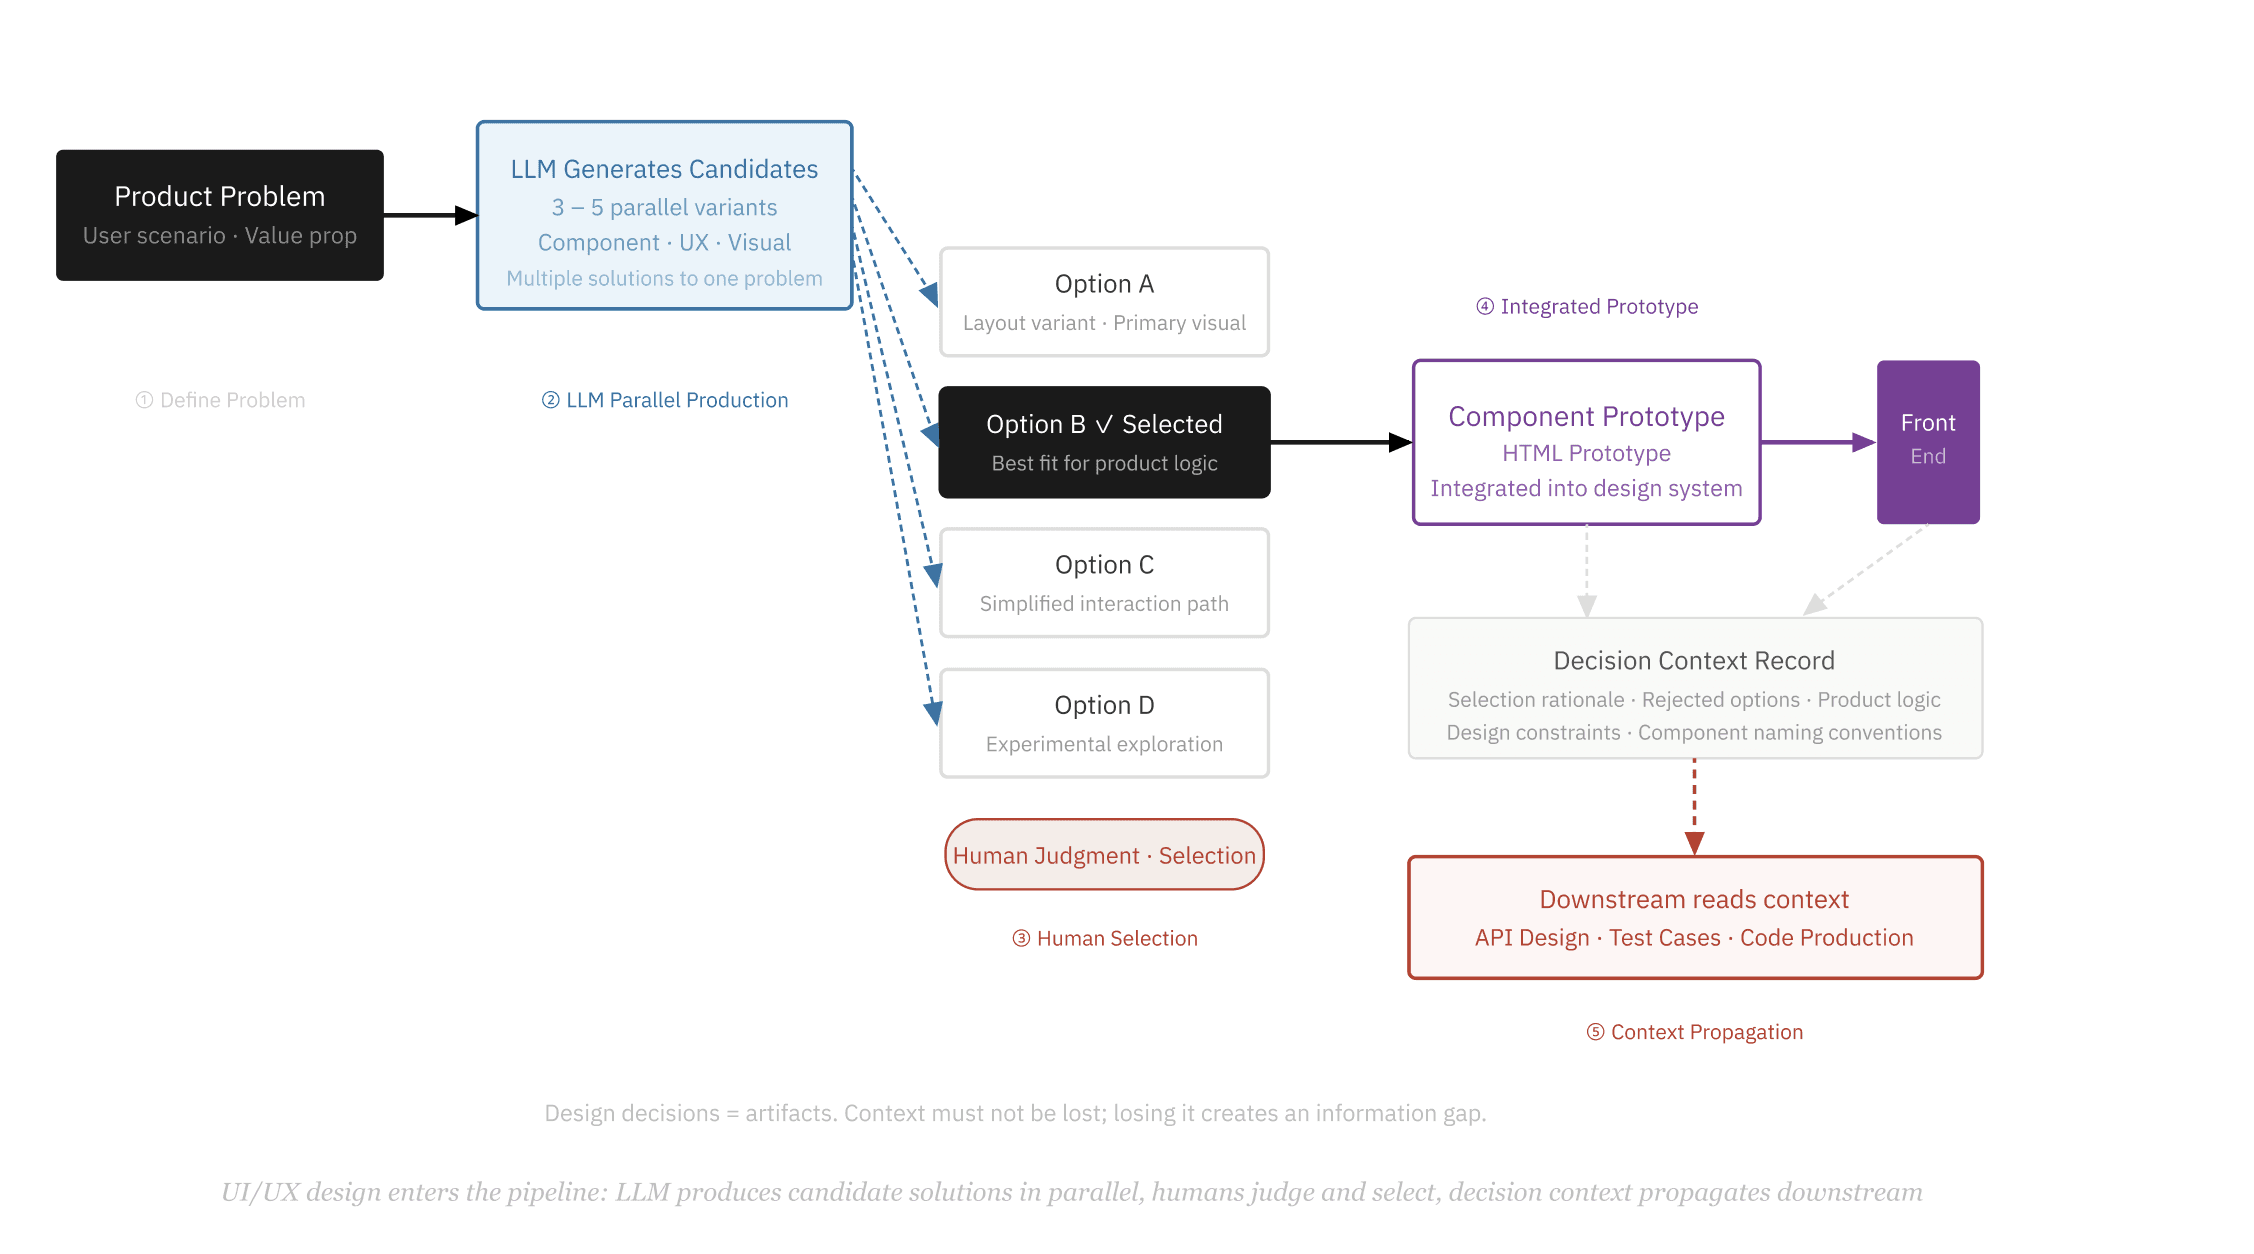
互联网发展经历了个人时代、专业化、DevOps运动和AI时代。随着复杂性增加,工作分工变得必要。AI提升了开发能力,但也带来了新的设计挑战,设计与开发紧密结合,强调人类判断的重要性。整个工程流程需要全面理解系统的人以确保质量与效率。
AI正在改变软件开发,但缺乏战略框架可能导致技术债务。Matthias Steiner强调应以规范驱动开发,确保AI生成的代码满足长期需求,避免复杂性增加。随着软件数量的增加,治理问题和维护负担加重,尽管AI加速开发,软件工程的重要性和宏观决策仍需依赖人类判断。
Peter Steinberger 在访谈中介绍了他开发的 AI 助手 Clawbot(现名 OpenClaw),能够通过多种消息平台与用户互动。他强调 AI 的强大,但指出缺乏人类判断可能导致输出质量低下。他认为未来 AI 将取代许多应用程序,成为人类生活的重要助手。
瑞安欢迎微软开发者社区副总裁斯科特·汉斯尔曼回归,讨论编码氛围及其对软件开发生命周期的影响。他强调人类判断的重要性,并探讨如何将AI作为学习工具。
LinkedIn的招聘助手通过分阶段的“计划与执行”架构,简化招聘流程并提升效率。它利用多个子代理进行候选人筛选、评估和沟通,并结合LinkedIn经济图提供市场洞察,实现招聘决策的自动化与人类判断的结合,持续改进。
AI正成为质量保证的重要工具,能够快速生成测试场景、识别风险并规划测试。有效的提示可以提高测试效率,但人类判断仍然必不可少,以确保结果的相关性和质量。AI在测试流程中作为智能助手,帮助测试人员更高效地覆盖更多内容。
尝试新事物令人兴奋,但“氛围编码”带来了安全隐患。AI生成的代码在开源项目中引发了安全担忧,维护者面临审查压力,可能影响项目质量。尽管AI加速开发,人类判断和安全措施仍然至关重要。
人工智能并非新概念,但在当今时代对组织和个人的运作、创新和成长至关重要。尽管存在安全风险,AI带来了许多新机遇,通过自动化重复任务,员工可以节省时间,提高效率和创造力。然而,了解AI的使用限制,尤其是在需要人类判断的领域,亦十分重要。安全优先的思维方式在AI时代变得必不可少,组织需谨慎采用AI,以确保其长期价值。
X推出AI笔记写手,允许开发者创建能撰写社区笔记的AI机器人。这些笔记将在被不同观点的人认为有帮助时显示。AI笔记需在“测试模式”下开始,并根据其帮助程度获得写作能力,最终的有用性判断仍由人类决定。
人机协作(HITL)代理结合了自动化与人类判断,适用于需要快速且准确的任务。HITL系统在关键时刻暂停以获取人类输入,确保输出的准确性,广泛应用于高风险领域和创意工作。设置HITL环境需要语言模型和API密钥,示例包括课程计划和财务欺诈检测代理。
本研究引入Online-Mind2Web基准,评估网络代理能力,涵盖300个任务,揭示真实能力。同时开发LLM-as-a-Judge方法,评估结果与人类判断高度一致,推动代理评估与发展。
AI检测工具用于区分人类与AI生成的文本、图像和视频内容。尽管宣称高准确率,但独立评估显示仍存在假阳性和假阴性问题。这些工具面临混合内容和复杂深伪造视频的挑战,建议结合人类判断和元数据验证以提高准确性。
通过分析与ChatGPT的互动,发现AI在决策中既能作为思维伙伴,也可能导致自动化偏见。提出了“AI决策循环”的五步法:明确决策背景、生成AI输出、应用人类判断、验证结果、迭代优化。研究表明,结构化合作能提高AI的有效性,成功率显著高于被动接受AI输出。要最大化AI潜力,需主动参与而非依赖自动化。
尽管AI辅助开发提升了工程师的生产力,但软件质量并未显著改善。开发者使用AI的方式可分为“快速构建者”和“迭代优化者”。高级工程师能有效利用AI,而初级工程师可能过度依赖,导致“纸牌屋代码”现象。AI工具的“70%问题”表明初步进展快,但后续修复困难。AI应视为学习工具,而非完全替代品,软件开发仍需人类判断和经验。
本研究结合大语言模型和层次分析法,解决开放性问题答案评估难题。通过生成评估标准和对比评分,实验结果显示该方法更接近人类判断,展现多标准评估潜力。
本文探讨了对话系统评估的统一性,分析了人工与自动评估方法,并提出建立更健全的评估协议。研究表明,GPT模型在对话评估中与人类判断高度一致,尤其在事实准确性和常识推理方面表现良好,强调了改进评估方法的重要性,以提升聊天机器人的人性化沟通能力。
完成下面两步后,将自动完成登录并继续当前操作。