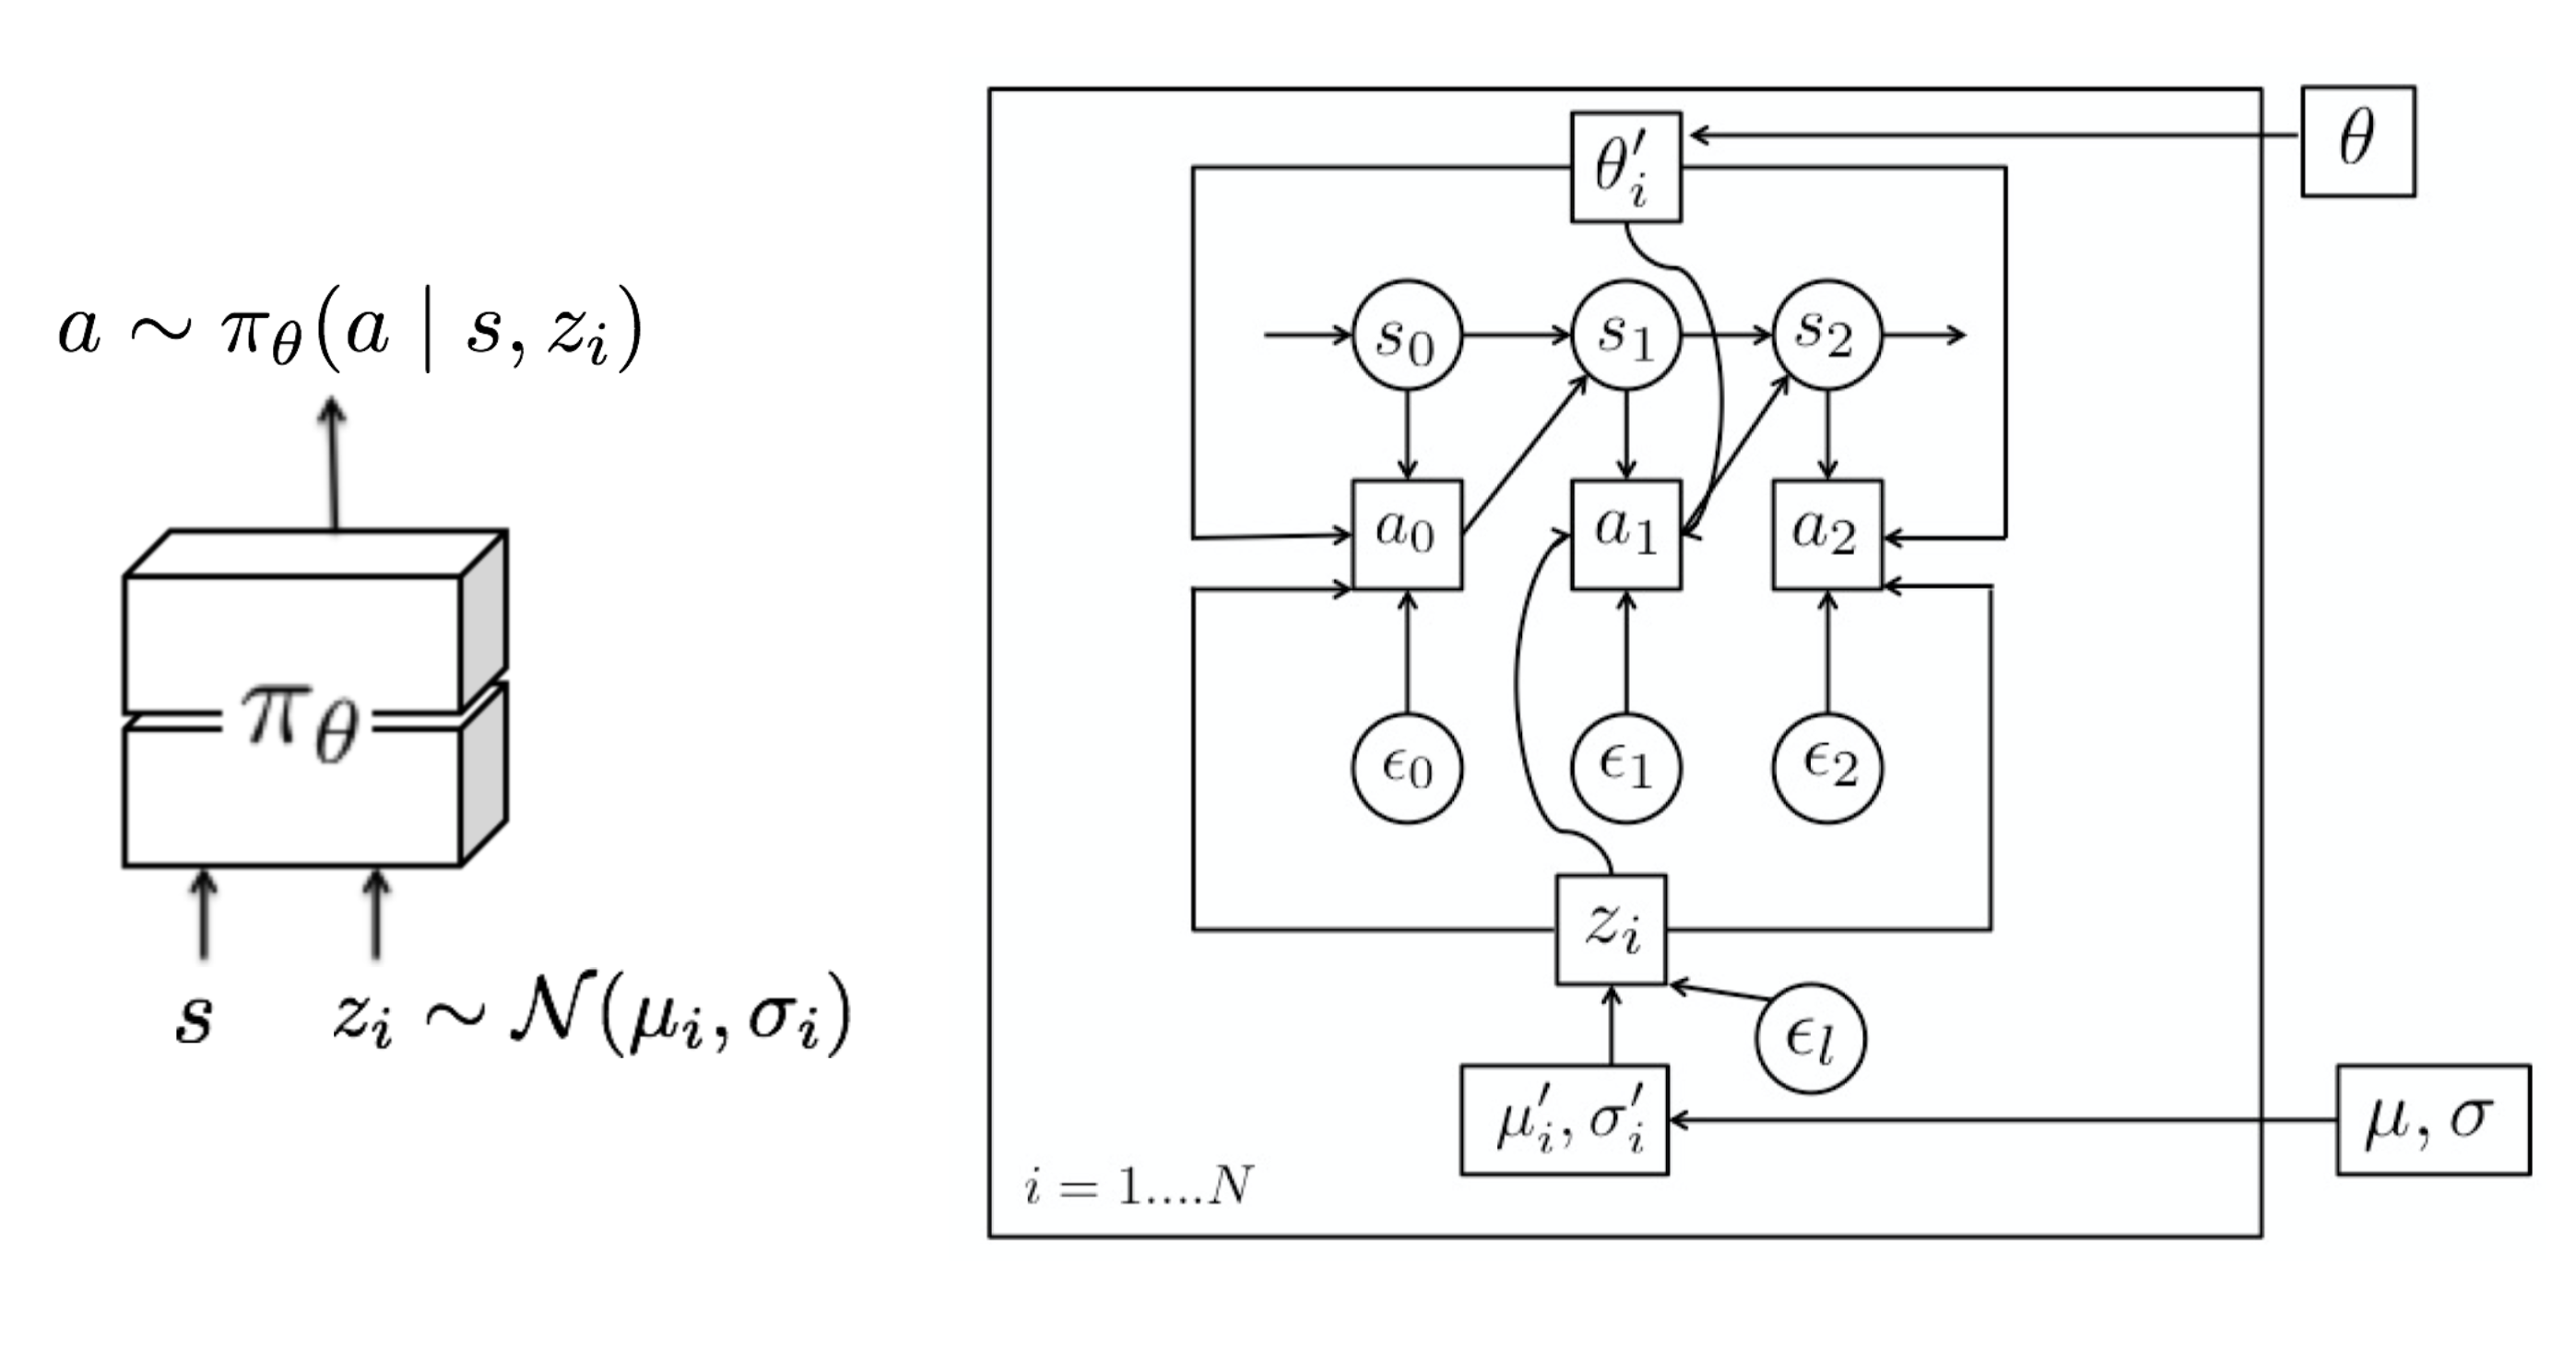
本文提出了一种基于模型的对抗元强化学习算法,通过最小化次优差异和对抗任务来寻找最优策略,从而提升算法在任务分布变化下的泛化能力和性能。实验结果表明,该算法在多个领域表现优异,具有更高的回报和样本利用效率。
元强化学习旨在训练能快速适应新任务的智能体,核心是让策略网络结合上一动作和奖励,通过循环网络记忆任务信息。训练时从MDP分布中采样任务,用梯度下降更新模型。关键组件包括带记忆的模型、元学习算法和任务分布。主要方法有MAML、元梯度RL、进化策略和情景记忆,并通过域随机化或进化算法生成任务。
完成下面两步后,将自动完成登录并继续当前操作。