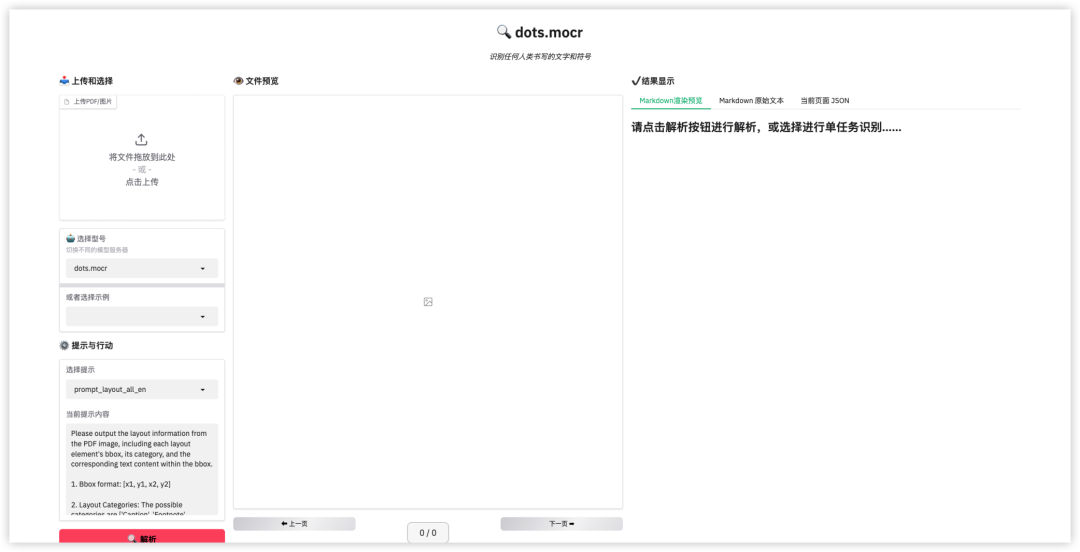
随着大模型的发展,OCR技术成为连接视觉数据与智能应用的重要工具。新一代多模态模型整合了文字识别和信息抽取等功能,推动了OCR在科研、金融和医疗等领域的应用。本文介绍了五款开源OCR模型,包括Unlimited-OCR、Chandra-ocr-2、dots.mocr、Qianfan-OCR和FireRed-OCR,适用于文档解析和手写文字处理等场景,帮助开发者选择合适的解决方案。
文旅行业酒店合同报价信息复杂且非标准化,传统人工处理效率低。本文提出基于多Agent系统的自学习方案,利用机器学习技术实现信息自动抽取,提高处理效率,减少人工干预,适用于其他文档处理场景。
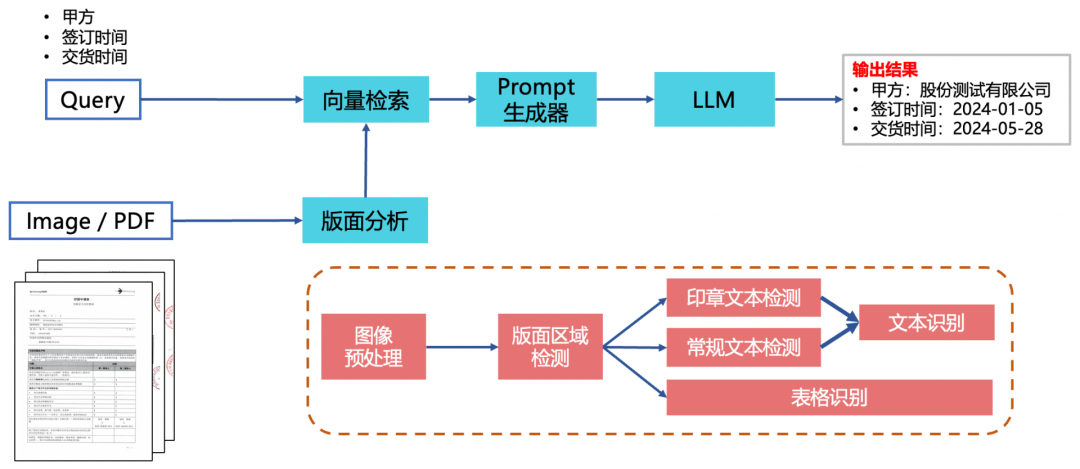
PP-ChatOCRv4是基于ERNIE 4.5 Turbo的文档关键信息抽取方案,结合OCR与大模型技术,提升信息提取的效率与准确性,适用于多行业的文档处理需求。
飞桨PP-UIE是一个支持中英文的信息抽取大模型,具备强大的零样本和小样本学习能力,能够高效处理长文本,适用于多种应用场景。
文本图像信息抽取技术在多个行业得到广泛应用。飞桨低代码工具PaddleX新增PP-ChatOCRv3,结合PaddleOCR和文心一言,实现高效的信息抽取。升级后支持多页PDF快速适配和自定义提示词,提升了信息提取的灵活性与效率。
该模型用于票证检测和矫正,广泛应用于信息抽取和证件扫描。基于真实数据训练,支持多角度和复印件判断,准确率高达99%。通过特征提取和透视变换,显著提高工作效率和准确性。
PaddleOCR 最新发布了 PP-ChatOCRv3-doc,提升了文本图像解析能力,信息抽取效果提高6%。新增7个实用OCR基础模型,支持低代码全流程开发,简化模型使用,兼容多种硬件,提供高效的模型组合与定制,助力行业应用推广。
本文介绍了通用信息抽取大型语言模型(GIELLM),该模型通过统一架构整合多种信息抽取任务,显著提升了性能。实验结果表明,GIELLM在多个数据集上超越了GPT-3.5-Turbo,验证了互相增强效应(MRE)的有效性,推动了信息抽取任务的统一处理。
该研究探讨了知识图谱在信息抽取中的应用,介绍了多种知识图谱补全方法,包括基于嵌入式网络、预训练语言模型和信息检索的模型,旨在提升链接预测和结构学习的性能,并提出了加速模块和评估方法的改进方向。
本研究提出了一种多任务学习方法,结合句子分类和命名实体识别,以提升信息抽取的性能。引入通用信息抽取大型语言模型(GIELLM),首次同时处理多种子任务,实验证明其在多个数据集上表现优异,标志着信息抽取的新范式。
本文汇总多项信息抽取研究,包括提出WebIE数据集及三种训练策略以提升跨域跨语言性能,设计轻量级特征无关IE范例,构建多特征融合网页文本提取算法,提出三阶段联合学习框架,研发文档级实体提取、医学实体抽取、网络安全实体标注等方法,并发布HealthE数据集与EPS-BERT模型,F1值显著提升。
该文综述视觉文档理解的多模态预训练进展,涵盖FormNetV2、Bi-VLDoc、DocFormerv2、StrucTexT等模型,采用图对比学习、双向视觉语言监督、多粒度Transformer等策略融合文本、视觉与布局信息,在FUNSD、CORD、SROIE等基准上取得最优性能,并应用于信息抽取、表格理解与多模态摘要。
该文综述文档理解领域的多模态预训练模型,包括LayoutLM、LayoutLMv2、LayoutXLM、MarkupLM、LAMPreT、VaLM等,通过联合建模文本、布局与图像信息,在表单理解、信息抽取、文档分类等任务上超越强基线,并展望多模态学习挑战。
本文综述生成式大语言模型在信息抽取中的最新进展,按子任务与学习范式分类,分析新兴趋势与技术洞见。研究涵盖指令式抽取、通用抽取模型GIELLM、代码提示方法及表格抽取等,发现性能不仅取决于模型规模,还依赖架构、数据多样性与学习技术,并指出未来方向。
该文综述文档AI与视觉语言模型进展,涵盖DocVQA、DUDE等数据集,Bi-VLDoc、DocFormerv2等文档理解模型,LVIS-Instruct4V、InstructCV、Instruct-Imagen等视觉指令与生成方法,以及基于指令的信息抽取任务InstructIE。
Code4UIE是一种用于信息抽取任务的通用检索增强代码生成框架,采用Python类定义任务特定模式,并利用上下文学习机制指导LLMs生成恰当的代码。Code4UIE在多个数据集上进行了广泛实验,证明了其有效性。
完成下面两步后,将自动完成登录并继续当前操作。