miniCOIL EN-ES是首个双语稀疏神经检索器,能将英语和西班牙语中意思相同的词(如home与casa)映射到稀疏向量的同一概念槽位,无需翻译即可用单一倒排索引跨语言检索。模型基于multilingual-e5-small,用MUSE词典构建约1.2万概念,实际训练2398个概念头,并保留BM25回退。评测显示单语检索略有提升,跨语言检索召回率优于翻译加BM25,但排序精度稍逊。
作者为Hugo博客开发了纯前端离线全文搜索方案:构建时用Python和jieba生成倒排索引,拆分为核心与正文两层并按需异步加载;倒排表采用Base-32差值编码压缩,并处理技术词汇、繁简转换与拼写容错;索引使用固定URL加条件请求,避免全站页面缓存失效。该方案无需服务端,部署即可搜索,适合中小型静态博客。
本文介绍Postgres全文搜索的倒排索引原理:以词项为键映射到文档ID的倒排列表,支持并集、交集快速查询;包含词项字典、倒排列表及可选的位置和词频数据,用于短语查询和BM25评分;索引通过分词、词干化、停用词处理构建,采用分段存储、合并和墓碑机制应对增删改;在Postgres中需处理ctid、WAL、VACUUM、事务可见性及查询规划等集成问题。
本文探讨了倒排索引遍历的P-完全性,指出标准查询评估在处理复杂布尔查询时面临指数级时间或空间开销。作者提出ComputePN算法,通过正负双表示和DAG记忆化,将评估时间限制在O(|Q|·|U_active|),避免树展开和全量扫描,为计算检索奠定理论基础。
本文是「全文检索引擎」系列的第一篇,探讨了倒排索引的架构与实现,分析了Lucene与Elasticsearch的关系,阐述了文本如何处理成可搜索的词项,以及查询在倒排列表中的执行方式。文章还区分了不同类型的搜索引擎,强调了全文检索引擎在文本与查询处理中的复杂性和重要性。
本文探讨了Apache Lucene中有限状态转换器(FST)在段文件中的作用,如何通过词典快速定位倒排索引的postings。FST通过共享前缀压缩词典,减少内存占用,并支持高效查找与遍历。文章比较了Lucene的词典结构与PostgreSQL的GIN Entry Tree,强调两者在存储引擎假设上的不同,并讨论了FST的实现细节及其在查询中的应用。
本文探讨了全文检索引擎的架构,重点分析了Lucene和Elasticsearch的设计与实现,包括倒排索引、文档模型、分析链、BM25打分机制和近实时刷新等关键概念,适合搜索引擎工程师和研究生深入理解搜索系统的内部运作。
搜索引擎的倒排索引需要高效的整数压缩以节省存储和提高查询速度。文章介绍了多种压缩算法,如varint、PForDelta、SIMD-BP128和Roaring Bitmap,分析了它们的优缺点及应用场景。选择合适的算法需考虑数据特性和性能需求。
某电商平台的搜索系统从MySQL迁移到Elasticsearch,查询延迟从800ms降至15ms,但分片数激增至8000,导致超时率上升。文章探讨了生产级搜索系统的架构组件,强调倒排索引的重要性,并介绍了查询解析、分词、分布式索引等关键环节。还讨论了分片策略、相关性排序及Elasticsearch集群架构,指出运维挑战如分片膨胀和映射爆炸,最后提出了搜索系统的整体架构和优化策略。
GIN索引是一种倒排索引,适用于可变数量值的对象,常用于索引数组类型列,便于查找特定值的数组。对于JSON,GIN索引适合精确查找项值,如查找“item_name”等于“laborum”的对象。
本文介绍如何用 Python 构建简单搜索引擎,重点在倒排索引、文本切分和权重系统。通过实现精确、前缀和 N-gram 三种切词方法,结合权重计算,提高搜索结果的相关性和准确性。最终实现的搜索引擎代码简洁,逻辑清晰。
Elasticsearch 是一个支持高可用性和可伸缩性的分布式搜索与分析引擎,通过集群、节点、索引和文档等概念实现数据存储与检索,利用倒排索引加速搜索过程。
倒排索引是搜索引擎的核心,通过关键词快速检索文档,适合全文搜索。PostgreSQL中的GIN索引加速全文搜索,支持复杂数据类型,并具备压缩特性,节省存储空间。
Apache Doris的索引系统包括前缀索引、倒排索引、ZoneMap索引和BloomFilter索引。前缀索引通过排序快速定位数据,倒排索引支持全文检索,ZoneMap索引利用统计信息跳过无关数据块,BloomFilter索引加速等值查询和LIKE查询。了解这些索引的原理和应用场景有助于优化查询性能。
作者最初计划爬取整个互联网以建立搜索引擎,但意识到过于雄心勃勃,最终决定为自己硬盘上的PDF文档构建搜索引擎。通过提取文本、使用OCR技术、清理数据并建立倒排索引,成功实现了搜索功能,尽管与谷歌相比还有差距,但成功管理了自己的文档库。
倒排索引是一种数据结构,通过将唯一词汇映射到相关文档,快速定位包含特定词汇的文档,显著提高搜索效率,广泛应用于搜索引擎和数据库。
传统数据库通过表扫描查找搜索词,效率低。搜索优化数据库利用索引、词干提取和分词技术提升查询速度,构建倒排索引。分词将词语简化为词根,词干提取将任务分解为单词,帮助映射到相关文档。倒排索引将词语映射到包含它们的文档。许多搜索优化数据库支持模糊搜索,处理拼写错误。ElasticSearch是其中一种流行的搜索优化数据库。
搜索引擎通过索引和检索算法快速找到信息。Apache Lucene是一个用Java编写的开源库,是ElasticSearch和Solr的基础。Lucene的搜索技术包括查询预处理、倒排索引搜索、文档评分和结果排序。查询经过分词、标准化、去除停用词和词干提取,然后根据TF-IDF权重检索相关文档,并按得分排序显示最相关结果。
该研究比较了HNSW、Flat和倒排索引三种常见的检索方法,分析了它们在性能、内存使用和索引构建方面的权衡,并提供了选择每种方法的指导。HNSW适用于高维数据和快速近似搜索,Flat适用于较小的数据集或内存受限的应用,倒排索引适用于大型文本语料库的精确关键词检索。该论文为开发人员和研究人员提供了有价值的操作建议。
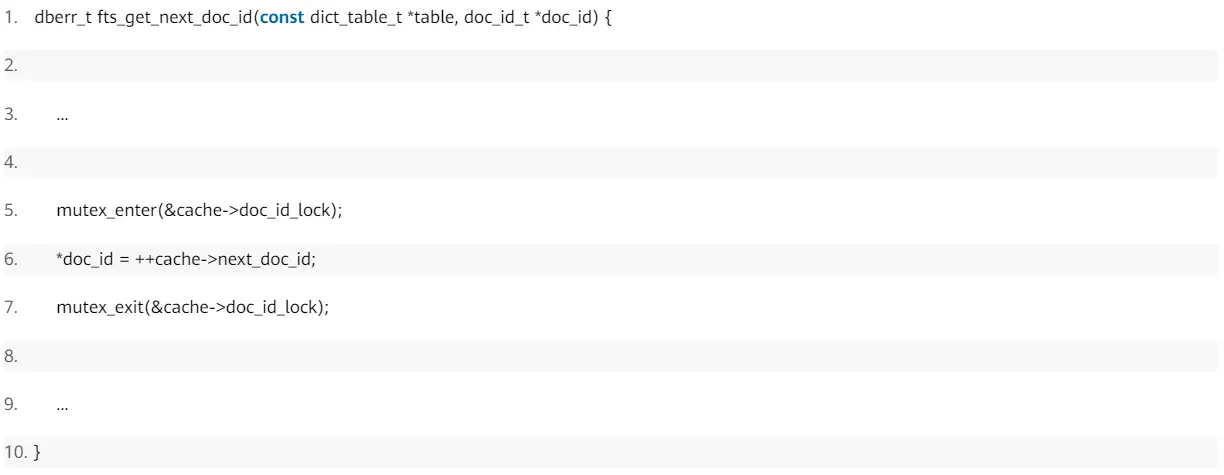
本文介绍了MySQL中的全文索引及其插入过程。全文索引基于倒排索引,支持关键词搜索文档。插入时,文档分词并缓存,分为写入行记录、事务提交和刷脏三个阶段。事务提交时,分词结果添加到缓存,达到阈值后刷新到磁盘,系统崩溃后可恢复缓存数据。
完成下面两步后,将自动完成登录并继续当前操作。