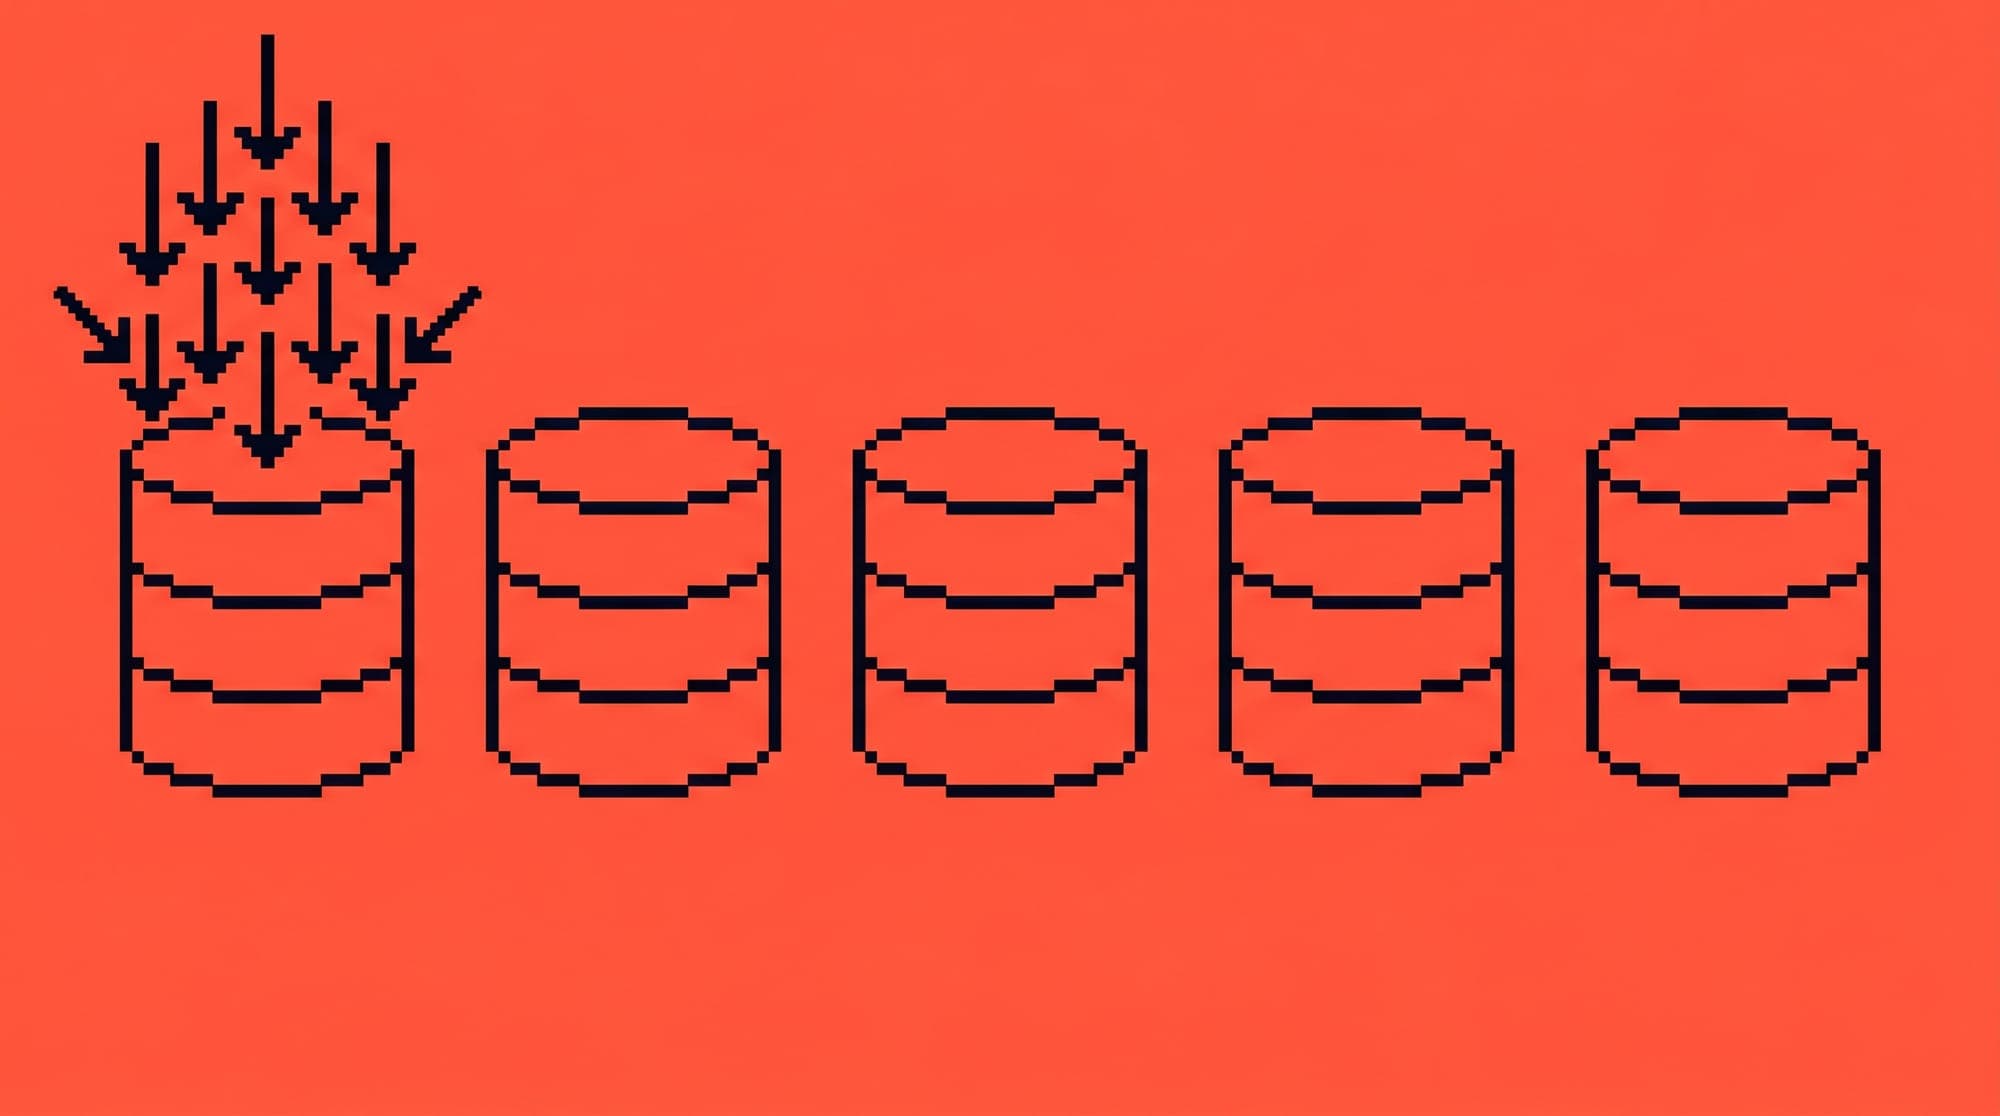
PostgreSQL的分区键可能导致写入瓶颈,偏斜的分区键会使80%的写入集中到一个分区。需要诊断热区并在架构层面进行修复。
本文横向对比主流数据库的 MVCC 实现:PostgreSQL 采用堆表追加式、由旧到新的版本链,InnoDB 采用 undo 增量、由新到旧的版本链,TiKV 将版本编码进键。三者可见性规则等价,但快照隔离会放过写偏斜;PostgreSQL 用 SSI 在线检测危险结构实现可串行化,代价是误杀。长事务会拖住回收水位,导致版本膨胀。
本文探讨了个性化联邦学习在非独立同分布数据中的应用,强调其在隐私保护和多方合作中的重要性。研究提出了多种方法,如FedNH和FedMLP,以应对数据异构性和个性化问题,并总结了当前研究进展与未来挑战。
本文介绍了数据转换在数据科学中的重要性,重点讨论了处理偏斜数据的方法。通过Ames房屋数据集中的'SalePrice'和'YearBuilt'属性的示例,演示了正偏斜和负偏斜数据的处理,并介绍了几种常用的转换方法。文章强调了选择适当的转换方法的重要性,需要考虑数据特征、偏斜程度、统计属性、可解释性和分析目标等因素。
完成下面两步后,将自动完成登录并继续当前操作。