本文是湖仓引擎系列最后一篇,介绍存储抽象与访问层:定义Backend接口(Put/Get/Delete/Exists),实现本地文件系统与S3两种后端,并通过构造函数注入使引擎不依赖具体存储;元数据位置与数据位置相互独立,可分别存放于Postgres和S3,便于DuckDB、Spark、pandas等多引擎共享同一目录;提供CLI REPL,支持建表、插入、扫描、删除、时间旅行等命令;开放表格式由标准Parquet、SQL元数据和约定三部分组成。
湖屋中的Parquet文件不可修改,模式演进通过元数据实现:每列创建时分配不可变字段ID并写入文件,读取时按ID映射,无需重写数据。新增列分配新ID,旧文件缺失该ID则填NULL;删除列仅设结束快照,保留历史以支持时间旅行;重命名列不改ID,旧文件自动适配。模式版本仅在结构变更时递增,以保证同版本文件可安全合并。
湖仓系统第三阶段写入管道中,INSERT 先将数据写入 Parquet 文件并收集列统计,再原子注册到元数据目录。核心原则是先写文件后更新元数据,确保崩溃时仅产生孤儿文件,避免元数据指向缺失文件。事务提交时创建新快照,记录写入文件、列统计与审计日志。
2026年4月,微软、亚马逊、戴尔和Snowflake集中公开或授权了四件NL2SQL专利,均将自然语言转SQL从提示词工程转向结构化中间层,例如先生成实体关系图或数据目录。竞争焦点已从“会写SQL”变为“元数据与校验是否足够厚”。生成层已被大厂占据,但判断SQL是否真正回答问题的校验层仍属空白。个人可构建金标准问题集与自动回归校验,创业机会包括查数质检服务和校验插件。
澳大利亚Nine Entertainment旗下流媒体Stan部署Bitmovin的AI场景分析技术,自动生成场景级元数据以优化视频点播流程。该技术集成于VOD编码器,可提升个性化体验、精准广告投放和广告位识别效率。Stan拥有超1.7万项资产,此举减少人工审核并助力内容盈利。Bitmovin将在IBC展会展示该技术。
DuckLake是一种基于DuckDB扩展的湖仓格式,将元数据与数据分离:目录(本地文件或PostgreSQL)存储表结构、快照和文件指针,Parquet文件存储实际数据。支持本地运行及PostgreSQL+MinIO生产部署,通过分区将文件组织在S3中。查询时利用目录中的列统计进行分区剪枝和谓词下推,可跳过无关文件,显著提升查询效率。
Anthropic数据团队将95%业务分析交给AI,准确率达95%。核心方法:建立标准数据层、维护元数据、用Skill提供操作手册、持续评测验证。关键发现:查数难点在上下文映射而非SQL生成,历史SQL直接检索无效,数据治理因AI更重要。建议从少量标准数据集、薄Skill和几十个测试问题起步。
本文介绍MrDocs文档工具的重大更新:用自研MrDocs.Describe替代Boost.Describe,实现元数据通用比较与序列化;新增Lua/JavaScript脚本扩展、数据驱动生成器及宏支持;修复模板特化、文档注释等多项缺陷;并维护Boost.StaticString库。
本文介绍Ceph BlueStore架构,替代FileStore解决双写与目录元数据问题。核心组件包括BlockDevice(裸盘I/O)、BlueFS(RocksDB专用文件系统)、RocksDB(对象元数据存储)和Allocator(空闲空间管理)。BlueStore将数据直写裸盘,元数据存KV,支持校验和与压缩,但面临compaction带宽竞争和挂载延迟等挑战。
CephFS将POSIX文件系统构建于RADOS之上,MDS作为可恢复状态机,通过journal持久化元数据。其核心挑战包括:MDS故障恢复、capability机制维持客户端缓存一致性、多active MDS的subtree迁移可能引发thrashing,以及fsync/stat操作的高网络往返成本。相比RBD,CephFS在元数据面(journal、caps、subtree、dirfrag)付出更高代价,快照需客户端协作,性能与一致性权衡复杂。
流媒体时代音乐发现困境源于算法同质化与单曲消费,建议建立“音乐探索系统”:通过算法、社区、榜单发现,用乐评筛选,延伸探索制作人与关联作品,并用元数据建立个人音乐地图。推荐RYM、Discogs等工具及人工推荐渠道,强调系统化探索以突破茧房。
HDFS FsImage是NameNode的元数据快照,记录文件系统目录树和块映射。核心流程包括加载和保存,采用Protobuf格式,支持并行处理。加载时通过LoaderDelegator自动检测新旧格式,保存时按固定顺序写入各section。系统包含压缩管理、存储检查、HTTP传输和离线查看工具,配置参数可控制压缩和并行加载行为。
Java中的注解为程序元素(如类、方法等)提供元数据。CodeQL数据库支持对注解及其元素的查询和分析,能够识别缺失的注解或调用已废弃的方法。使用@SuppressWarnings可以抑制警告,而@Override用于标记覆盖方法。
Plaud的AI记笔记产品在数据架构上面临挑战,因结构化元数据与非结构化内容分离,导致实时一致性缺失。随着用户量增加,数据库限制影响了产品更新和功能发布。最终,Plaud将元数据层整合到分布式SQL数据库中,解决了架构债务,恢复了在线模式,确保了产品的可靠性。
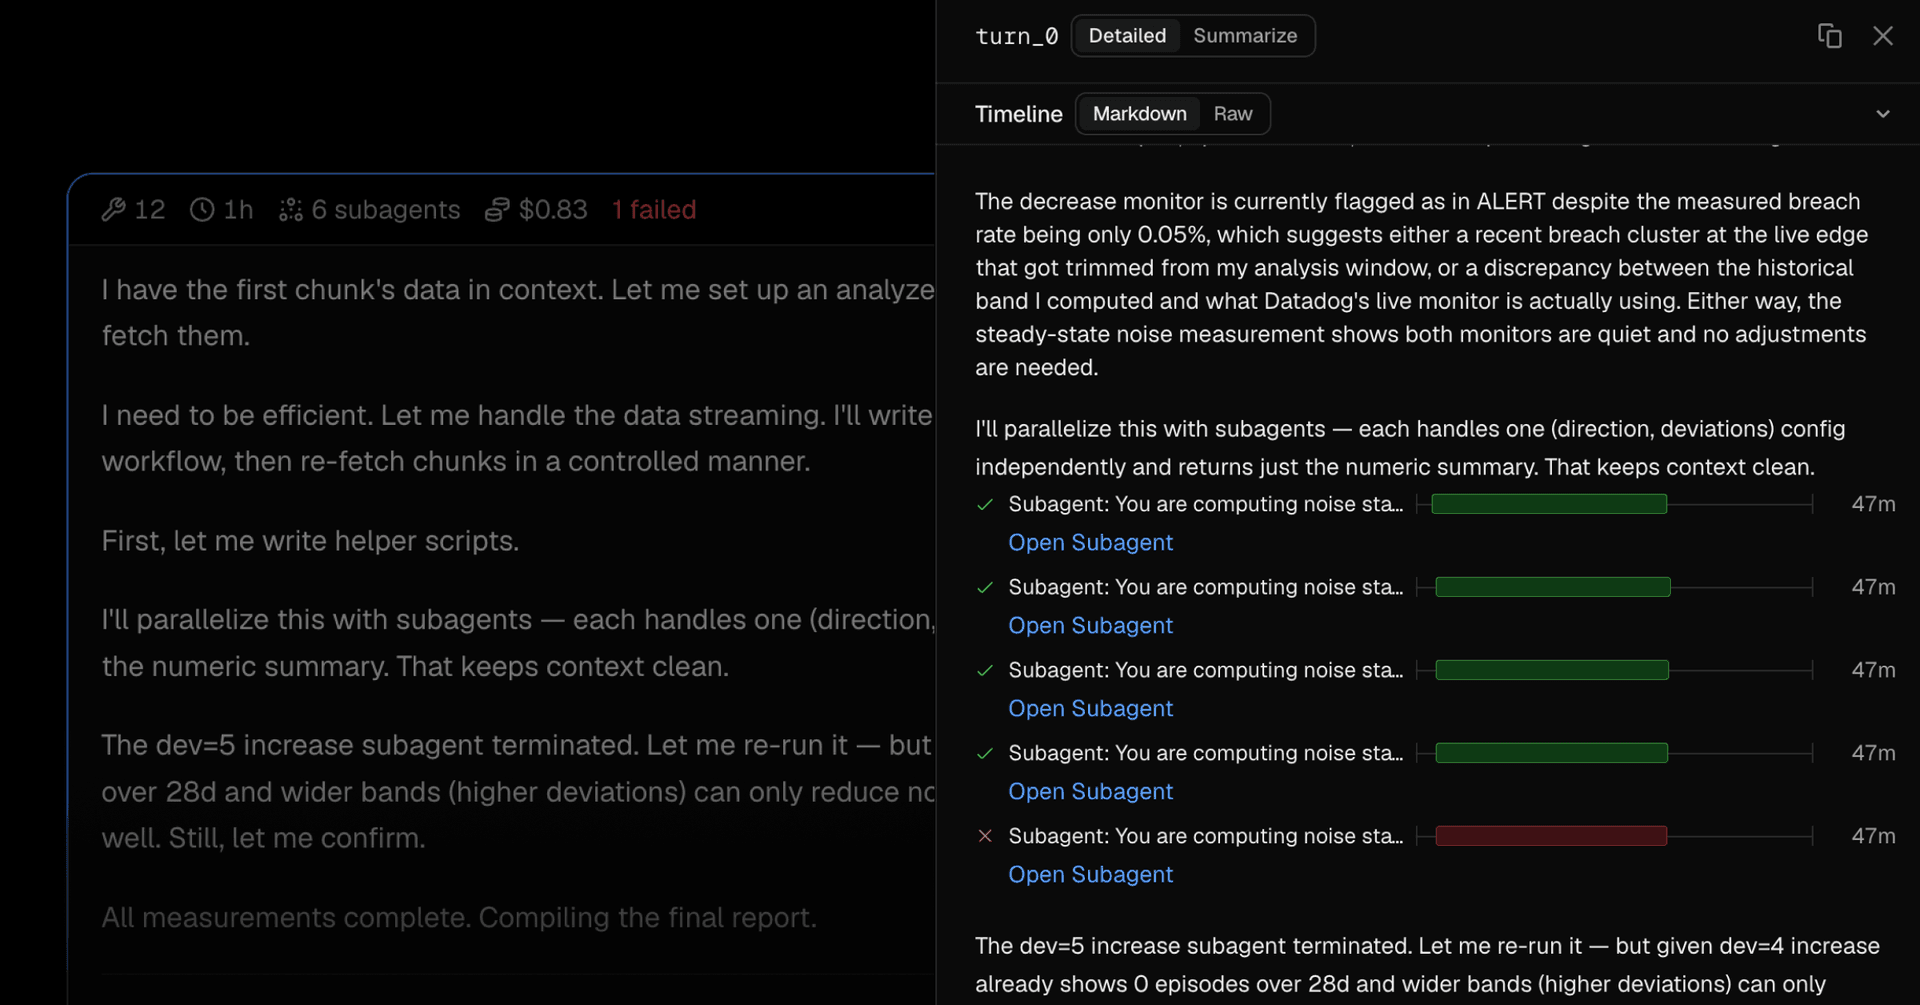
现在可以在代理运行中检查eve项目的子代理活动。新的子代理标签按启动的回合组织每个子代理,显示提示、持续时间和任何失败信息。点击子代理可查看其运行详情,包括回合、工具调用、元数据、成本和令牌使用情况。
本文探讨了Trino查询引擎的执行流程,包括分析、计划、分片和调度等阶段,重点介绍了Iceberg表的元数据处理及其对查询性能的影响。通过分析SqlQueryExecution的生命周期,阐明了SQL查询如何转化为分布式执行计划,并强调了EXPLAIN和EXPLAIN ANALYZE的使用,以优化查询效率。
本文讨论了 Git 中的索引结构及其与工作区和 HEAD 的关系。介绍了文件的角色、操作对索引的影响、冲突阶段及扩展节。索引记录路径、元数据和对象 SHA,合并冲突时同一路径可出现多个条目。扩展节包含缓存结构和冲突信息,以加速操作。最后提到索引与工作区的一致性及未来版本的参考。
本文介绍了如何使用JavaScript构建一个基于浏览器的PDF分析器。该工具支持用户上传PDF文件,预览页面,配置分析选项,并提取文档的元数据、文本统计和安全设置等信息。分析过程在本地进行,确保隐私和安全,用户还可以将分析报告导出为PDF、JSON和CSV等多种格式。
本文探讨了Parquet文件的结构与性能优化,包括数据的物理切分(行组、列块、页面)、元数据存储方式,以及通过裁剪元数据(如列索引、偏移索引、布隆过滤器)提高查询效率。Parquet采用“先写数据、后写元数据”的设计,文件尾部包含所有统计信息,支持高效的谓词下推和投影下推,显著减少读取数据的IO量。
Iceberg通过四层不可变元数据树解决了对象存储中的目录管理问题。这四层分别存储表的状态、快照信息、manifest列表和数据文件,确保原子提交和快照隔离。查询时,Iceberg利用元数据快速定位数据文件,避免了传统方法中的高成本LIST操作,并支持高效的分区裁剪和文件裁剪,提升查询性能。
完成下面两步后,将自动完成登录并继续当前操作。