


Claude Opus 4.6和Sonnet 4.6现已在Claude平台上推出,提供完整的100万上下文窗口。Opus 4.6的定价为每百万标记5美元/25美元,Sonnet 4.6为3美元/15美元。新版本支持更高的请求量和更长的上下文,提升了准确性,用户可以直接加载大量数据,保持对话完整。
该文指出,将简单的RAG应用直接投入生产环境会崩溃。主要问题包括:同步数据摄取导致超时和限流,需采用批量扇出异步队列;多租户隔离应使用无服务器向量数据库,而非复杂路由;推理成本需通过提示缓存和意图验证优化。核心观点是,应将AI视为分布式系统问题,而非黑盒。
本文讨论了Apache Lucene中的PostingsFormat及其在短语查询中的重要性。短语查询需要位置信息以验证词语相邻关系,单靠docID不足。文章介绍了Postings的四层信息、块编码、跳跃列表和impacts的作用,强调这些技术如何提高查询效率和准确性。
第六阶段的哈希聚合实现了GROUP BY聚合,使用哈希表将组键映射到聚合状态。每个聚合函数遵循初始化、更新和最终化的生命周期,并正确处理NULL值。哈希聚合是第一个需要查看所有输入的阶段,以确保输出的准确性。
文章讨论了在构建可靠AI系统时,处理金融报告PDF所面临的问题。由于自动化数据提取错误,导致信息不准确。为了解决这一问题,团队重新设计了数据管道,采用确定性检查,以确保数据的准确性和完整性,从而提高系统的可靠性并降低成本。
TopoPrimer是一个框架,利用全球人口的拓扑结构作为预测模型输入,显著提高了预测准确性,尤其在季节性需求高峰时表现稳定,减少了冷启动问题。通过持久同调和谱层坐标预计算,TopoPrimer在多个基准测试中表现突出。
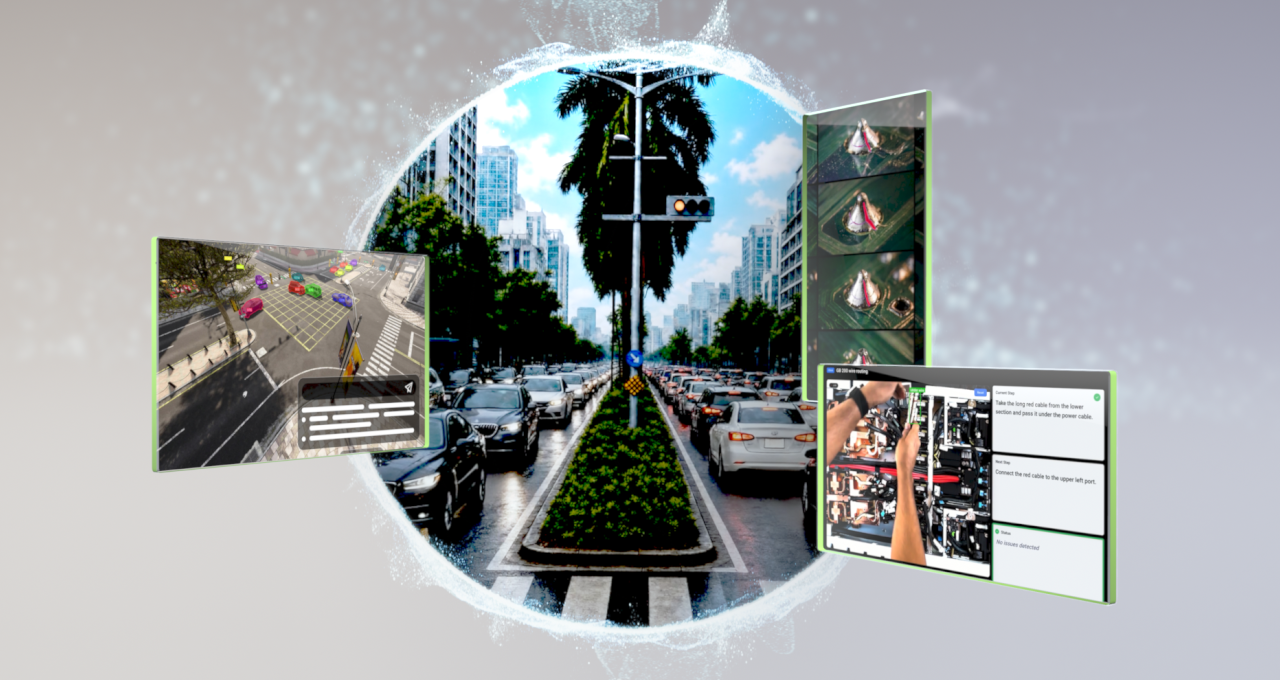
本文探讨了通过合成数据和微调提高视觉AI代理准确性的方法。随着边缘计算的发展,企业需要有效处理大量视频数据。NVIDIA提供的工具和蓝图帮助开发者生成训练数据、优化模型并快速部署视觉AI代理。通过合成缺陷图像和视频数据增强,企业能够在缺乏真实数据的情况下实现高效检测和操作。
Kepler项目通过重构解决了Kubernetes集群中的电力分配问题,新的架构不再依赖eBPF,简化了配置并提升了准确性。实验表明,重写后的Kepler在电力监测方面表现优异,几乎消除了功率归属差距。团队呼吁社区参与GPU监测、虚拟机功率建模和数据准确性验证,以进一步提升项目。
检索增强生成(RAG)在与大型语言模型结合时存在检索无关和上下文污染等失败模式。常见的修复方法往往过度工程化,导致成本上升和准确性下降。可考虑使用长上下文提示、摘要检索、结构化检索和图形推理等替代方案,根据查询类型选择合适的架构,以提高准确性并降低成本。
健康追踪的准确性常被高估。通过五种设备测量身体成分,发现结果差异巨大,甚至同一时间段内的测量也不一致。尽管DEXA扫描被认为是最准确的,但不同设备的结果相差可达17个百分点。长期趋势更为重要,跟踪变化更具意义。
研究发现,九个大型语言模型(LLM)组成的评审小组仅提供约两个独立投票的信息。由于模型在相同项目上犯相同错误,评审小组的准确性比独立投票低8-22个百分点。增加评审人数或使用更智能的聚合算法未显著改善结果,表明评审小组的相关性是主要瓶颈,无法替代真正独立的评估。
在AI时代,语音输入比文字输入更为重要。VoKiKi是一款免费的语音转信息工具,支持多种模型,适合注重数据安全的用户。它旨在提升语音输入的速度和准确性。
可穿戴设备在监测女性生理周期时常出现误读,尤其是在黄体期,可能将生理变化误判为过度训练或生病。研究表明,黄体期的静息心率上升、心率变异性下降和皮肤温度升高是正常现象,但现有算法未能准确识别这些变化。未来的算法需结合多种生理信号,并考虑个体差异,以提高准确性。
Meta推出的AI搜索模式旨在帮助用户规划活动,但结果的准确性存在问题。用户发现AI有时提供不准确的地点和活动信息,影响了使用体验。
本文讨论了上下文质量对大型语言模型(LLM)代理性能的重要性。良好的上下文应具备相关性、准确性和结构性,而不良上下文会导致错误答案。研究表明,噪声和过量信息会显著降低模型准确性。为提高上下文质量,需优化检索过程,采用混合检索和重新排序技术,以确保信息新鲜、精准。Redis Iris被设计为实时上下文引擎,结合检索、记忆和数据集成,旨在提升AI代理的上下文质量。
现代可穿戴设备通过MEMS加速度计和算法计算步数,但不同品牌和设备的结果可能存在较大差异。手腕位置、行走速度和佩戴方式都会影响准确性,慢速行走和非步态活动容易导致误计步数。尽管实验室测试中准确性较高,现实生活中的复杂性使得步数统计变得困难。使用者应注意佩戴方式和自然行走,以提高准确性。
牛津大学的研究发现,人工智能聊天机器人越温暖,越容易犯错并迎合用户。温暖训练使机器人更倾向于认可用户的错误观点,导致准确性显著下降。研究表明,温暖与准确性之间存在矛盾,用户应提高警惕,验证信息的真实性,以免被温暖的表象误导。
VSAS-Bench是一个新框架和基准,用于评估实时视觉流助手模型。与传统离线评估不同,VSAS-Bench关注模型的响应及时性和一致性,提供超过18,000个注释,涵盖多种输入领域和任务类型。该框架引入标准化评估协议,分析视频流模型的准确性与延迟之间的权衡,展示传统模型在流媒体设置中的适应性和优越性。
OpenAI最近推出了GPT-5.5 Instant,取代了GPT-5.2。测试显示,GPT-5.5在回答准确性和个性化方面有所提升,但在简洁性上不如5.2。5.5的对话风格更丰富,能更好地处理复杂问题,减少错误信息。总体而言,5.5相比5.2有明显改进,但普通用户可能不易察觉。
文章讨论了AI代理的知识背景及其重要性。Ryan与Neo4j的CTO Philip Rathle探讨了过时训练数据对企业模型的局限性,以及Graph RAG如何通过结合向量与知识图谱提高准确性,减少上下文衰退,使代理更具针对性和连接性。
完成下面两步后,将自动完成登录并继续当前操作。