艾利特机器人在2026中国工博会上以“一脑多形·智链无界”为主题,基于自研“元启Primo”工业级具身大模型,展示协作、复合、轮式人形三大产品矩阵,设四大分区呈现八大解决方案,覆盖光基建、智能装配、生物制药等场景,并连续五天举办主题路演。
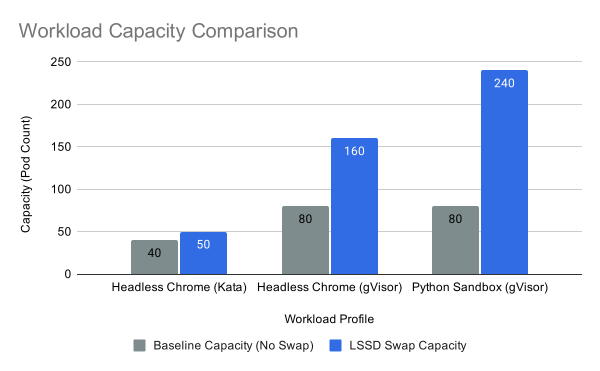
Kubernetes v1.34 起正式支持节点交换分区。使用 NVMe SSD 作为交换设备,可将闲置内存换出,显著提升 Pod 密度。测试表明:内核编译内存限制降低 50% 无性能损失;Python 沙箱并发从 80 增至 240,密度提升 3 倍,延迟主要源于 CPU 竞争而非交换 I/O。建议配置 LimitedSwap 并采用 Burstable QoS。
PostgreSQL 按租户列表分区时,若仅靠行级安全策略过滤租户,规划器无法预知租户,需扫描全部分区。实测1000租户查询从0.25毫秒增至77毫秒,3000租户达241毫秒,并产生数千锁,32并发下大量报共享内存不足。修复方法:查询中显式加tenant_id条件;添加租户改用CREATE TABLE加ATTACH PARTITION。
多租户SaaS的PostgreSQL索引应将tenant_id放在首位。实测200万行、1000租户数据:复合索引(tenant_id, issued_on)查询最快,小租户0.28毫秒、大租户0.09毫秒;其他顺序则一方快一方慢。行级安全不改变计划,但预编译语句会因租户非参数而冻结计划,导致性能骤降,需显式传参。分区不提升查询速度,但便于删除大租户数据。
在GPUStack生态大会上,CTO梁胜提出大模型时代GPU虚拟化与分区是否仍重要的问题。HAMi社区成员认为,模型规模增大与GPU分区重要性提升可以并存,二者并不矛盾。
Databricks Runtime 18 推出按需状态重分区功能,允许有状态流查询在不丢失检查点状态的情况下调整分区数。此前分区数在创建检查点时固定,修改无效,只能重建状态。新功能通过停止、设置 spark.sql.streaming.stateStore.partitions 并重启,安全地重新分配状态,适用于聚合、连接、去重等场景,Coveo 借此将 S3 API 成本降低 40%。
CAP定理指出,分布式系统在一致性、可用性和分区容错性中只能同时保证两项。由于网络分区不可避免,实际选择是在分区时偏向一致性(CP)或可用性(AP)。CP系统优先正确性,AP系统优先可用性。真实系统如Cassandra、DynamoDB提供可调一致性,设计时应根据数据特性和故障影响权衡。
Postgres大表会导致性能问题,如删除操作超时、复制延迟和停机。解决方案包括分区、垂直扩展和分片。分片将表分布到多个集群,解决真空延迟、备份慢、索引过多和宽表问题,并避免事务ID耗尽。分片是处理大表的最佳方案,但需选择正确的分片键。
CephFS将POSIX文件系统构建于RADOS之上,MDS作为可恢复状态机,通过journal持久化元数据。其核心挑战包括:MDS故障恢复、capability机制维持客户端缓存一致性、多active MDS的subtree迁移可能引发thrashing,以及fsync/stat操作的高网络往返成本。相比RBD,CephFS在元数据面(journal、caps、subtree、dirfrag)付出更高代价,快照需客户端协作,性能与一致性权衡复杂。
本文介绍如何利用桌垫整理小桌面,使其整洁实用。作者强调分区和操作区的重要性,推荐使用大桌垫划分空间,并讨论尺寸、材质(如布面、软木)的选择。最后分享个人桌面布置,包括收纳、外设和键盘建议,鼓励读者用简单方法改善工作环境。
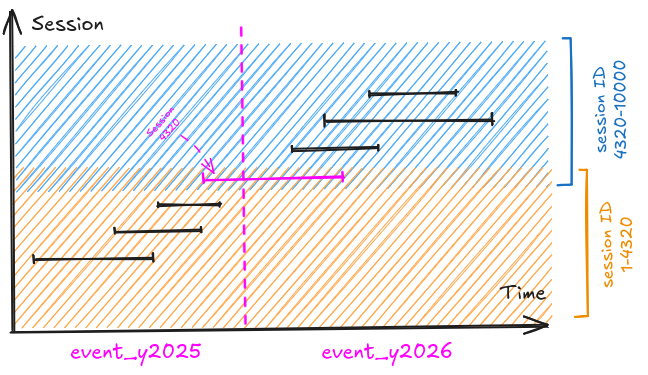
分区表的一个重要优势是修剪,数据库可以根据查询条件排除整个分区。虽然修剪通常依赖于分区键,但通过一些技巧,即使在非分区键列上也能实现修剪。本文展示了如何利用检查约束向优化器传达数据范围,从而提高查询效率。选择合适的分区键具有挑战性,但通过约束排除,可以在非分区键列上实现修剪,简化分区键的选择。
本文探讨了Trino的Exchange机制及其在分布式OLAP中的重要性,涵盖了不同的分区方案(如HASH、BROADCAST)、LocalExchange与RemoteExchange的区别、Broadcast join与Shuffle join的比较,以及如何通过EXPLAIN ANALYZE识别数据倾斜。此外,文章还比较了Trino与Spark在处理数据倾斜时的策略,强调了运行时优化与SQL改写的重要性。
本文探讨了Kafka 3.x(KRaft模式)中日志与分区的内核语义,重点介绍了Topic、Partition和Log Segment的结构及其在磁盘上的表现。Kafka保证同一分区内消息的顺序,但不同分区间无序。文章分析了写路径的顺序追加机制和读路径的fetch过程,强调了offset的单调性与不可回退特性,以及通过分区设计优化吞吐量的方法。最后,讨论了KRaft与ZooKeeper模式的区别。
Iceberg通过隐藏分区和分区演进解决了Hive的分区问题。隐藏分区允许用户在数据列上写谓词,系统自动裁剪分区,避免全表扫描。分区演进则允许在不重写历史数据的情况下修改分区方案,保留旧数据的同时新增分区规范。这些设计提高了数据管理的灵活性和效率。
文章讨论了在高插入量数据库中,如何通过分析死元组比例和识别热点分区,避免因不均匀的分区键导致的写入瓶颈。建议使用基于时间的分区来优化写入性能,以实现均衡的写入负载和减少延迟。
InnoDB的Buffer Pool机制通过维护LRU、Free和Flush三种列表来管理内存中的数据页。调整innodb_buffer_pool_size至物理内存的80%可能导致TPS下降,因为flush列表无法跟上脏页生成速度。Buffer Pool分为young和old区,优化全表扫描时的热页管理。监控应关注命中率、脏页比例和flush列表长度,以避免性能瓶颈。
文章讨论了MySQL组复制中的高可用性问题,提出了“故障转移棕色化”的概念,并强调在Kubernetes环境下重新思考高可用性。此外,介绍了Percona Operator for MySQL 1.20.0的新功能,包括自动存储调整、TLS证书轮换和对ARM64的支持。
Dockside 是一款为 macOS 设计的效率工具,能够在程序坞旁创建文件置物架,方便用户快速拖放和整理文件、链接等。它支持多达 8 个分区,自动监控文件夹内容,并提供多种高级功能,帮助用户提高工作效率。
杜老师分享了“零食分区”方法,以提高工作专注力。她将零食分为高频区和低频区,高频区放常吃的坚果、肉干和能量棒,低频区放偶尔吃的水果和零食。此方法使桌面整洁,方便取用,杜老师认为分区比多收纳盒更有效。
杜老师分享桌面零食分区法:高频区放桌面伸手可及处,不超过5种;低频区放抽屉或书架,定期整理。关键是位置固定、伸手可拿,比多买收纳盒更管用。
完成下面两步后,将自动完成登录并继续当前操作。