UltraBERT-Embed-150M支持32K token输入,可将整篇文档压缩为单个768维向量。在LongEmbed和MLDR测试中,整文档向量在Passkey任务上召回率达99%,但在细节检索任务上普遍不如512 token分块,长文档细节易丢失。分块向量经1-bit TurboQuant压缩后体积缩小30倍,20万篇文章约140MB,保留约95%质量,重打分后达98%。结论:分块尚未过时,细节检索仍建议以512 token分块为起点。
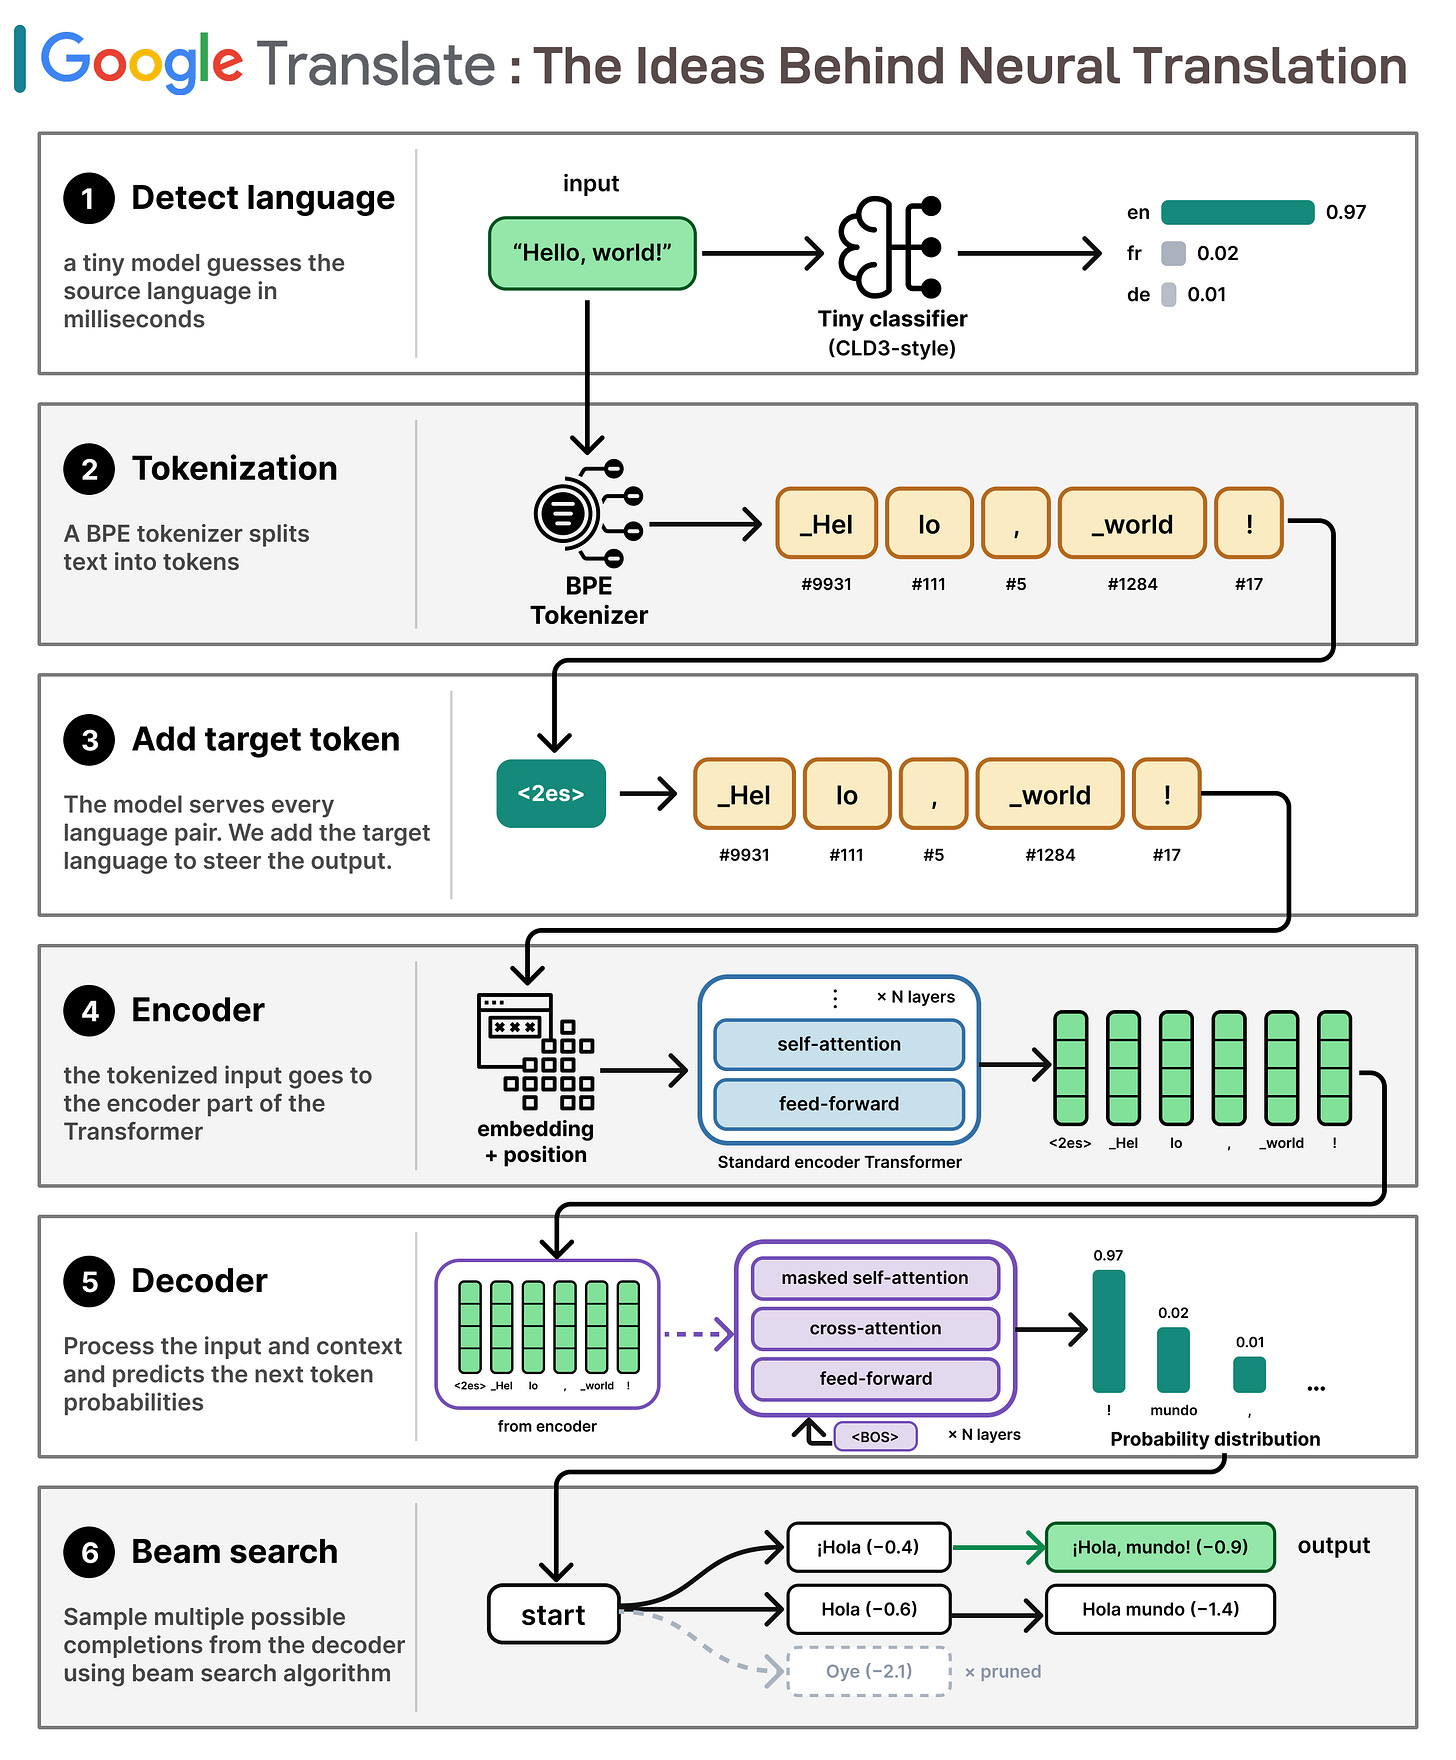
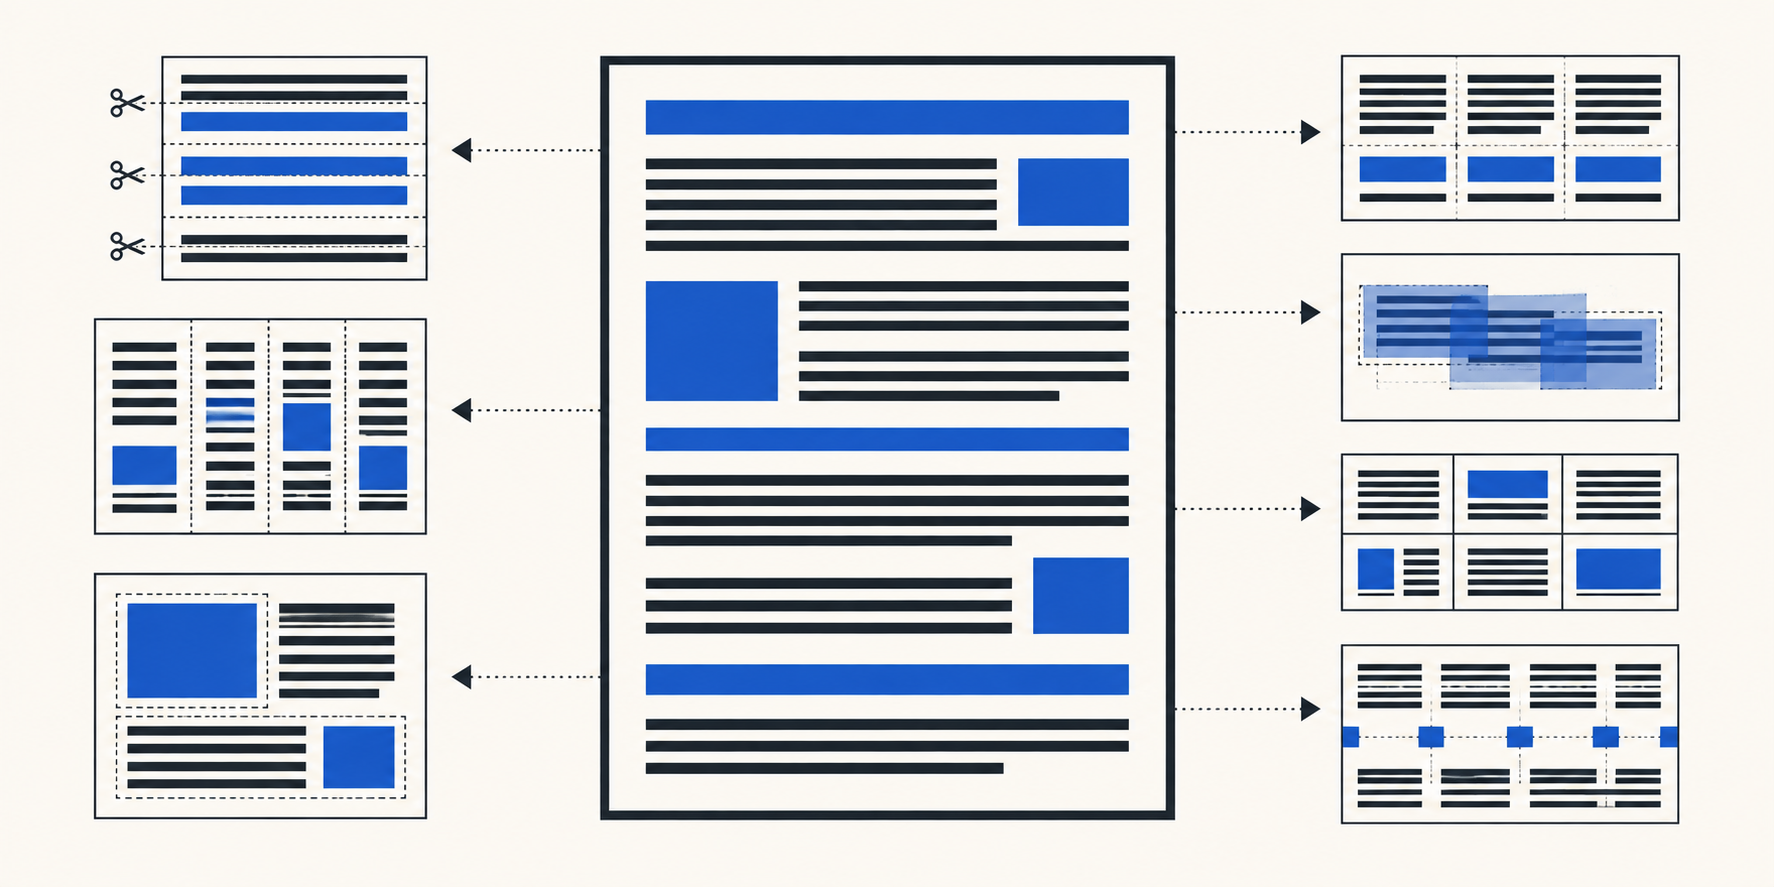
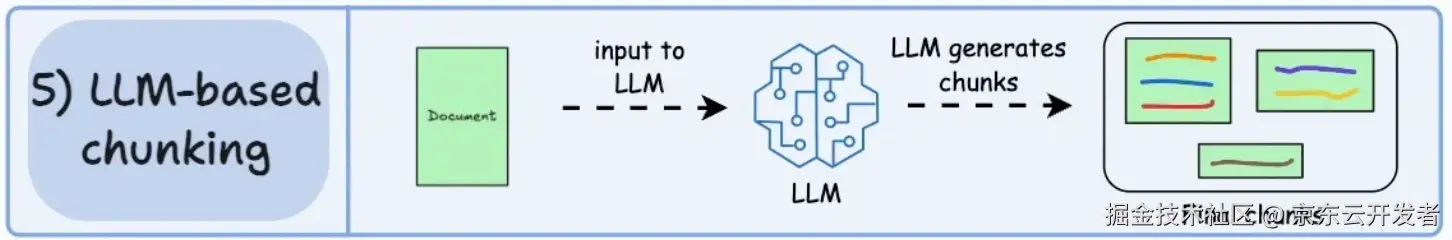
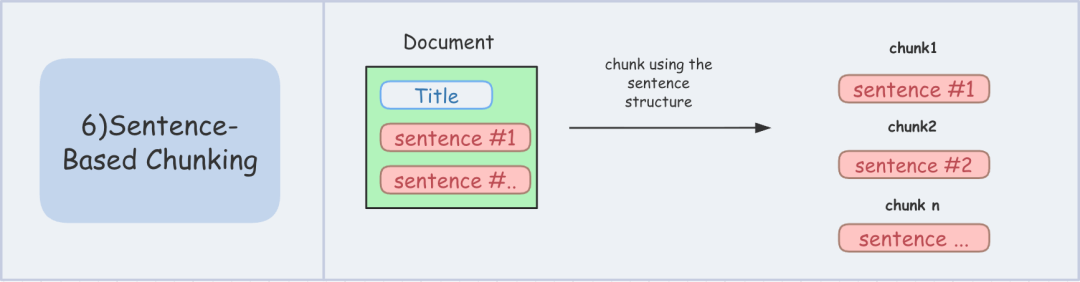
本文介绍RAG智能体的8种分块策略:固定大小、递归、基于文档结构、语义、基于LLM、智能体、延迟分块和分层分块;简述谷歌翻译神经机器翻译流程:语言检测、BPE分词、目标语言标记、编码器、解码器和束搜索;并介绍智能体技能按需加载机制及PostgreSQL进程架构与MySQL线程架构的差异。
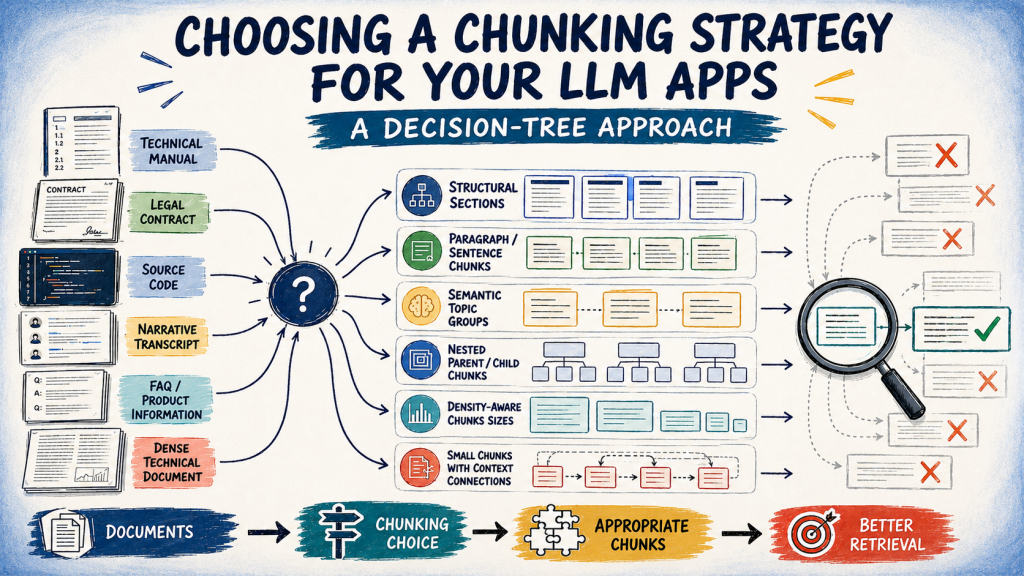
本文介绍RAG系统的分块策略选择,提出六问决策树:文档是否需分块、有无清晰结构、是否需跨段上下文、信息密度是否不均、质量是否优先于成本、语料是否异构。据此匹配固定大小、递归、基于文档、语义、晚期、自适应、层次、LLM及智能体等策略,并识别分块不当的常见症状与修复方法。
vLLM-Omni流式TTS需区分首包延迟(TTFP)与端到端时间。官方在H200并发1下测得,异步分块加流式使TTFP从733ms降至64ms,但端到端升至941ms。优化应按场景选目标:互动产品保TTFP与连续播放,离线产品保RTF与成本,并关注分片大小、协议完整性与内容质量。
Percona Server for MySQL 9.7 新增向量相似度函数 DISTANCE() 与 VECTOR_DISTANCE(),并涉及 MySQL 组复制跨集群 DC-DR 方案及数据目录中 GCache 页面文件过多的问题。
Turbopack通过智能分块优化JavaScript加载,平衡请求数量与代码体积。它引入“块组”概念,仅在组内合并块,并依据用户导航模式计算合并收益。Next.js 16.3新增功能:运行时动态选择合并或未合并块、基于分析调整合并策略,以及通过树摇CJS模块和共享运行时减少代码量,提升缓存命中与加载性能。
部分模型不通过标准 tool_calls 返回工具调用,而是将 DSML/XML 标记混入文本流,导致代理循环收不到工具事件、界面显示乱码。文章提出跨分块流式 DSML 恢复状态机:检测前缀后进入捕获模式,缓冲并拼接分块标签;识别用户示例时禁用恢复,原生调用与文本冲突时失败关闭;解析后校验工具名与 JSON Schema,合成标准工具调用事件,交由代理循环执行。
本文介绍了RAG系统中七种分块策略:固定大小分块、句子窗口检索、文档结构分块、语义分块、层级分块、LLM命题分块及多模态表格保留分块。每种策略各有适用场景,如固定分块适合日志,语义分块适合无结构文本。文章强调,生产环境中还需关注索引生命周期管理和分块去重,避免数据膨胀影响性能。
Redis Iris 提供实时上下文引擎,支持快速数据检索和缓存,优化 AI 应用的响应时间。文章讨论了固定大小分块的局限性,提出动态分块策略以适应不同内容和查询类型,从而提升检索质量。Redis 的快速索引和存储能力使这些策略在实际应用中更有效,适合不断变化的文档和查询需求。
voyage-context-4是新一代上下文化块嵌入模型,能够在无需手动元数据的情况下捕捉完整文档上下文。它在39个数据集上超越前代模型,支持自动分块和处理超长文档,提升检索准确性,适用于多种应用场景。
本文讨论了在检索增强生成(RAG)管道中,文档分块的重要性。分块策略影响检索精度、索引大小和查询延迟。常见的分块方法包括固定大小分块、递归分块和语义分块。选择合适的分块策略需考虑文档类型和查询模式。较小的分块适合精确检索,而较大的分块则有助于叙述性查询。
在Cache Lab中,任务是优化32x32、64x64和61x67矩阵的转置,旨在减少缓存未命中。通过矩阵分块和循环展开技术,针对不同矩阵大小采用不同优化策略,以提高性能并降低缓存未命中次数。优化不仅依赖数学,还需理解硬件特性。
本文介绍如何使用pgEdge Vectorizer将文档分块并生成向量嵌入,以实现基于语义的搜索。通过将文档拆分为小块,系统能够更精确地检索相关内容。pgEdge Vectorizer作为PostgreSQL扩展,自动处理文档更新和嵌入生成,简化管理流程。
本文探讨了检索增强生成(RAG)中分块策略的重要性。分块是将大型文档分割成小片段以优化信息检索。主要分块策略包括固定大小、语义、递归和基于文档等,每种策略各有优缺点。选择合适的分块策略需考虑文档类型和任务需求,建议从512个tokens和10-15%的重叠率开始,以提高检索效果和信息组织性。
本文探讨了在检索增强生成(RAG)中分块策略的重要性。分块是将大型文档分割成小片段以提高信息检索效率。主要分块策略包括固定大小分块、语义分块、递归分块和基于文档的分块。每种策略各有优缺点,选择合适的方法对提升RAG性能至关重要。建议从512个tokens和10-15%的重叠率开始,结合递归和语义分块进行优化。
在构建检索增强生成(RAG)应用时,文档分块至关重要,影响信息检索和生成的准确性。常见的分块策略有固定大小、递归、语义和文档基础等。选择合适的分块方法需考虑文档特性和检索需求,以提升系统性能。
Tiler是CuTe布局代数中的关键概念,支持分块数据访问。CuTe逻辑坐标定义数据位置,布局决定存储方式。通过CuTe的组合、补充和逻辑除法,可以灵活创建数据访问模式,从而优化CUDA加速计算中的数据访问效率。
文章讨论了应用验证和用户信息请求,涉及应用标识、用户ID及请求参数等数据。
本文介绍了physical intelligence公司推出的实时动作分块技术,旨在提升视觉-语言-动作模型(VLA)的实时控制能力。该技术通过异步机制和修复方法,解决了模型推理延迟和动作不连贯的问题,使机器人能够更精确地执行复杂任务。
机器之心数据服务现已上线,提供高效稳定的数据获取,简化数据爬取流程。
完成下面两步后,将自动完成登录并继续当前操作。