

小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
D2H 怎么会 hang 呢!

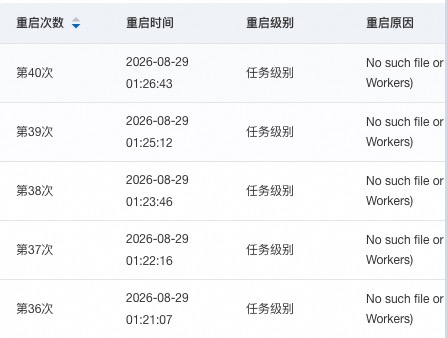
作者在分布式推理系统中遇到cudaMemcpyAsync永久挂起的问题,表现为GPU空闲但CPU自旋等待。通过排查,发现是pageable内存拷贝导致驱动轮询卡死,最终用pinned buffer替换所有pageable拷贝来规避,但未解决根本原因。

D2H 怎么会 hang 呢!

学习让我快乐 学习让我快乐 · 2026-08-28T16:00:00Z
【vLLM 学习】Distributed

本文介绍vLLM框架及其Helm图表部署方法,并展示一个使用Ray Data进行多节点分布式离线批处理推理的Python示例。示例通过LLMPredictor类调用Llama-2模型,配置采样参数、张量并行和实例数,从S3读取文本数据,批量生成文本并输出结果。

【vLLM 学习】Distributed

HyperAI超神经 HyperAI超神经 · 2026-08-22T09:53:44Z

当前高端NVIDIA显卡及其服务器和电力成本高昂,尤其在运行大型模型时。苹果硬件和DGX Spark是可行的替代方案。Mac Studio M3 Ultra在处理速度上表现尚可,但未来本地推理的成本和内存短缺令人担忧。使用多台MacBook M5 Max进行分布式推理可能是一个有趣的方向,结合不同模型的优势可能提高性能。

在DwarfStar中分布式推理LLM

<antirez> <antirez> · 2026-05-25T14:54:59Z

DwarfStar 4迅速走红,满足了本地AI集成需求,支持在96或128GB内存下运行。作者希望未来版本能涵盖编码、法律和医疗等专业领域。DeepSeek v4 Flash表现出色,关注质量基准、硬件设置和分布式推理。

关于DS4的几点看法

<antirez> <antirez> · 2026-05-14T22:22:45Z

本文讨论了从单机到多节点分布式推理部署的架构变化,强调了流水线并行(PP)与张量并行(TP)的结合使用。通过与Ray框架集成,vLLM实现了高效的分布式推理,管理集群资源并协调任务。文章还介绍了Ray集群的搭建、vLLM的配置及生产环境的优化建议,包括网络通信、性能调优和监控等关键步骤。

vLLM集成Ray分布式推理模型部署实战

安志合的学习博客 安志合的学习博客 · 2026-05-05T12:50:03Z
欢迎llm-d加入CNCF:将Kubernetes演变为最先进的AI基础设施

llm-d项目已被纳入云原生计算基金会(CNCF)沙箱,旨在推动Kubernetes及AI基础设施的发展。该项目由Red Hat、Google、IBM等公司合作创建,目标是实现硬件无关的最先进推理性能。llm-d提供了一个Kubernetes原生的分布式推理框架,解决了传统服务路由和自动扩展的不足,确保高效的AI服务,并致力于建立开放的基准测试标准。

欢迎llm-d加入CNCF:将Kubernetes演变为最先进的AI基础设施

Cloud Native Computing Foundation Cloud Native Computing Foundation · 2026-03-24T07:45:00Z
2025 年终总结:当时只道是寻常

作者回顾2025年:年初被DeepSeek震撼,为vLLM贡献推理支持代码,并探索用torch.distributed替代Ray简化分布式推理。文中讨论AI资本支出与预训练瓶颈,认为Agent未带来基础设施变革。生活方面,记录日本、武汉、加州旅行,推荐游戏《燕云十六声》,并感慨逝去猫咪,提醒珍惜当下。

2025 年终总结:当时只道是寻常

高策 高策 · 2025-12-29T16:00:00Z

高通万卫星在MEET2026大会上指出,AI正在从生成式向智能体AI演进,分为感知AI、生成式AI、智能体AI和物理AI四个阶段。终端侧AI具备个性化优势,但面临内存、带宽和功耗的挑战。高通通过技术创新应对这些问题,未来将实现智能设备间的分布式AI推理。

高通万卫星:混合AI与分布式协同是未来 | MEET2026

量子位 量子位 · 2025-12-11T12:00:17Z
NVIDIA Dynamo 解决多节点大语言模型推理挑战

Dynamo是一个开源框架,旨在高效管理大语言模型(LLM)的分布式推理。它将推理过程分为预填充和解码阶段,动态调配GPU资源,以应对需求波动,支持多种推理引擎,并能在Kubernetes上运行高性能AI工作负载,优化资源使用,降低延迟。

NVIDIA Dynamo 解决多节点大语言模型推理挑战

InfoQ InfoQ · 2025-12-04T13:00:00Z
高效分布式推理框架:专为生成式 AI 优化吞吐量与延迟 | 开源日报 No.757

x402 是一种基于 HTTP 的互联网支付协议,支持无手续费、快速结算和低付款额,简化加密货币操作。dynamo 是优化多 GPU 性能的分布式推理服务框架。Starter-Kit-City-Builder 是支持建筑创建和动态控制的 3D 城市构建模板。kani 是轻量级微框架,便于与语言模型交互并自动管理聊天记忆。xenminer 是基于 Argon2ID 的矿工,具备抗 GPU 和 ASIC 能力。

高效分布式推理框架:专为生成式 AI 优化吞吐量与延迟 | 开源日报 No.757

开源服务指南 开源服务指南 · 2025-10-13T07:35:57Z
SPD:大语言模型高效张量并行的同步点丢弃技术

随着大语言模型的快速发展,分布式推理中的通信开销成为主要挑战。我们提出了一种新技术Sync-Point Drop(SPD),通过选择性减少注意力输出的同步,降低通信开销。SPD在保持模型准确性的同时,有效缓解了通信瓶颈,实现了约20%的推理延迟减少,准确率下降不足1%。

SPD:大语言模型高效张量并行的同步点丢弃技术

Apple Machine Learning Research Apple Machine Learning Research · 2025-05-22T00:00:00Z
国产大模型DeepSeek-V3一夜火爆全球,671B的MoE,训练成本仅558万美元

国产大模型DeepSeek-V3以671B参数和278.8万H800 GPU小时的训练成本,表现优异,超越多款开源模型。其MLA和DeepSeekMoE架构提升了推理效率,标志着分布式推理新时代的到来。

国产大模型DeepSeek-V3一夜火爆全球,671B的MoE,训练成本仅558万美元

机器之心 机器之心 · 2024-12-27T03:40:27Z
边缘AI的前景与有效采用的方法

组织正在采用边缘人工智能(AI)进行实时决策,使用模型量化、多模数据库和分布式推理等高效且具有成本效益的方法。边缘计算能够解决数据安全、主权和网络连接性等问题,实现实时分析和响应。边缘AI可以改变新兴应用,但仍存在限制。模型量化、模仿学习、分布式推理和分布式数据管理等技术和方法可以帮助消除障碍,实现高效和具有成本效益的边缘AI部署。

边缘AI的前景与有效采用的方法

KDnuggets KDnuggets · 2024-03-25T16:00:30Z

本文介绍了在阿里云容器服务ACK上使用Bloom7B1模型进行大语言模型分布式推理的实践,通过DeepSpeed Inference解决方案实现多GPU并行推理。同时,使用阿里云容器服务ACK的云原生AI套件可以管理和调度大规模异构资源,快速部署推理服务,并提供监控和优化功能。文章还介绍了具体的实践步骤,包括环境准备、模型配置编写、启动服务和Ingress配置。通过这些步骤,可以轻松部署和管理大语言模型的分布式推理服务。

揭秘大语言模型实践:分布式推理的工程化落地才是关键!

阿里云云栖号 阿里云云栖号 · 2023-06-27T08:06:37Z
  • <<
  • <
  • 1 (current)
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码