本文介绍小语言模型窄域自动化优化的第二种策略:复用提示前缀的键值缓存。窄域任务提示中静态指令占绝大部分,逐条重算全部前缀十分浪费。作者用Qwen2.5-0.5B在600条工单上测试,将静态前缀预填充一次并缓存,每条仅处理变化的后缀,并需正确设置注意力掩码、缓存位置,处理后裁剪缓存。结果运行时间从184.85秒降至80.07秒,减少约57%,预测完全一致。
本文讨论长上下文推理服务的缓存与调度优化。核心原则是缓存未命中比命中贵几个数量级,因此设计围绕复用展开:单实例内通过块哈希实现前缀缓存;KV池采用write-back策略在GPU、DRAM、SSD间分层存储;集群层面用一致性哈希实现缓存亲和,并按请求类别分配预算以应对长请求突发。
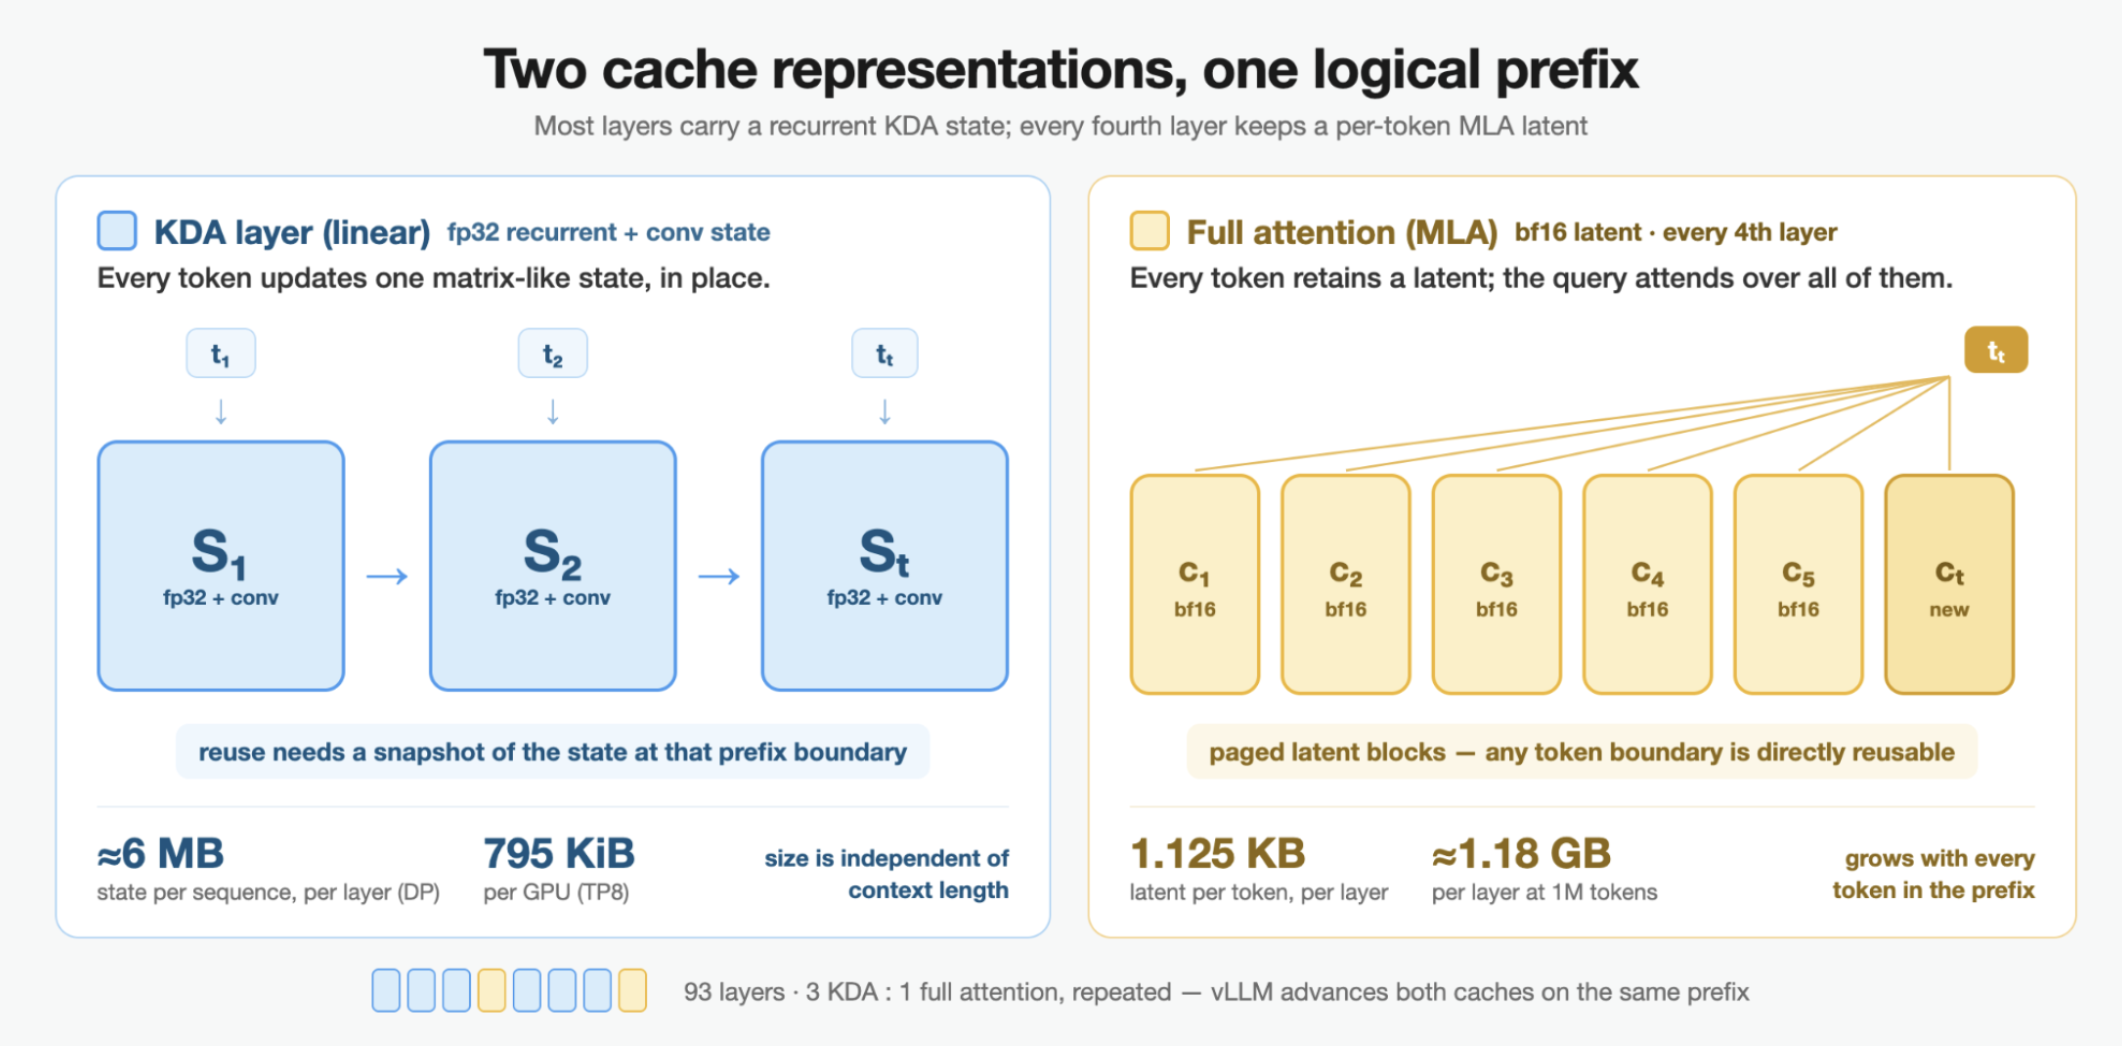
Kimi K3采用KDA与MLA混合注意力架构,引入循环状态缓存,改变传统KV缓存语义。Mooncake与SGLang、vLLM、TokenSpeed合作,实现KDA感知的检查点管理、跨实例缓存复用及统一数据传输平面,支持百万级长上下文推理,降低冗余计算,提升多轮对话和智能体任务效率。
本文探讨了Apache Lucene中有限状态转换器(FST)在段文件中的作用,如何通过词典快速定位倒排索引的postings。FST通过共享前缀压缩词典,减少内存占用,并支持高效查找与遍历。文章比较了Lucene的词典结构与PostgreSQL的GIN Entry Tree,强调两者在存储引擎假设上的不同,并讨论了FST的实现细节及其在查询中的应用。
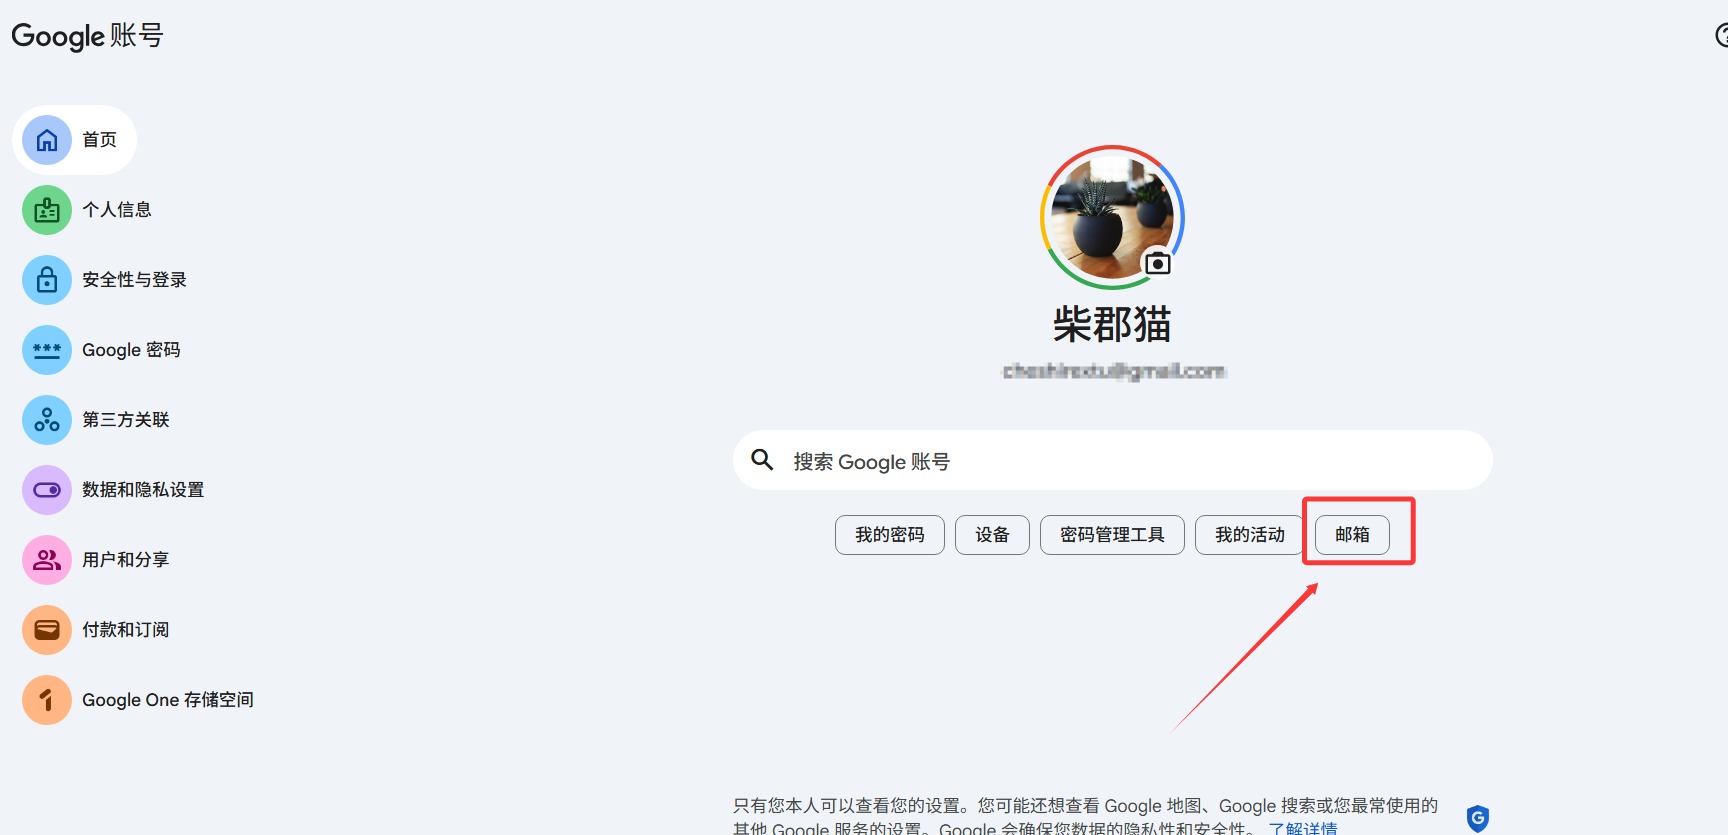
谷歌允许用户修改Gmail邮箱前缀,但需谨慎操作。修改前需为使用谷歌快捷登录的网站设置密码,以避免被识别为新用户。修改后,用户可继续使用新邮箱登录,旧邮箱仍可作为备用。每个账户最多可更改三次地址,变更不会影响账户数据。建议用户在修改前检查所有授权网站并手动设置密码。
推理需求快速增长,预计到2030年将占全球AI计算的主要部分。许多团队未能有效利用计算资源,导致重复计算浪费。DigitalOcean通过前缀感知路由和缓存技术优化推理性能,提高缓存命中率,降低计算成本,并将在Serverless Inference中推广,帮助用户节省计算资源。
DEFLATE压缩格式中,Huffman编码在整数码长下最优,规范码只需传码长;15位限长在Canterbury语料上从未触发。实测zlib -9输出中,距离额外比特占41.9%,码表仅0.39%,Huffman码仅比经验熵多0.64%。zopfli靠优化解析省8.0%,其中87%来自距离额外比特,说明解析比熵编码更重要。
本文讨论了区间问题的高效解决方案,介绍了树状数组和线段树两种数据结构。树状数组适合点修改和区间查询,复杂度为O(log n);线段树支持更复杂的操作如区间赋值和懒标记。两者各有优劣,树状数组在常数时间上更优,但线段树在灵活性上更强。
Bootstrap 团队发布 PostCSS 插件 postcss-prefix-custom-properties,可在构建时为 CSS 自定义属性及 var() 引用统一添加前缀(如 --bs-),并支持 @property 规则和 ignore 忽略选项。Sass 源码因此无需再写 #{$prefix} 插值,更简洁易维护。插件完全可选,不装也能编译出无前缀变量,适用于 Vite、webpack 等任意 PostCSS 环境。
春节后,开发者排查三方MES系统异常,怀疑数据库操作导致数据不一致。通过AI分析识别349张英文缩写表名对应的业务模块,以便快速定位和修正相关数据表。
杜老师分享了两步命令收纳的方法:首先,将 alias 写入独立的 .zshrc.local 文件,便于管理和备份;其次,为所有 alias 添加前缀,以避免与系统命令冲突并提升命令补全效率。他建议根据使用频率决定是否使用 alias,以提高工作效率。
用户可将Google账号邮箱更改为新地址,旧邮箱将成为备用邮箱,数据不受影响。更改后可随时切换回旧邮箱,但在12个月内无法创建新Gmail账号。重要账号不建议修改。
在 WPF 开发中,布尔类型属性的命名应根据语义进行区分。描述状态时使用“Is”前缀,如“IsEnabled”;控制行为时则不加前缀,如“IgnoreReset”。命名应简洁明了,符合自然语言习惯。
Amazon S3 Storage Lens推出三项新功能,新增八个性能指标,支持分析数十亿个前缀,并可导出至S3表类数据存储服务,帮助用户优化应用性能和降低成本。
Cloudflare推出自助BYOIP API,简化客户引入IP地址空间的流程,客户可自行管理IP前缀,减少审批和等待时间。新系统采用RPKI技术,确保安全性和稳定性,提高IP地址管理效率。
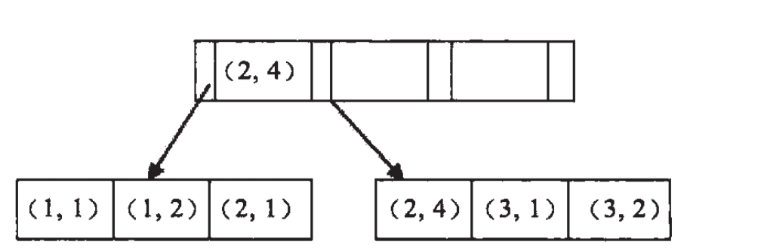
联合索引是MySQL中用于优化多列查询性能的索引类型,遵循“最左匹配原则”。创建时需考虑字段的选择性和基数,以提高查询效率。范围查询可能导致后续字段的索引失效,但仍可实现索引覆盖。合理使用联合索引能显著提升查询速度。
SQL Server 和 PostgreSQL 在 VARCHAR 的实现上存在显著差异。SQL Server 区分 VARCHAR(非 Unicode)和 NVARCHAR(Unicode),使用时需在字符串前加 N 以标识 Unicode,避免乱码。而 PostgreSQL 默认支持 Unicode,无需加 N。了解这些差异有助于正确使用数据库。
本文分析了Hackerrank的数组操作问题,介绍了非最优解法和优化解法。优化解法利用前缀和和差分数组,时间复杂度为O(n+m),显著提高效率。通过差分数组可在O(1)时间内处理范围更新,最终计算最大值。
Trie(前缀树)是一种高效的数据结构,专为快速检索键值而设计。它通过字符节点构成树形结构,支持快速插入和搜索,适用于自动补全和前缀匹配。与简单数组搜索相比,Trie在处理大数据集时更为高效,显著提升用户体验。
编写一个函数,找出字符串数组中的最长公共前缀,若不存在则返回空字符串。欢迎分享解决方案和思路。
完成下面两步后,将自动完成登录并继续当前操作。