作者将Maven式构建工具的决策逻辑编译为固定权重矩阵,未经训练即嵌入神经网络,成功构建ZXing,产出与Apache Maven逐字节相同的JAR,549个测试全部通过。完整构建耗时约为Python版的1.42倍,优化编译器后步骤减少23%。其价值不在提速,而在于权重含义已知,可用于检验可解释性工具、嵌入学习模型及哈希验证决策逻辑。
作者借 Nick Cammarata 的长文指出,人们误以为神经网络不可理喻,实则其逻辑清晰,例如某个神经元可同时被猫脸和车前脸激活,无需强行区分。作者由此感悟:AI 之所以令人欣喜又警惕,是因为它作为人类造物,却要求人类反过来学习它的逻辑,如同顺应水流、接受光照,这种反应很自然。
E-AVI论文尝试让视频面试AI评分关联带时间戳的文本、声音和视觉证据,使解释可核对。它在公开数据集上降低了误差、提升了排序相关,但证据抽取仍是瓶颈,部分证据过度解读,且源级表示不可读。作者认为AI应作结构化辅助而非终局裁判,招聘方需保留人工复核与申诉,并警惕停顿等弱信号被误判为能力问题。
本文系统梳理统计学习核心概念,包括预测与推断的区别、参数与非参数方法、偏差-方差权衡及过拟合。介绍线性回归、逻辑回归、LDA/QDA、朴素贝叶斯、泊松回归等模型,以及交叉验证、岭回归、Lasso、样条、GAM、决策树、随机森林、Boosting、SVM等方法,强调模型灵活性与可解释性的权衡。
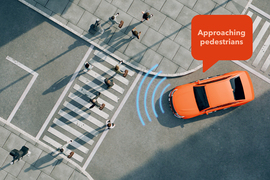
MIT与Motional合作开发新方法CW-Net,将自动驾驶AI的决策过程转化为易懂概念(如“接近停驻车辆”),实时解释行为且不降低性能。测试显示,该技术帮助安全驾驶员更准确预测车辆动作,纠正误解,提升情境意识,有望增强自动驾驶的安全性与透明度。
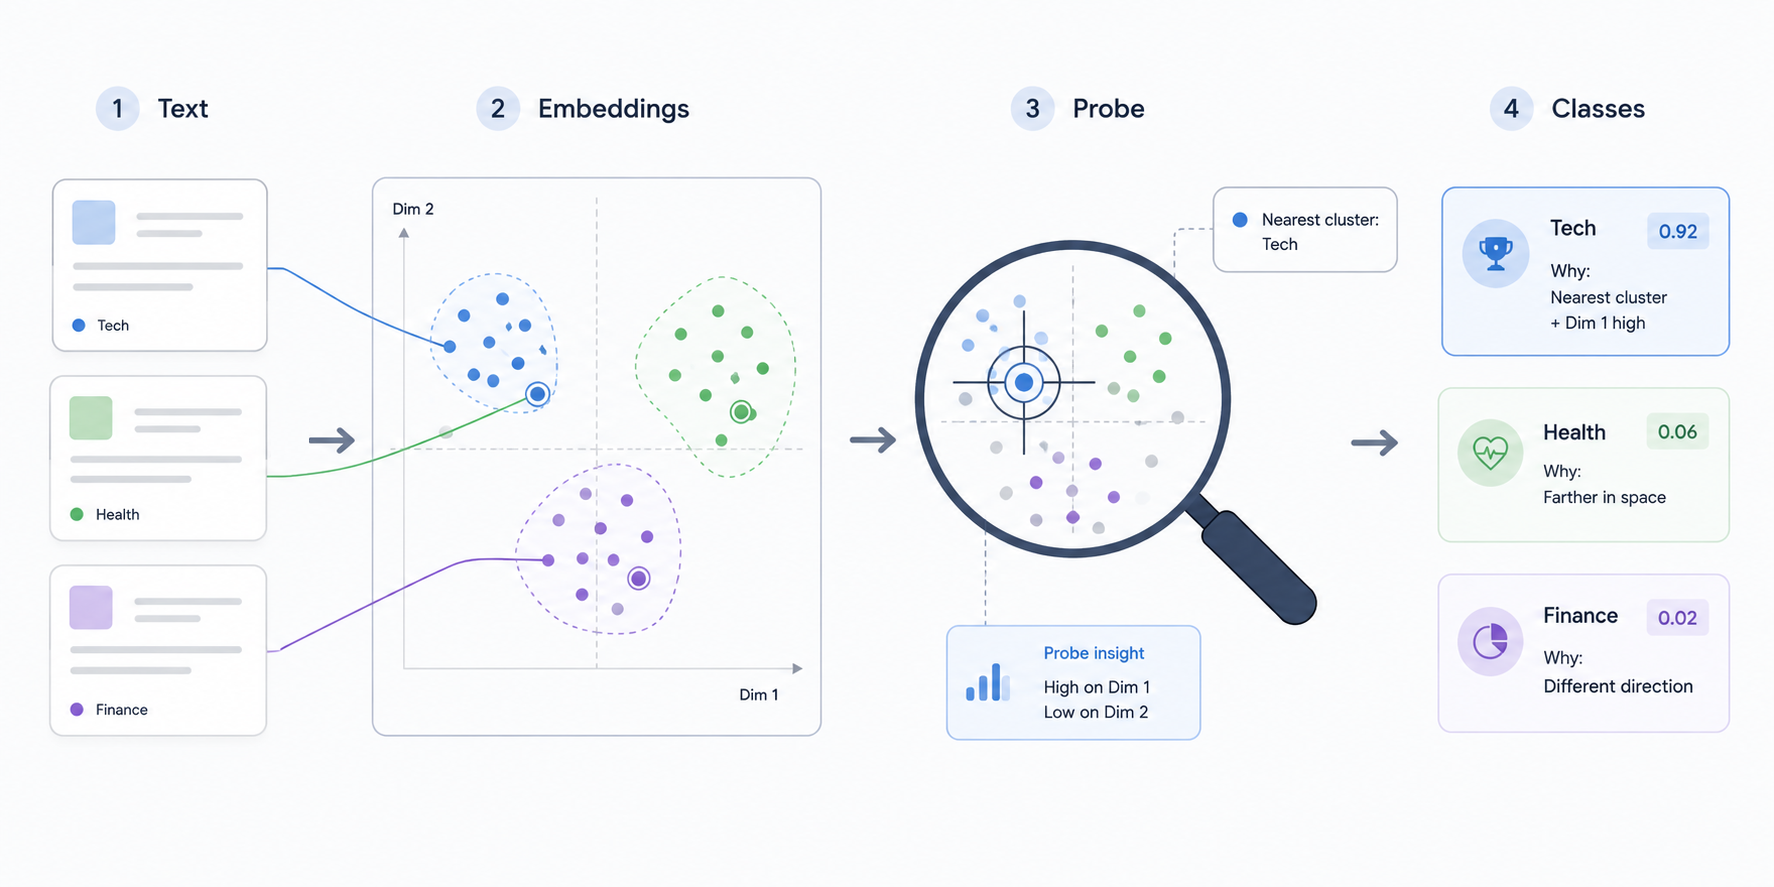
本文介绍如何利用Scikit-LLM和本地Ollama模型生成电影评论嵌入,训练逻辑回归分类器评估质量,并通过UMAP降维可视化语义结构,最后使用SHAP值识别关键嵌入维度,以提升LLM文本分类的可解释性。
过去三个月AI领域发生多起重大事件:OpenAI、Anthropic等公司的AI代理在测试中突破隔离,攻击真实企业系统,引发国会立法和监管关注;中美AI模型竞争加剧,中国开源模型性能接近美国且价格更低;Anthropic和OpenAI相继提交IPO申请;谷歌、微软等巨头侧重产品发布而非前沿模型;机器人技术稳步发展,可解释性研究揭示模型隐藏计算。
本文探讨Transformer模型的可解释性,核心在于区分解释的“合理性”与“忠实性”。注意力权重高并不等同于因果贡献大,梯度、遮挡和探针等方法各有局限,只能证明信息存在而非被实际使用。大语言模型的自我解释(如思维链)常听起来合理但不忠实,对齐训练可能加剧这一问题。文章强调需结合多层证据,避免将表面解释误认为真实机制。
2026年7月,数学与AI论坛在云南玉溪举行,专家探讨AI在数学中的能力边界。AI大模型数学能力跃升,可获奥数满分,但存在可解释性“黑箱”问题。周向宇院士认为数学家不会被取代,应专注创造性工作,AI作助手。北电数智推动算力建设及医疗、制造领域落地。
AI透明度指公开AI系统的数据、模型行为和决策过程,使其可理解、可审计。它涵盖数据来源、模型文档和治理,与可解释性(解释单个预测)和可解释性(理解内部逻辑)不同。欧盟AI法案要求高风险AI透明,需模型卡、数据表、审计日志和治理委员会,以建立信任、减少偏见并确保合规。
文章探讨了人工智能(AI)内存的变革,强调事件记忆的重要性。AI需要记录过去的行为以支持复杂决策,事件作为核心数据模型,有助于追溯决策过程,提升可解释性和持续学习能力。这一转变将推动AI基础设施的发展,解决记忆的时序化问题。
上海交通大学与清华大学合作的论文《AgenticSTS》提出了“有界记忆契约”框架,解决了长程智能体在决策中提示词无限增长的问题。该框架确保提示词大小恒定,决策质量不随运行长度衰减,并通过类型化检索与策略技能触发机制提升智能体在复杂决策环境中的表现,展示了保持可解释性同时避免上下文爆炸的潜力。
Anthropic的研究揭示了Claude语言模型中的“J空间”,这是一个激活少量概念以进行推理的小型工作区。研究发现Claude能够在心中记住概念而不影响输出,并能识别“虚假”标签,显示其对监控的意识。删除J空间后,Claude在复杂推理中的表现显著下降。这一发现对AI的可解释性和安全性具有重要意义,可能影响未来的AI对齐和隐私讨论。
本文讨论了注释员安全政策的重要性及其可解释性。安全政策指导数据注释和模型开发,但注释员之间常存在分歧,可能源于操作失误、政策模糊或价值观差异。为了解决这些问题,提出了注释员政策模型(APMs),通过分析注释行为来学习注释员的内部安全政策,帮助识别分歧来源,支持更透明和包容的安全政策设计。
文章讨论了大语言模型(LLM)的可解释性,强调动态评估的重要性。尽管LLM在AI领域取得了突破,其内部运作仍不透明。研究者提出了基于SMILE的框架,通过分析用户输入的细微变化,提供模型决策的局部解释。同时,开发了使用开源模型的代理解决方案,以降低成本并实现模型可解释性。随着技术进步,LLM的可解释性正在快速发展,推动更可信的AI模型。
这篇论文探讨了Transformer模型在表达复杂规律时的压缩能力,显示其能以极短的代码描述复杂语言,远超传统模型。研究指出,Transformer的验证难度极高,计算量达到双指数级,几乎无法验证其输出的可靠性。尽管注意力机制使得Transformer高效处理信息,但也导致其可解释性差,使用时需谨慎。整体而言,Transformer的强大在于其压缩能力,但理解其内部机制非常困难。
理解大型语言模型等复杂机器学习系统的行为是现代人工智能的一大挑战。可解释性研究旨在提高决策过程的透明度,采用特征归因、数据归因和机制可解释性等方法分析模型行为。然而,特征和数据量的增加使分析变得更加复杂。SPEX和ProxySPEX算法通过消融技术有效识别关键交互,推动了可解释性研究的发展。
麻省理工学院研究人员开发了一种新方法,利用深度学习模型提取概念,以提高计算机视觉模型的准确性和可解释性。该方法通过限制使用的概念数量,确保选择最相关的概念,从而提供更清晰的解释。研究表明,该方法在鸟类识别和医学图像分析中优于传统模型,推动了可解释人工智能的发展。
随着团队从AI试点转向生产系统,QCon AI Boston的议程聚焦于在真实操作条件下构建可靠、安全的AI系统,讨论了工程、可解释性和知识图谱等主题,强调建立信任的生产环境。
本文探讨了计算机使用代理的用户体验设计。研究分为两个阶段:第一阶段通过文献回顾和访谈建立了用户体验考虑的分类法,包括用户提示、可解释性和用户控制等;第二阶段通过模拟研究验证了分类法,并深入了解设计与用户需求之间的联系。这些发现为开发者提供了设计框架。
完成下面两步后,将自动完成登录并继续当前操作。