谷歌Gemini 4 Argon在18项基准测试中14项领先Claude Opus 5.5,且限时半价。作者实测三项任务:代码审查两者持平,Argon更便宜;规格测试因一行代码错误失败;长上下文测试中Argon推理错误严重、回答草率。结论:Argon虽便宜,但可靠性不足,不建议使用。
SGS在广交会发布《东盟市场机器人具身智脑可靠性应用白皮书》,聚焦东盟市场需求,梳理区域环境特点、场景适配需求与可靠性验证方法。白皮书构建面向机器人产品的工程化可靠性评价体系,以“三重气候分类体系”为基础,建立多级环境严酷等级模型,提出“国别-场景-任务”三维测试矩阵,并针对电力巡检、制造、清洁及商业服务机器人提出防凝露、防腐蚀、绝缘防护等关键设计要求。SGS可提供覆盖零部件、模组及整机的可靠性测试与验证服务。
本书提出智能体AI可靠性验证方法:不信任最终回答,而是从权威状态独立核验执行过程与业务结果。核心是区分响应正确性与结果正确性,按响应、步骤、动作、工作流、系统五层判定,结合六类评估活动、故障注入、轨迹与护栏检查,形成可复现的发布证据。附录提供术语定义、外部参考文献及生产就绪清单,按工作流逐项签核,以最弱项决定发布。
2026世界杯期间,Meta基础设施承受极限流量并创下多项纪录:决赛时WhatsApp每秒超3000万条消息,Messenger等每分钟4900万条,Instagram推荐流量周环比增80%,直播观看时长大幅上升。流量高峰多出现在比赛间歇和终场哨响后,而非比赛本身。Meta通过预置容量、分层负载均衡、区域降级和提前预警等策略,实现无人工干预的稳定支撑,并将经验沉淀为可复用方案。
数学家Hales撰文讨论Lean形式化数学的可靠性。2026年AI自动形式化取得突破,Fermat大定理等被快速形式化,但同年夏季发现多个Lean内核可靠性漏洞,可证明假命题。应对方案包括多内核交叉验证、形式化验证内核(如Con-Leche)及加强类型论元理论研究。作者警告AI时代不可盲信系统,需人类审计。
本文为SRE提供参加KubeCon大会的攻略:建议带着实际生产问题规划议程,周一可参加Observability Day等深度活动,重点关注可靠性、可观测性、自动扩缩容等议题,与维护者直接交流,留出时间参与非正式讨论,最终带回可落地的运维经验。
企业投资AI时,隐私控制常导致生产级数据难获取、关系断裂、质量下降。报告显示,26%组织难获高质量数据,25%难保持实体关系,51%面临数据质量挑战。隐私保护不能牺牲数据可用性,需在合规、质量与速度间平衡,通过企业级脱敏、数据虚拟化和合成数据等手段,确保受保护数据仍具真实性和参考完整性,支撑AI训练、测试与分析。可信数据是AI时代的终极竞争优势。
流媒体高峰时段,数百万用户同时播放使API链路承压。可观测性工具通过被动流量监控,无需改代码即可发现端点、跟踪性能与错误,帮助团队在用户察觉前定位故障,保障云原生架构下播放流畅稳定。
SGS与灵境智源在第23届中国东盟博览会上发布《东盟市场机器人具身智脑可靠性应用白皮书》,提出“三重气候分类体系”,梳理东盟十国气候特征及高温、高湿、盐雾等环境应力影响,构建六级气候等级、五类综合应力试验和四阶段验证策略。灵境智源“具身智脑”通过测试并获两项SGS认证。
本文介绍软件工程师应掌握的API核心概念,包括HTTP方法、状态码与响应结构等基础细节,REST、GraphQL、gRPC、Webhook、WebSocket等设计选型,命名、分页、版本控制、错误响应与向后兼容,API密钥、OAuth、JWT与权限等安全机制,超时、重试、幂等、限流与缓存等可靠性问题,以及文档、规范、可观测性和契约测试等配套工作。
CTI华测检测杭州可靠性测试及分析实验室扩容启用,面积3089平方米,配备80余台仪器,覆盖环境可靠性、机械力学、电气性能三大领域,新增大型环境实验箱、防尘箱及振动台等设备,服务消费电子、车载电子、AI算力、机器人等行业。其投资5.4亿元的长三角总部基地已于7月投产,公司已在十二座重点城市布局可靠性实验室。
DB HiTek宣布完成8英寸1200V碳化硅MOSFET工艺可靠性认证,计划2027年量产。公司已建成全球首套完整8英寸SiC代工流程,提供第一、二代PDK,第三代将于11月发布,可缩短客户开发周期一年以上。今年三季度完成工艺筹备,优先服务长期客户,2027年二季度全面开放。
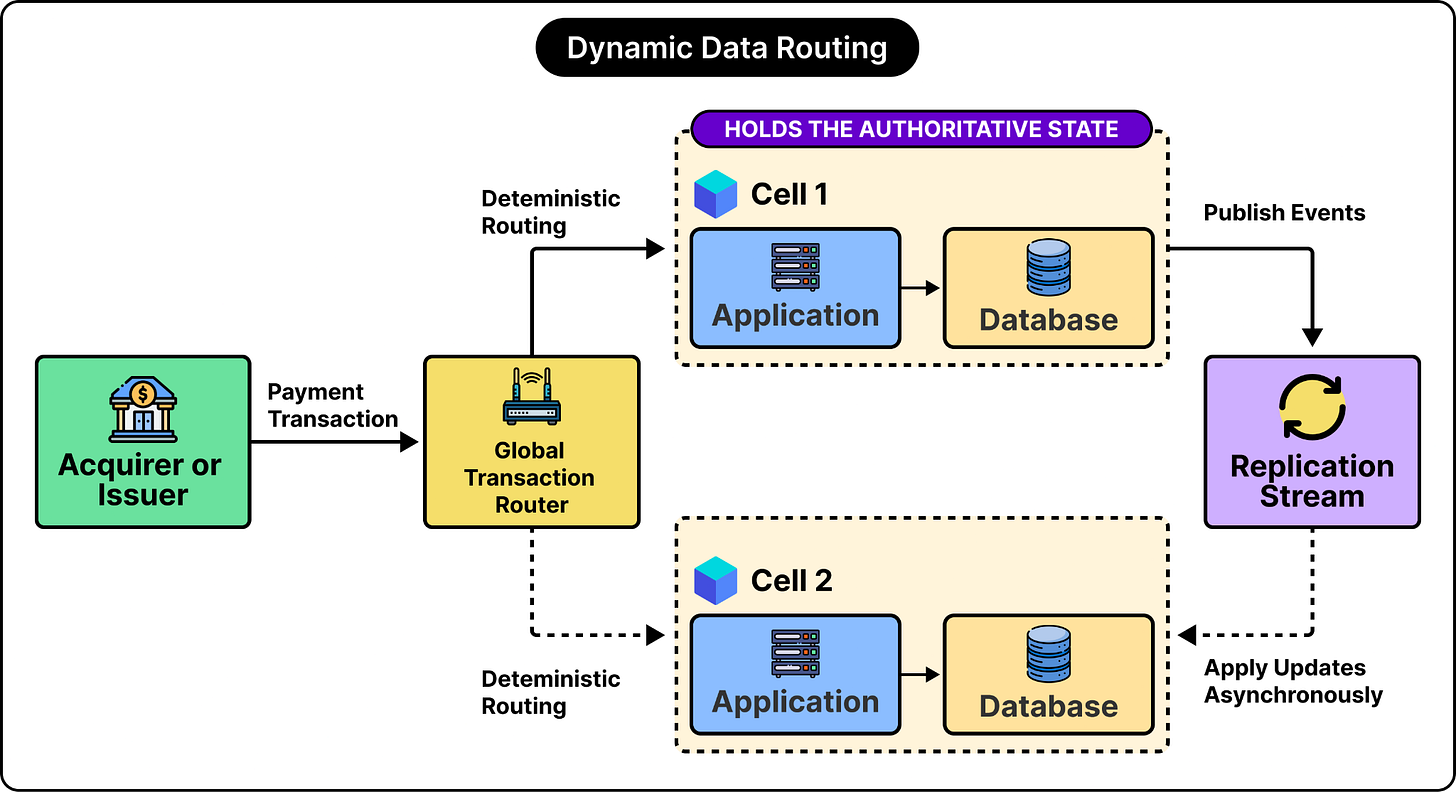
美国运通采用基于单元的架构处理支付,每个单元是包含微服务和数据库的独立完整处理栈。交易通过全局路由器确定性路由至数据所在单元,避免跨单元同步依赖。故障时丢弃部分工作并重启,而非恢复状态,以保持单元隔离。路由器保持简单,数据预分发,确保高可靠性和低延迟。
OpenClaw v2026.9.2发布,聚焦可靠性与性能,支持重启后任务恢复、长对话提速,并接入GPT-6 Astra和Muse Spark模型。其核心优势是允许用户在AI说话中途打断并纠正,实现边说边改,这是ChatGPT等不具备的。但恢复功能需Full Access权限,默认配置偏向开放,用户需注意安全隔离。
该文讨论AI代理(Agent)的评估问题。文章指出,演示成功不代表系统可靠,需将评估纳入交付流程。建议建立可重复的评估系统,使用固定场景和真实任务,记录完整追踪信息,区分确定性检查与主观评分,并设置发布门槛。强调用真实数据测试,将生产故障纳入回归案例,并注意数据安全。最终目标是确保每次发布都尊重用户依赖的边界。
近期多项专利显示,提示词正被“测试化”,自动生成测试函数并优化,分类属软件测试。这带来机会:为小型SaaS团队提供工具,如CLI自动回归测试,或“提示词回归体检”服务。门槛是可靠性,风险是平台内置功能,需靠细分场景立足。
文章聚焦AI代理基础设施中的上下文与状态层问题,指出模型本身并非失败主因,而是上下文管理不善导致性能下降和成本高昂。文中列举了上下文腐烂、记忆污染、token浪费和状态持久性不足等常见故障,并推荐使用Redis Iris作为整合方案,通过统一管理记忆、缓存和检索来提升代理可靠性。
AI代理执行退款时,工具调用成功不等于业务交易成功。文章强调需区分执行记录与业务状态,建议用PostgreSQL事务绑定证据,确保AI意图与业务结果可追溯,并指出这是AI可靠性与未来按结果付费的关键。
调查显示,97%的团队认为上下文工程重要,但仅4%已实施。上下文决定AI代理可靠性,却常无人负责,导致质量、安全和成本问题。解决方案是建立共享基础设施层,由指定团队负责记忆、检索、缓存等,而非新增职位。Redis提供内存级低延迟服务,支持代理上下文管理,帮助团队高效运行。
本文介绍如何用AI整理读书笔记:手动复制10条笔记,加“原文”或“我的想法”标签,用提示词让AI去重、分类、补行动建议,最后检查数量、身份和出处。强调先小范围测试,避免复杂同步,确保笔记可靠可回查。
完成下面两步后,将自动完成登录并继续当前操作。