

小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
大模型不只是预测下一个词:RLVR让它自己跟自己下棋

大模型不再仅依赖预测下一个词,通过RLVR强化学习,它能自主探索解题路径,从模仿者转变为探索者。预训练如同背诵课文,而RLVR则类似自我解题,借助可验证奖励驱动创新,使模型能够生成超出训练数据的新知识,实现超越简单预测的能力。

大模型不只是预测下一个词:RLVR让它自己跟自己下棋

极道 极道 · 2026-09-05T21:34:00Z
大型语言模型如何学习提供帮助(RLHF与DPO)

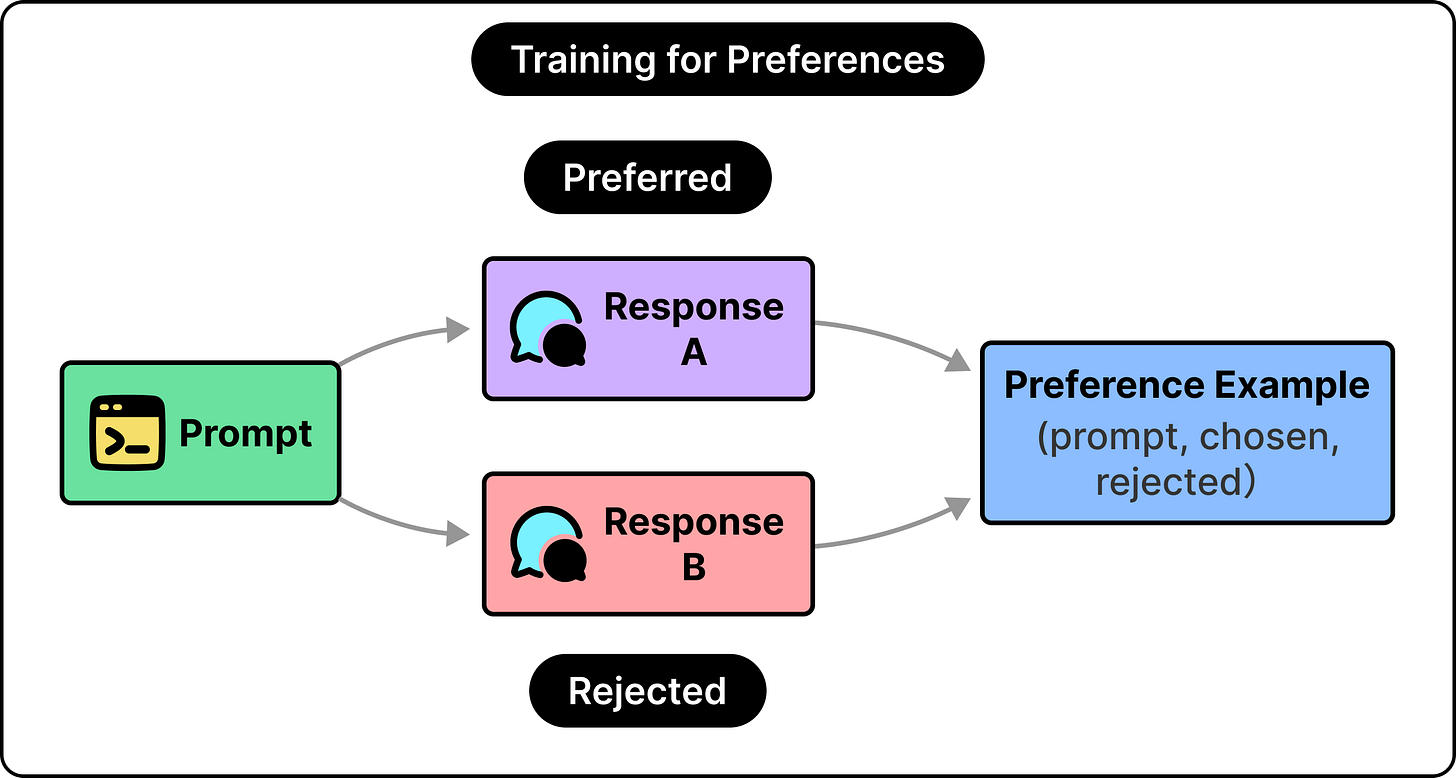
本文探讨了大型语言模型(LLMs)如何通过人类反馈学习,比较了强化学习(RLHF)和直接偏好优化(DPO)两种方法。模型首先通过预训练学习语言和知识,然后通过监督微调学习遵循指令,最后通过比较学习偏好。RLHF通过训练奖励模型并优化,而DPO则简化为单一步骤。两者都依赖于人类判断的信号,但可能导致模型产生迎合性回答。对于可验证的任务,使用可验证奖励可以避免这些问题。

大型语言模型如何学习提供帮助(RLHF与DPO)

ByteByteGo Newsletter ByteByteGo Newsletter · 2026-07-14T15:30:53Z

本研究提出RLVR-World框架,解决传统世界模型训练目标与任务特定目标不一致的问题,通过可验证奖励的强化学习优化模型性能,显著提升语言和视频任务的表现。

RLVR-World: Training World Models with Reinforcement Learning

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-20T00:00:00Z
RLVR并未扩展大型语言模型的推理能力,仅优化了采样行为:新研究

研究表明,强化学习与可验证奖励(RLVR)并未提升大型语言模型(LLMs)的推理能力,而是优化了其采样行为。尽管RLVR训练的模型在单次回答中表现更佳,但在多次尝试中,基础模型的成功率更高。这表明RLVR并未创造新的推理模式,而是提高了已有推理路径的效率。

RLVR并未扩展大型语言模型的推理能力,仅优化了采样行为:新研究

DEV Community DEV Community · 2025-04-26T15:12:55Z
  • <<
  • <
  • 1 (current)
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码