本文介绍向量嵌入如何将文本转化为高维空间中的点,使语义相近的内容距离更近,从而解决关键词搜索的语义匹配问题。文章回顾了从word2vec、GloVe到BERT等模型的发展,强调上下文建模和池化技术的重要性,并指出向量搜索需结合高效索引(如HNSW)和实时数据平台(如Redis)以支持生产应用。
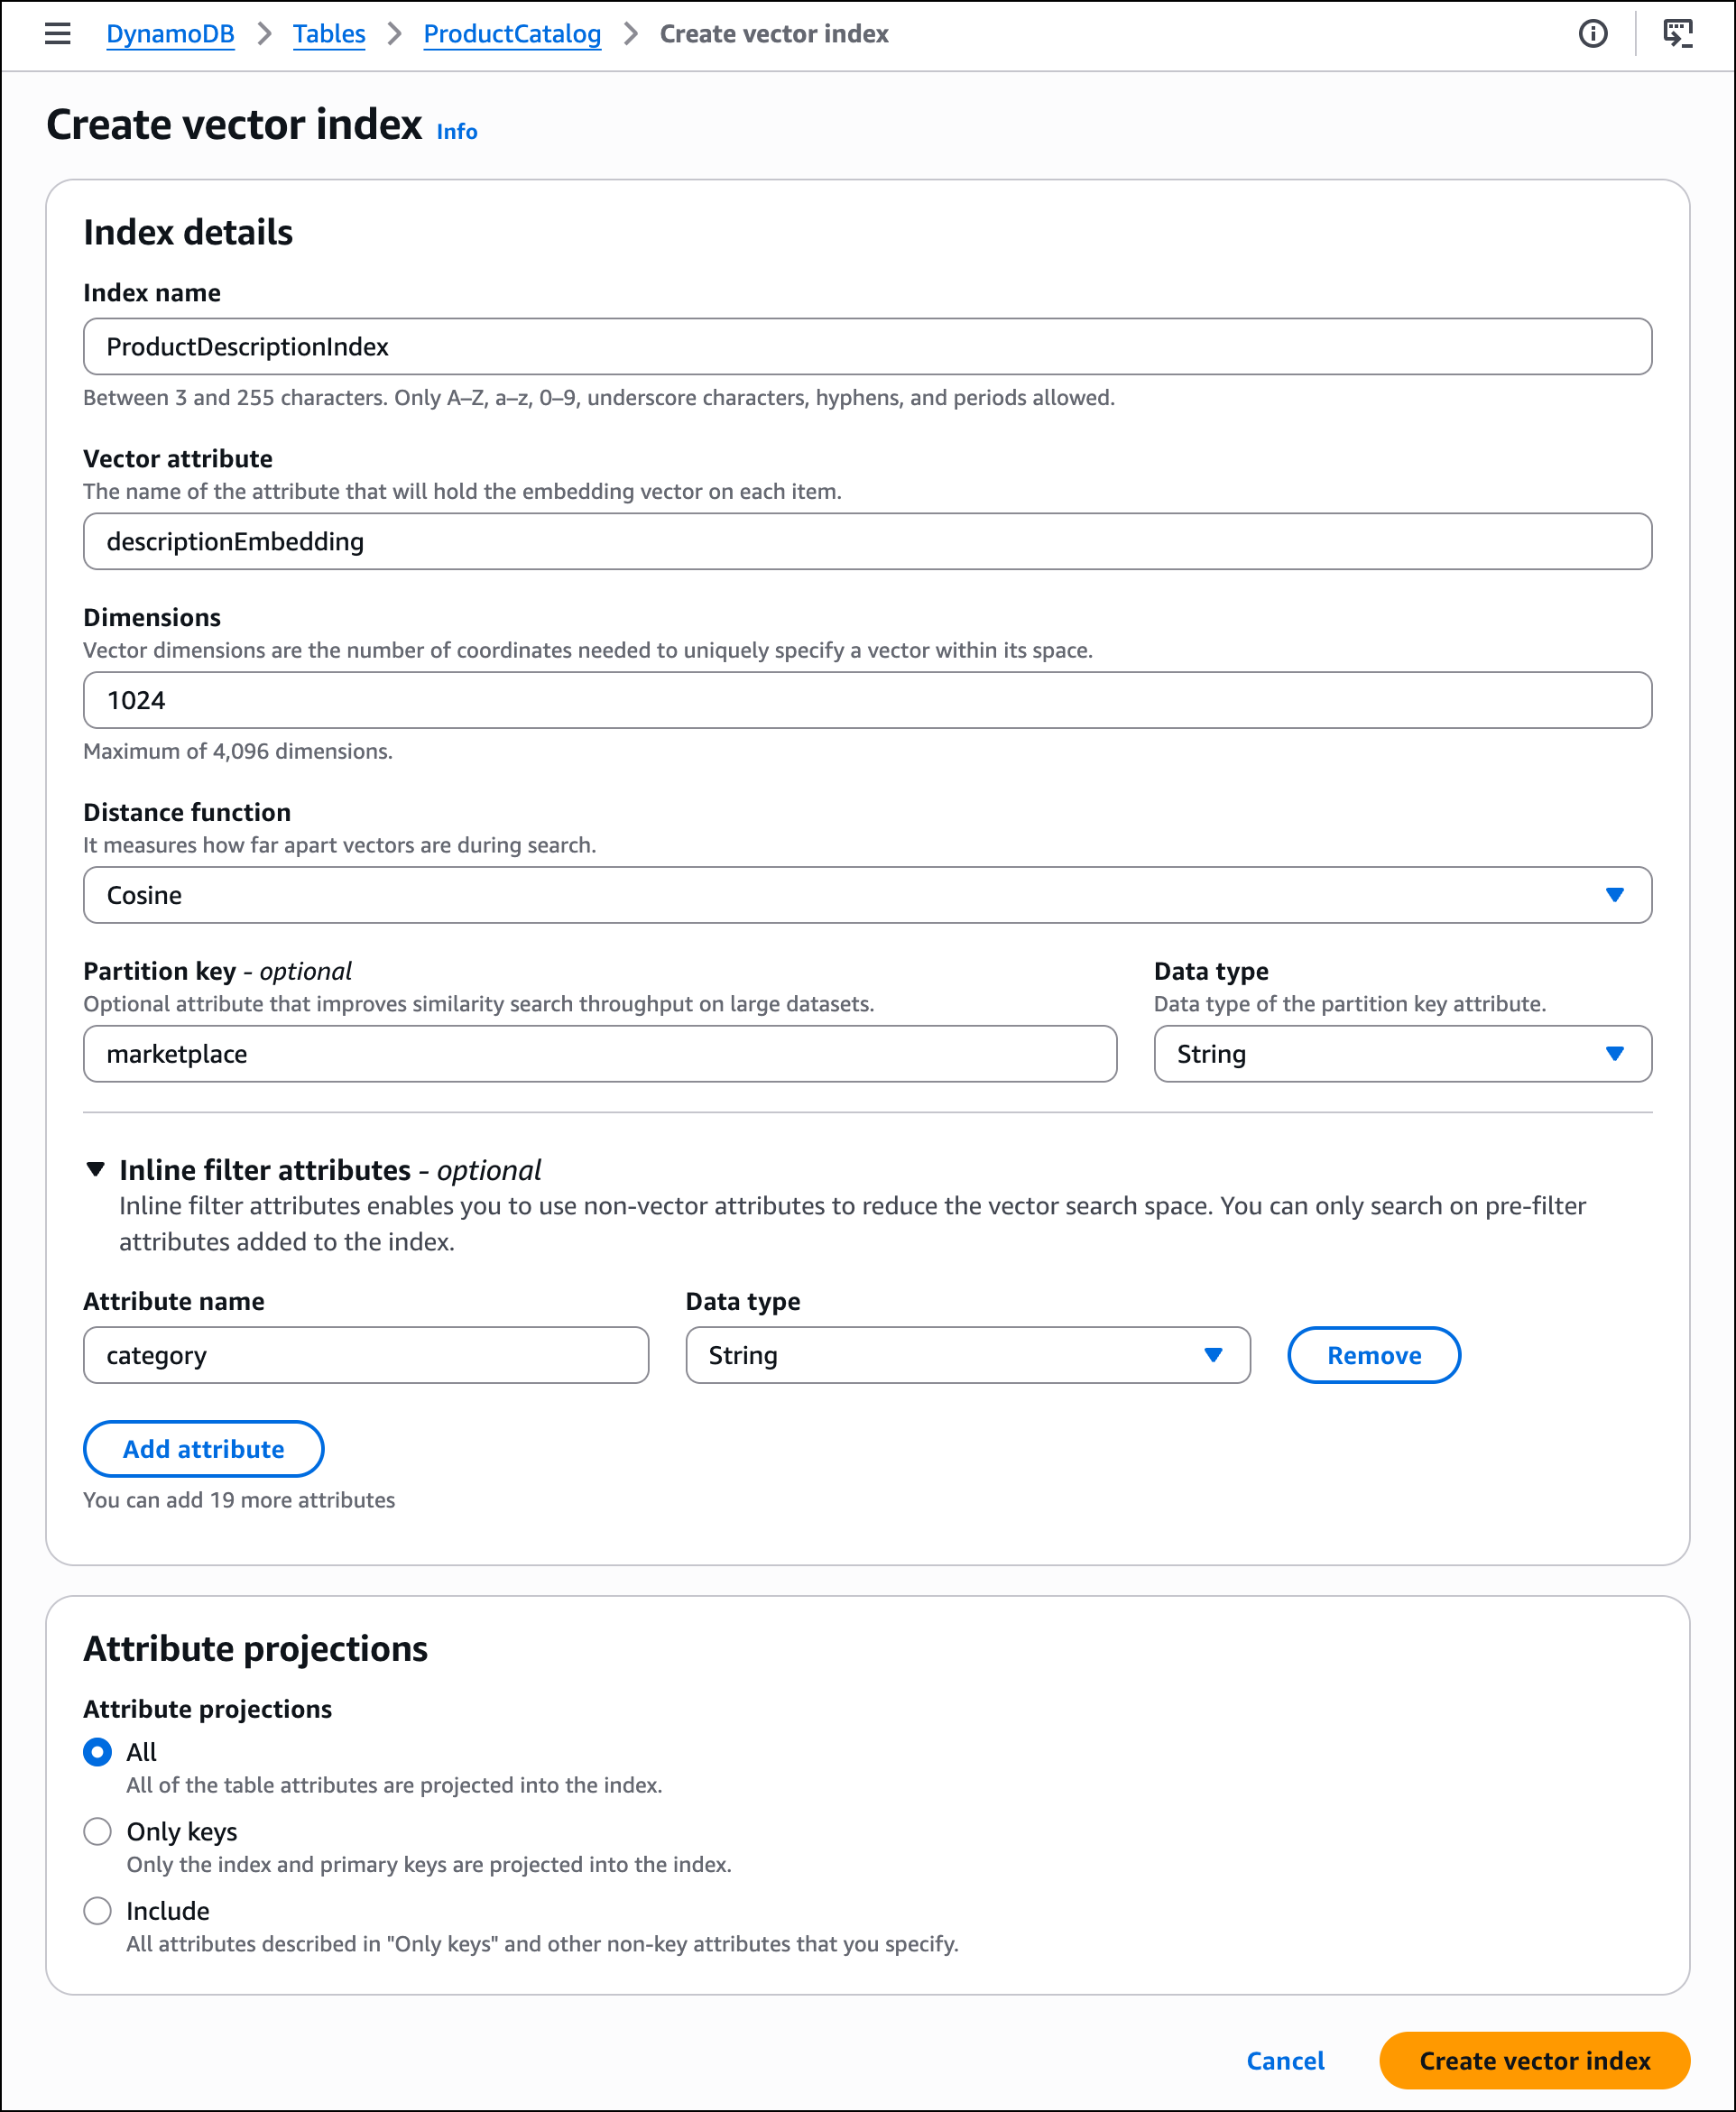
Amazon DynamoDB正式推出向量搜索功能,支持将向量嵌入与操作数据共同存储,无需复制到独立向量数据库。该功能提供毫秒级延迟、高召回率,可扩展至数万亿向量,支持最多4096维度及多种距离函数。用户可通过控制台或API创建向量索引并运行相似性搜索,适用于语义检索、推荐系统等场景,已在所有商业AWS区域可用。
Redis 通过向量嵌入实现语义记忆搜索,存储和检索事实,使AI代理能跨会话记住用户偏好,避免重复提问。相比关键词搜索,它更擅长处理同义表达,但需结合混合搜索弥补盲区。快速检索和新鲜度至关重要,Redis 提供低延迟和更新机制,减少推理成本,提升用户体验。
本文介绍了向量嵌入在语义搜索和AI代理中的应用,强调其通过数值表示相似性来提升检索效率。Redis Iris结合语义缓存、向量搜索和代理记忆,优化数据存储和检索速度,适用于大规模应用。有效的检索层和模型选择对生产价值至关重要。
AI购物助手利用大语言模型和向量嵌入技术,提高产品搜索和个性化推荐的效率。主要分为语义搜索引擎、RAG助手、代理系统、视觉搜索和个性化引擎五类。关键在于快速、准确的数据检索,以确保助手的可靠性和用户信任。Redis平台通过内存优先架构,提供低延迟的向量搜索和语义缓存,优化购物体验。
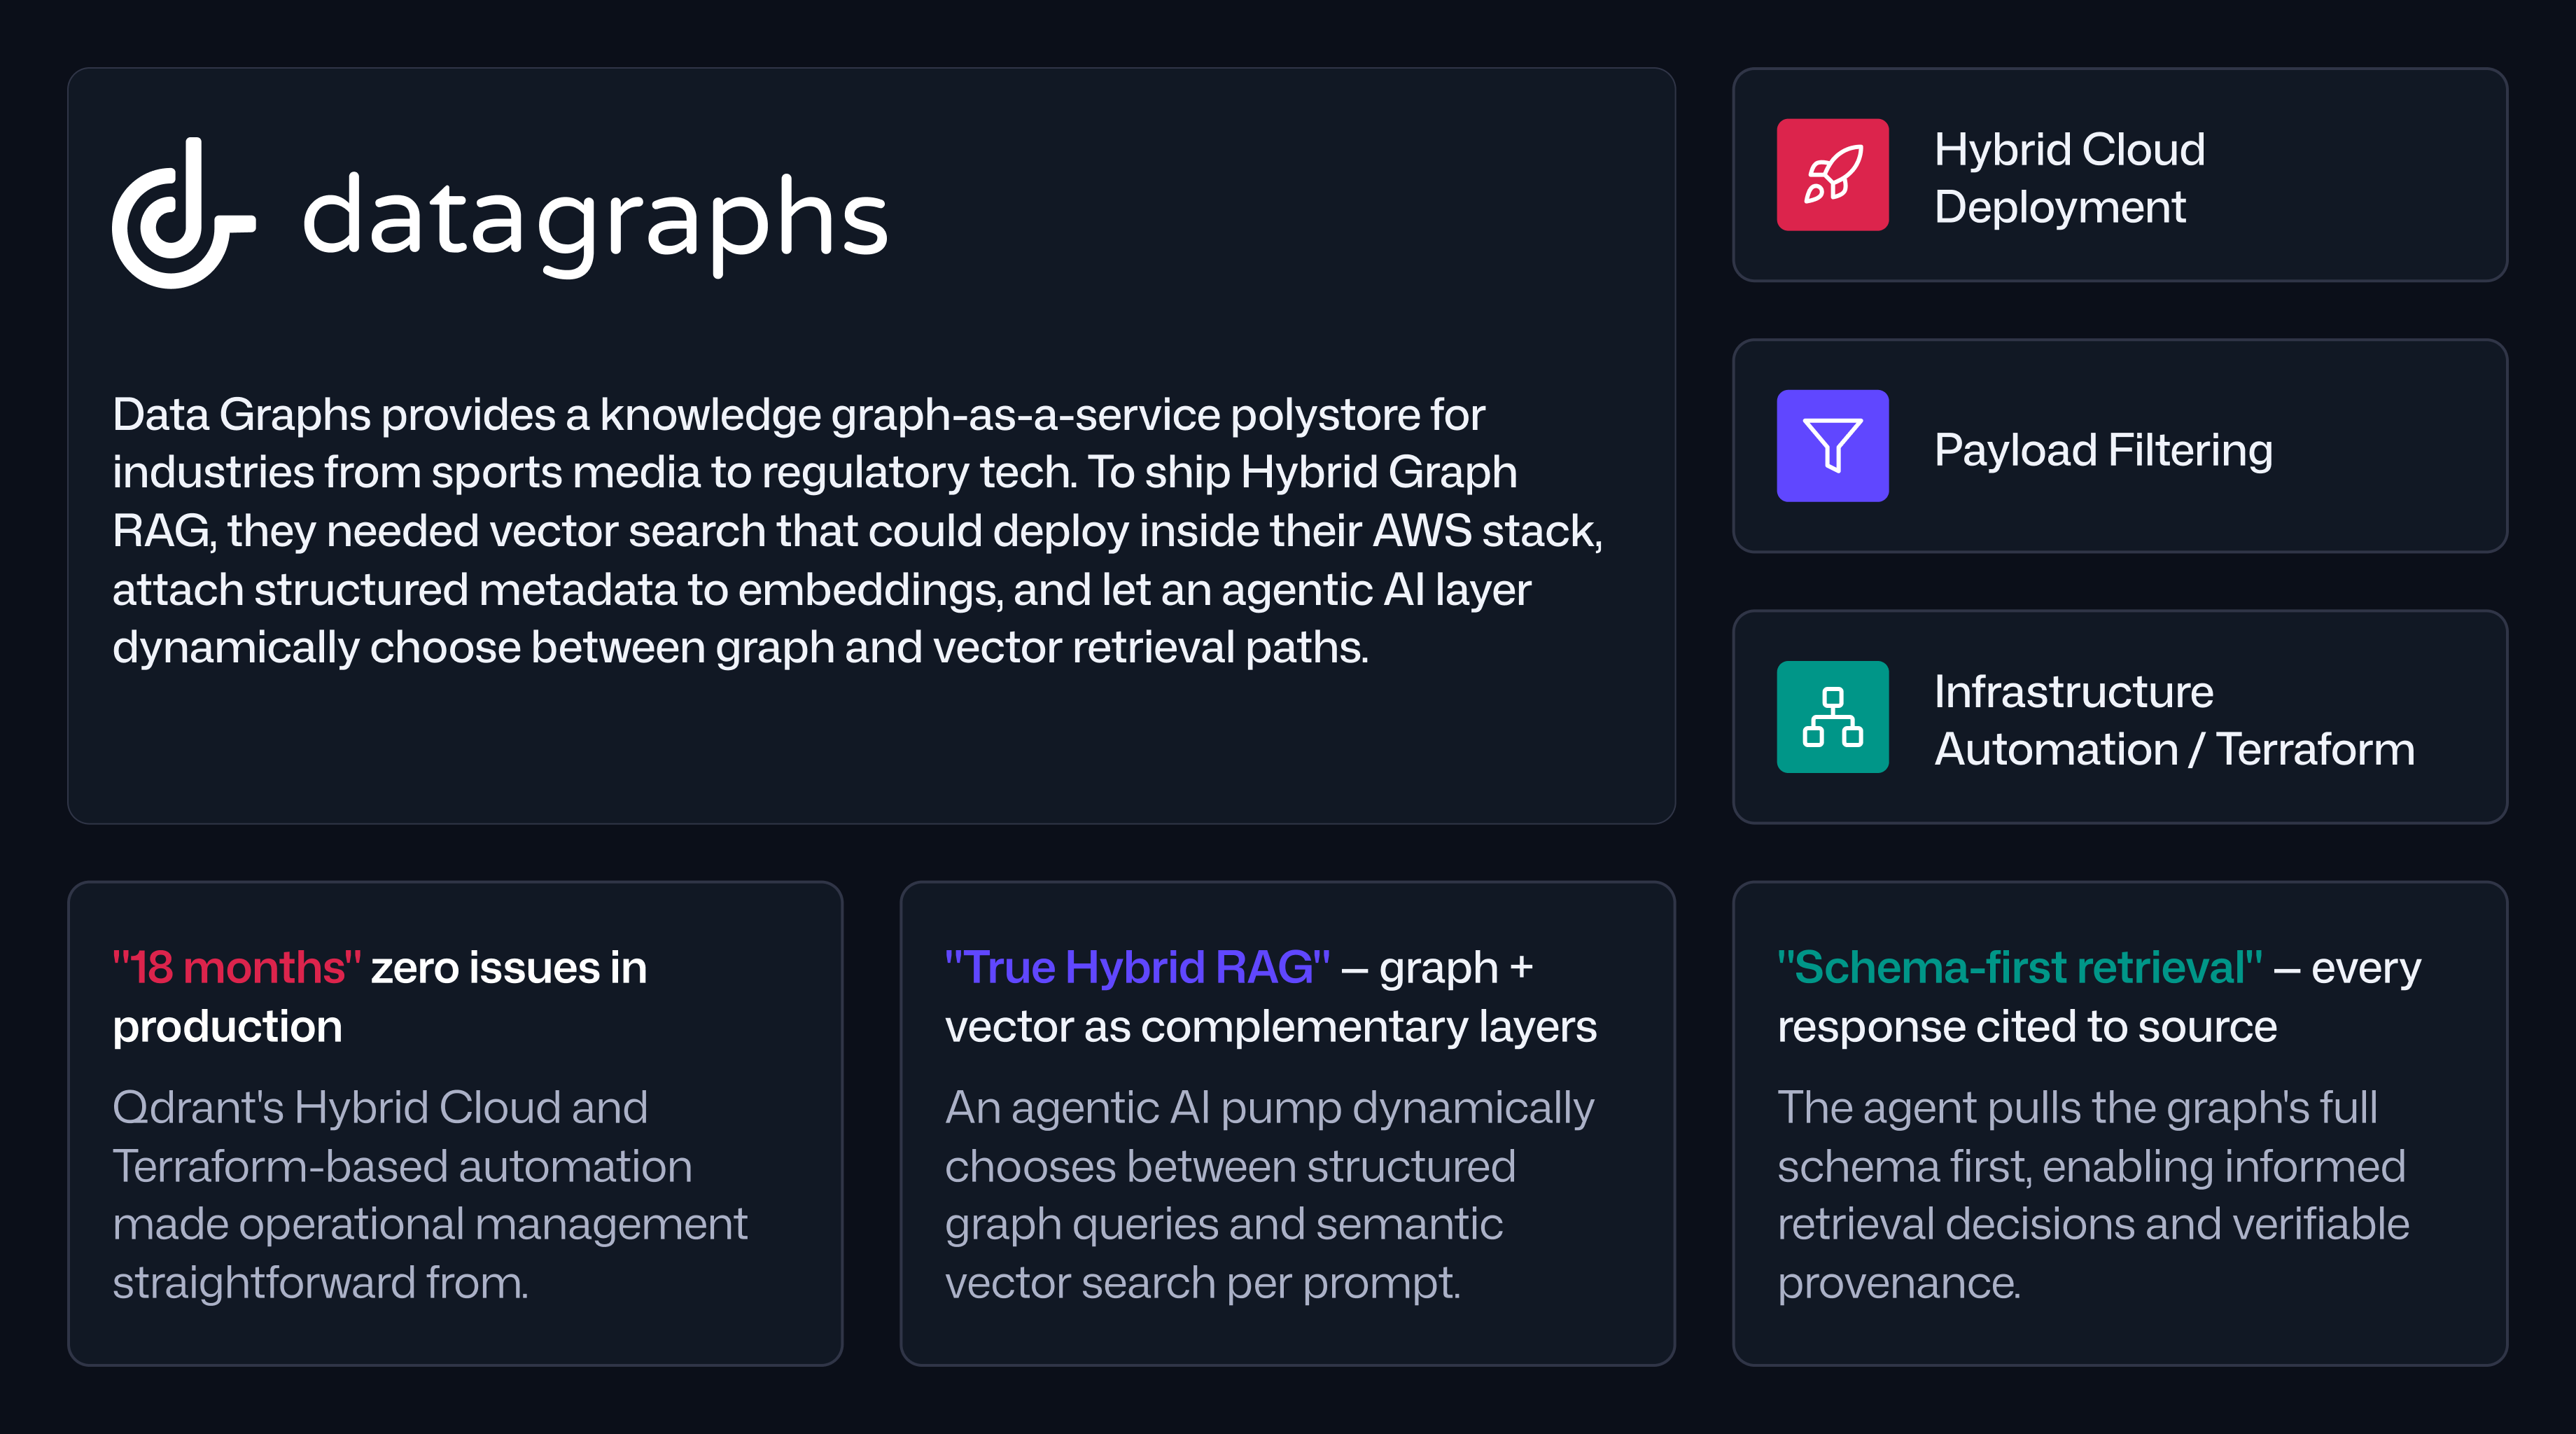
Data Graphs是一家英国公司,提供结合图数据库、全文搜索和向量嵌入的知识图谱服务。其平台通过Qdrant实现混合检索,克服了仅依赖向量检索的局限性,支持复杂数据的高效检索。经过18个月的生产运行,Qdrant表现稳定,未来将向机器优先的方向发展。
pgvector是一个开源的PostgreSQL扩展,支持存储和搜索向量嵌入,适用于语义搜索和推荐功能。它简化了相似性搜索,能够处理数百万到数千万个向量,支持余弦相似度,并可与Postgres全文搜索结合使用。对于高性能需求,pgvectorscale可扩展pgvector的能力。
向量嵌入生成器将文本、图像或代码等原始输入转换为数值向量,使相似概念聚集在一起,从而实现基于意义的检索,如聊天机器人和推荐引擎。选择合适的生成器对检索质量和基础设施成本至关重要。生成器通常基于变换器架构,能够捕捉上下文和意义。在评估生成器时,需要考虑模型选择、部署方式及其与实际数据的匹配程度。Redis提供快速的向量搜索和混合检索,适合生产环境。
pgvector是一个开源Postgres扩展,支持在关系数据中存储和查询向量嵌入。最近的改进,如HNSW索引,提升了查询性能。成功使用pgvector需要基准测试、调整索引参数,并结合SQL操作来优化性能,特别关注冷缓存性能和数据分区策略。
语义搜索利用向量嵌入和变换神经网络理解用户意图,提升搜索体验。它能处理模糊查询,降低零结果率,适合SaaS应用。实现时需构建嵌入生成基础设施和向量存储,Redis可支持快速向量搜索。主要应用于企业知识管理、客户支持和开发工具,适合自然语言表达需求的场景。
本文讨论了语义缓存的概念,旨在解决聊天机器人API费用过高的问题。通过使用向量嵌入,语义缓存能够基于查询的含义而非文本匹配,提高命中率,降低成本,加快响应速度。文章还提供了实现语义缓存的步骤和Python代码示例,强调其在客户支持和常见问题解答中的应用价值。
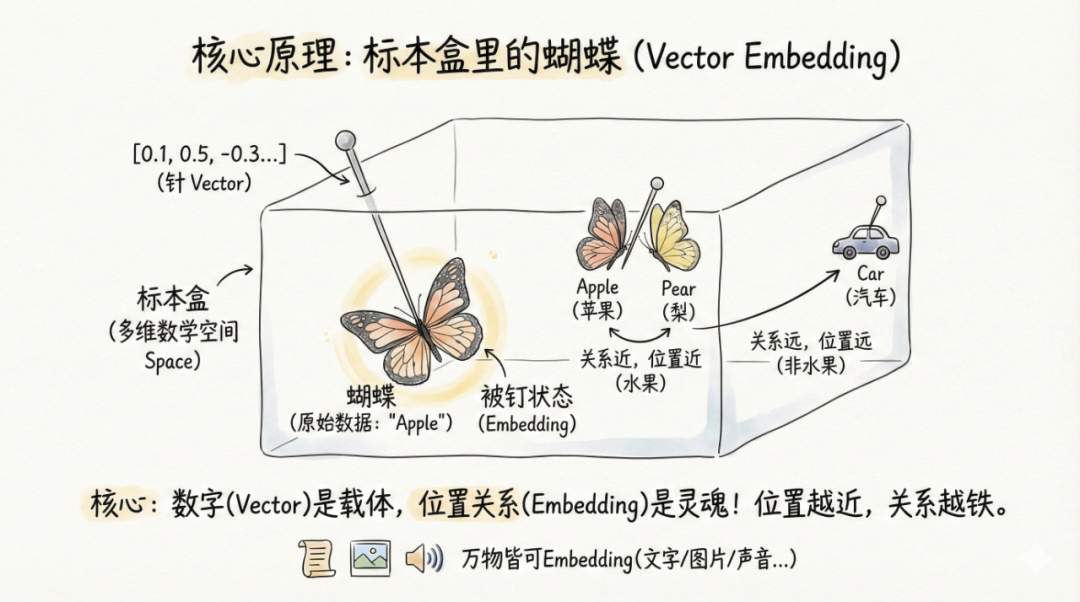
99%的人在使用AI时误以为AI能理解语言,实际上AI只处理数字。要掌握AI,需理解向量嵌入,它将概念映射到数学空间。AI通过向量运算理解关系,掌握坐标系是未来的竞争优势。
向量嵌入技术将复杂数据转化为低维向量,提升检索质量。多模态嵌入实现跨模态对齐,打破数据类型壁垒。向量数据库高效管理和查询高维向量,支持AI应用。Milvus是开源的分布式向量数据库,适合大规模相似性搜索,通过优化索引提升检索精确性与效率。
本文介绍如何使用pgEdge Vectorizer将文档分块并生成向量嵌入,以实现基于语义的搜索。通过将文档拆分为小块,系统能够更精确地检索相关内容。pgEdge Vectorizer作为PostgreSQL扩展,自动处理文档更新和嵌入生成,简化管理流程。
检索增强生成(RAG)为大型语言模型提供了访问自有数据的有效方法。通过检索相关内容并提供上下文,RAG能够生成基于实际内容的准确响应。本文将介绍如何使用PostgreSQL构建RAG服务器,包括文档加载、生成向量嵌入和API服务器部署。
本文介绍了构建检索增强生成(RAG)系统的七个步骤,包括数据预处理、文本分块、生成向量嵌入、检索信息、结合上下文、生成答案及完整流程运行,以提高大型语言模型(LLM)的回答准确性。
向量数据库专为存储和搜索高维向量而设计,改变了处理非结构化数据的方式,适用于推荐系统和图像检索等应用。它们通过计算向量间的距离,快速找到相似数据。常见的向量数据库包括Milvus、Pinecone和Weaviate,支持与机器学习工作流的无缝集成。理解向量嵌入是使用这些数据库的基础。
本文介绍了如何构建一个简单的Web应用程序,快速生成数据的向量嵌入并存储在Azure Cosmos DB中。该应用使用Go语言开发,支持多种文档类型,便于向量搜索和检索增强生成(RAG)工作流。用户需配置Azure Cosmos DB和Azure OpenAI的信息,并通过服务主体管理权限。配置完成后,用户可以上传文件并生成向量嵌入,以便后续查询。
本文介绍了人工智能中的基本概念,包括分词、向量嵌入、位置编码和自注意力机制。分词将文本拆分为可处理单元,向量嵌入为单元赋予数学意义,位置编码帮助模型理解词序,自注意力机制使模型根据上下文理解词义。这些概念是现代大型语言模型理解和处理语言的基础。
构建检索增强生成(RAG)应用时,需准备数据,包括将非结构化数据分块、生成向量嵌入并存储在向量数据库中。可以通过本地模型、API或框架生成向量嵌入,使用Transformers.js等工具在Node.js中实现特征提取。选择合适的方法和模型对数据处理至关重要。
完成下面两步后,将自动完成登录并继续当前操作。