实时AI扩展面临延迟、准确率下降等问题,根源多在数据管道而非模型。尾延迟源于架构,如锁竞争;特征陈旧导致准确率下降;向量索引退化影响召回率。需分离读写路径、训练与服务,监控指标,并采用支持高并发写入和弹性扩展的数据库,避免“厄运循环”。
调优 Qdrant 集合前,需明确检索目标并建立带标注查询集。先检查向量是否已索引、过滤字段是否有 payload 索引、稀疏向量的 IDF 修饰符和 BM25 avg_len 是否正确,否则结果无效。按症状从低成本开始改动:先调融合方法,再扩检索深度,最后加稀疏预取或重排器。指标决定效果,nDCG、MRR、Recall 各有适用场景。用重采样估计增益区间,并在新查询上验证,避免过拟合。
turbovec是一个基于Rust的向量索引库,采用谷歌TurboQuant算法,提供Python绑定。它通过量化压缩将内存占用减少8-10倍,速度比FAISS快3.4倍,支持无训练、增量持久化和过滤搜索。适用于本地RAG应用,但需注意输入向量需L2归一化,且不同配置下召回率表现不一。
本文介绍Neo4j图数据库中全文索引与向量索引的边界:两者均由Lucene驱动,不自动被Cypher规划器选用,需显式调用过程或SEARCH查询。全文索引用于分词匹配与打分,向量索引用于嵌入近邻搜索。内存上依赖OS缓存而非page cache,分数不可跨源比较,可与图拓扑扩展结合实现混合检索。
本文介绍Postgres与pgvector实现混合搜索(向量相似度+标量过滤)的模式。核心问题是向量索引返回近似排序结果,无法直接与WHERE过滤结合。pgvector 0.8提供迭代索引扫描,但需权衡召回率与性能。其他方案包括:部分HNSW索引(适合低基数稳定过滤)、过采样后过滤(适合高基数)、缓存响应(适合重复查询)。文章还提供EXPLAIN诊断方法和选择指南。
pgvector v0.8.0将HNSW索引作为PostgreSQL索引访问方法实现,向量以varlena存储于8KB页中,与业务表共享WAL、缓冲区和VACUUM。相比Milvus,它支持同进程事务和SQL,但受限于页装箱、默认后过滤和资源争用。选型应基于隔离需求与生命周期管理,而非单纯比较ANN算法性能。
本文介绍了从自建Elasticsearch迁移到Amazon OpenSearch Service的实践,重点在于向量索引的迁移与Amazon Bedrock集成。讨论了两条迁移路线:保留原有Embedding模型的搬运和更换模型的全量重建。详细阐述了如何在OpenSearch中集成Amazon Bedrock Titan V2,包括应用端调用和Neural Search两种方式,并评估了迁移后的向量搜索精度。
Knowhere 是 Milvus 的向量索引执行引擎,集成了 Faiss、Hnswlib 和 Annoy 等库,支持软删和多种相似度计算。它通过统一的 VecIndex 接口处理索引构建与查询,优化性能并简化开发流程,同时支持自动 SIMD 选择以提升计算效率。
HNSW是主流向量数据库默认的近似最近邻索引算法,通过分层图结构实现高效搜索。文章从NSW图出发,详细推导HNSW设计,给出C语言实现,讨论参数调优、距离计算优化,并对比Vamana等竞品。HNSW在精度、速度、内存间取得平衡,搜索复杂度为O(log N),但内存消耗大,动态更新和过滤搜索仍是挑战。
CockroachDB团队开发了C-SPANN向量索引,以满足分布式数据库的需求。该索引将向量视为普通表数据,支持实时更新和分片,避免了中心协调和大内存缓存的依赖。C-SPANN结合K均值树结构和增量更新技术,实现高效的近似最近邻搜索,适用于需要向量与事务数据共存的多租户应用。
本周的Python周刊介绍了Python 3.15的新特性、PyCon US 2026的回顾,以及一些有趣的项目和工具,如基于Rust的向量索引和AI量化交易平台。周刊强调了社区贡献的重要性,并鼓励读者关注新发现。
本文探讨了RAG(检索增强生成)中的存储与检索层,重点介绍向量索引算法的选择和量化方法,以及2024-2026年工业界的趋势。文章分为四部分:算法底层、产品选型、工程实操和图RAG与趋势,提供实用的参数和代码示例。向量检索主要使用近似最近邻(ANN)算法,推荐HNSW作为工业标准,并结合量化技术以降低内存占用。最后,GraphRAG结合知识图谱与向量检索,提升多跳推理能力。
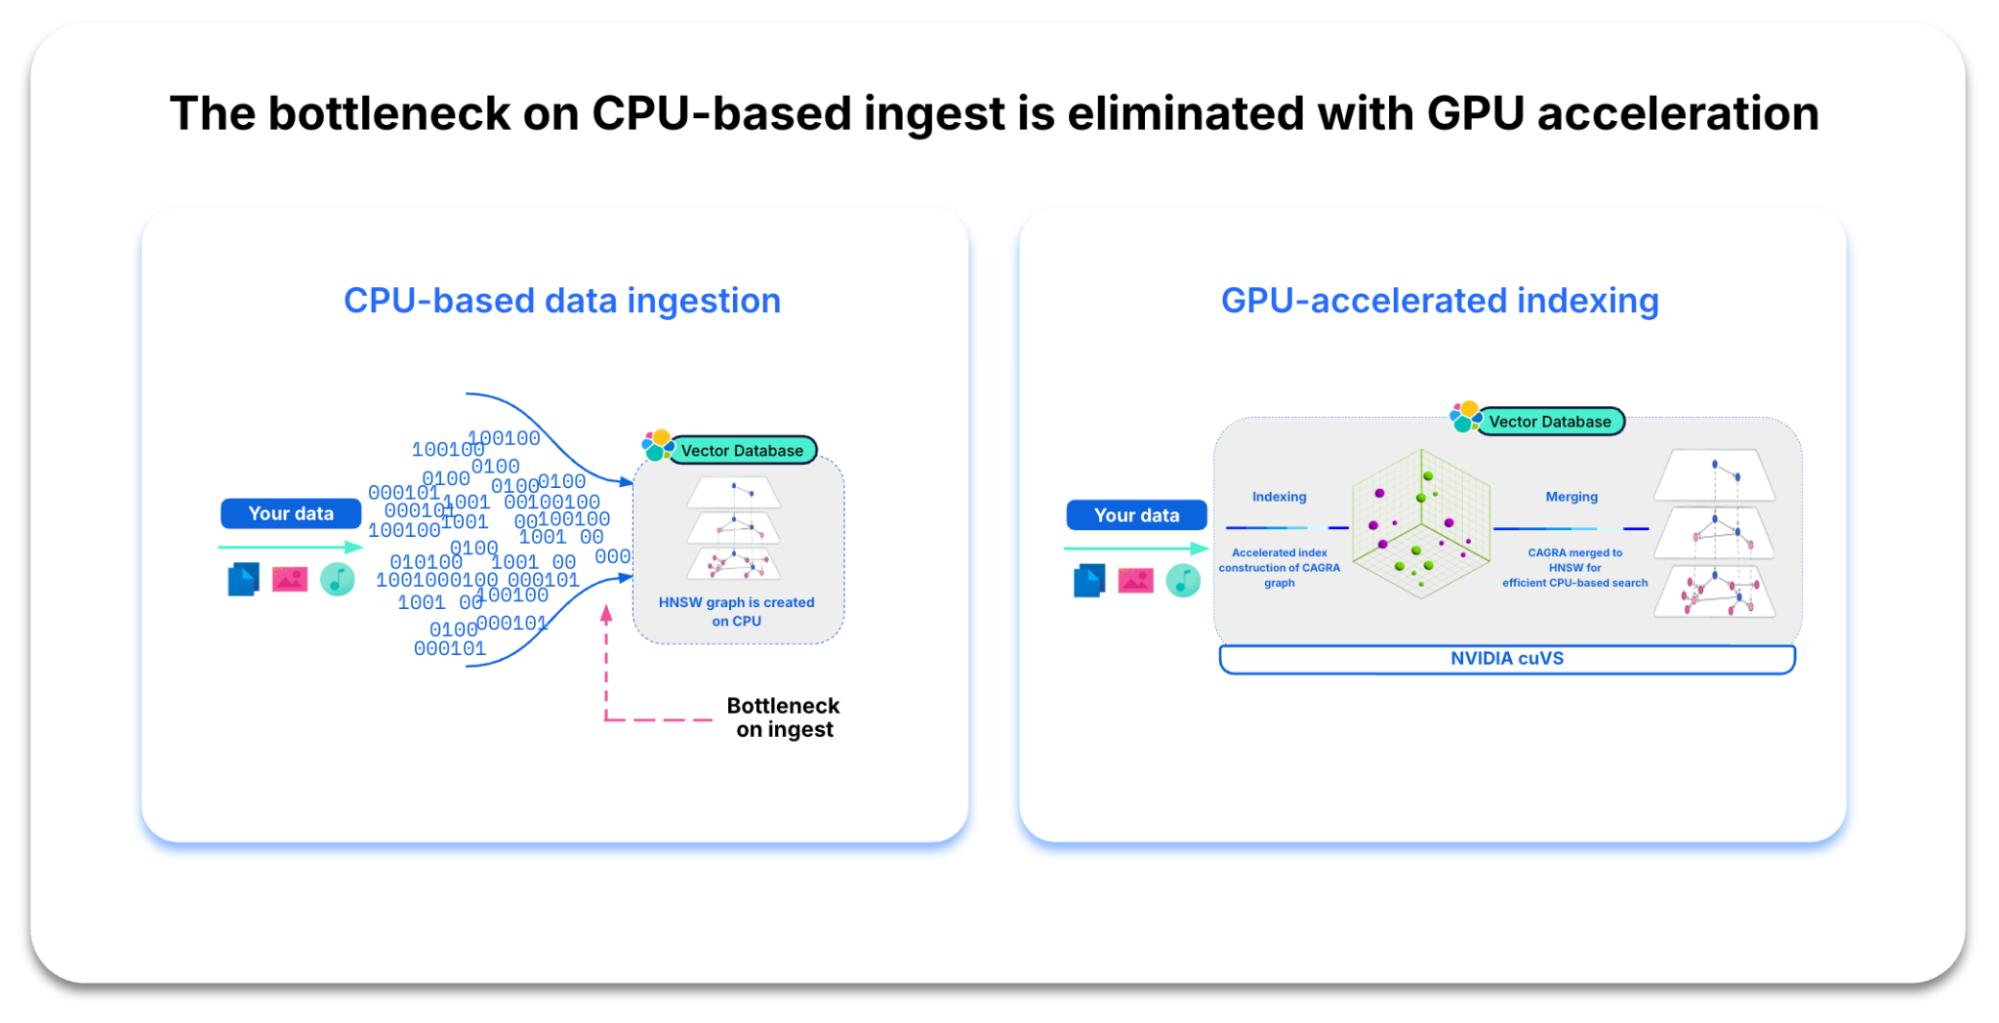
Elastic与NVIDIA合作推出基于GPU加速的向量索引,提升企业AI应用效率,向量化速度可达CPU的12倍,助力快速数据检索与处理,推动现代AI解决方案发展。
Elastic 9.3.0发布,增强工作流自动化、加速向量索引及开放标准支持。集成NVIDIA cuVS,索引速度提升12倍,查询高维向量更快。ES|QL语言升级,简化数据处理。整合OpenTelemetry,提升可观察性,支持Kubernetes等架构的安全监控,确保威胁识别。
Redis 8集成了多种向量索引算法,支持高效的大规模相似性搜索,优化数据结构以提升搜索速度,适用于语义搜索和推荐系统等应用。
随着现代嵌入模型的发展,向MySQL添加向量索引面临挑战。现有研究多集中于内存数据结构,而关系数据库需处理更大数据集。我们设计了一种混合向量索引,结合内存与磁盘存储,确保在高性能和高召回率下持续更新索引。通过优化插入、合并和重新分配操作,我们的实现满足了用户对关系数据库索引的一致性期望。
萨尔瓦托·桑菲利波(“antirez”)重返Redis,担任社区推广者。他于2009年创建Redis,2020年因家庭原因暂时离开。现在,他希望通过编程演示和文档撰写,重塑Redis与社区的关系,并推动新功能的发展。他对AI和向量索引的兴趣将促进Redis的未来。
Antirez在离开Redis近四年后重返项目,旨在改善公司与社区关系,推动Redis核心发展。他对开源软件持宽松态度,认为许可变更不是主要问题,并计划引入向量索引等新功能以适应AI发展。
安德烈·瓦斯涅佐夫讨论了二进制量化在向量索引中的重要性。二进制量化可以显著减少存储大小并提高处理速度,尽管并非所有模型都兼容。通过将浮点元素转换为二进制表示,计算得以简化,效率得以提升。虽然会损失一些精度,但可以通过过采样等技术进行补偿。目前,OpenAI模型在二进制量化方面表现优异,而其他开源模型的兼容性较差。
本文介绍了使用pgvector进行AI的性能问题,包括查询是否使用索引、列表大小是否适当、索引和更改设置所需的内存是否足够。文章还介绍了向量索引如何使用列表,以及如何选择索引的列表大小。最后,文章总结了如何确保查询使用索引、如何选择最佳列表大小以及如何确保索引有足够的内存。
完成下面两步后,将自动完成登录并继续当前操作。