AWS团队开发了开源Rust分布式框架Hydro,并推出智能体运行时Infinity。团队指出,智能体编写代码和测试的速度已超出人工审查能力,且行为不可预测。为此,他们在智能体“信任区”之外设置共享正确性检查,如Rust借用检查器和Hydro的编译期错误检测,并探索幂等性等通用防护规则。Hydro目前仍属早期版本,适合高吞吐、低延迟的团队。
Sprinklr推出营销AI Agents(Beta),由构思、创意、活动执行、合规、社区、预算优化6个互联Agent组成,构成营销编排层。它们基于统一付费媒体、自有渠道、达人营销等数据的上下文层,可独立或协同运行,帮助团队将活动上线周期从6至8周大幅缩短,以抓住热点。其差异化在于可溯源、可定制、渐进落地及数据广度。Sprinklr称这是迈向智能体客户体验的一步。
华盛顿大学与NVIDIA等提出RFD4-Proteina,这是首个面向多组分生物大分子复合物的潜空间推理序列-结构联合生成模型。该模型构建统一的化学-构象潜空间,结合流匹配生成与内在/外在双重推理,并用可微Rosetta能量约束原子重构,突破了分子类型窄、序列-结构解耦、伴侣刚性等瓶颈。基准测试中其设计成功率与效率显著优于基线,湿实验验证了高特异性结合蛋白、糖基化与磷酸化识别,并首次从头设计出催化药物合成反应的酶。
平台工程研究显示,强制采用平台的团队中62.2%称实现了大部分或全部目标,而自愿采用者仅27.5%。但行业正转向自愿采用,强制平台占比从63.0%降至45.9%。强制采用常与领导支持、预算信心相伴,且在预算不确定时更有效。建议强制推行安全、成本等政策,而平台采用本身保持自愿,让平台成为满足政策的最省力路径。
极致的“老二次元”,该怎么“极致地”去做“老二次元”游戏?今天,蛮啾网络旗下的3D大世界RPG《蓝色星原:旅谣》宣布定档11月26日。前段时间,《蓝色星原:旅谣》(下称《蓝色星原》)结束三测,官方在测试结束后公布了一组玩家数据。整个三测期间,所有玩家累计参与了2449万场战斗,其中出战次数最多的伙伴是涂山小玉,共登场1202万次;在战斗和养成之外,大家一共拍摄了5.2万张照片,被拍摄次数最多...
Vercel Pro 团队可免费领取一年域名,新增 .co、.studio、.company 等后缀,可选顶级域名共 16 种。每队限领一个,不含高级域名,次年起按结算时标价自动续费。领取地址为 vercel.com/domains,详情见免费域名 FAQ。
Vercel工具栏的Flags Explorer工具可查看当前生效的功能标志并与团队共享,支持按分支或URL设置。界面已重新设计,集中展示覆盖设置、分支建议和相关操作;分支设置覆盖后,访问部署的用户会通过对话框收到推荐。该工具适用于所有套餐。
生数科技于10月21日启动为期半个月的Motubrain 2.0具身模型训练全流程公开直播,展示预训练、后训练、Agent任务执行及递归自我改进四个环节,旨在打开具身模型训练的“黑盒”,让外界观察能力形成与试错过程,推动Physical AI研究的透明化。
Claude Code团队博客分享AI时代代码审查经验:代码审查仍必不可少,但改为先由AI审查验证、再由人确认,以减轻人工负担。审核路径按风险分级,低风险改动自动合并,高风险需人工批准。提交者须对自己的改动负责,不能推责给AI。开发者可借助AI阅读完整源码、理解项目全貌,从而维持对项目的理解。
Cognizant与Google Cloud扩大合作,成立Gemini前沿能力团队,由逾1.8万名工程师支持,推动AI智能体从试点走向量产。初期聚焦系统现代化、开发者体验、业务流程智能体化及网络防御,基于MCP和Model Armor构建安全架构。Cognizant还开展Gemini技能认证,计划今年向10万名员工部署Gemini,未来扩至20万人。
微软设计团队为Windows Insider项目12周年发布纪念壁纸,共5套深浅色版本合计10张,分辨率4000×4000,风格源自Surface设计。该项目始于2014年9月,与首批Windows 10预览版同期推出,让用户提前体验新功能并反馈问题,助力Windows持续改进。壁纸已在微软设计团队官网提供下载。
通衍灵智依托北京通用人工智能研究院,探索以参数化学习和持续进化为核心的Personal AI:在共享基础模型上,用轻量Personal LoRA承载个人与企业的专属能力,并通过RSI递归自我改进机制筛选有效反馈、增量更新、评估回滚,避免错误积累;同时以TIP训推并行和Paged LoRA优化训练与推理成本。目标是让企业经验沉淀为可迁移的智能资产,降低对单一模型底座的依赖。
在GopherCon EU 2026的Go团队圆桌上,团队透露AI使安全报告从每月5-10份增至100-200份,其中多为Bug而非漏洞。团队应对措施包括重新分级、内部用LLM提效、安全左移,但不效仿Linux公开所有AI发现的漏洞。团队将AI视为“初级工程师”,强调人必须在回路中。路线图包括后量子签名(Go 1.27已发布crypto/mldsa)、SIMD、高层密码学API及对LLM友好的生态。团队坚持克制原则:每个API都是永久承诺,“No is temporary, yes is forever”,以保持Go为最简单的主流语言。
Anthropic的Claude Code团队超90%代码由AI生成,逐行人工审查成为瓶颈,遂转向人机协同分级审查:提交前由Claude自测并交叉验证,PR先经AI审查、多智能体投票过滤误报,再按风险分级决定人工审批人数,低风险变更可零人工合并。配合自动化安全检查、合并队列、功能开关与快速回滚,PR量翻倍而回滚率降超40%。人类专注方向决策、高危代码与最终责任,事故复盘持续转化为评测集以优化审查器。
Linux内核的小改动可能导致PXC/Galera工作负载出现写入放大,拖慢集群性能。运维人员需关注内核版本变化,评估其对数据库写入路径的副作用。
Vercel与SaaStr用AI代理替代入站销售,团队从10人缩至1.25人,回报达32倍。AI正消解销冠依赖的信息差、加工差和执行密度优势,使其从护城河变为基础设施;但研究显示AI反而放大顶尖销售的判断力,价值从标准化执行转向判断、信任与系统编排。
Databricks研究团队利用AI Runtime(AIR)支持AI Functions等模型研发,覆盖数十亿至近万亿参数模型的训练。AIR提供GPU健康检查与故障隔离、快速启动、MLflow实验追踪和Unity Catalog数据治理,并支持智能体驱动研究,使训练任务量增长8倍,提升实验效率。
多数工程团队低估了自建AI知识系统的难度,六个月后往往成为平台团队的长期负担。生产级管道包含捕获、验证、组织、治理、交付五个阶段,每阶段都需持续维护,成本随AI栈复杂度增加。自建向量库虽可行,但构建受治理的可信知识管道极难,多数公司应选择采购而非自建。
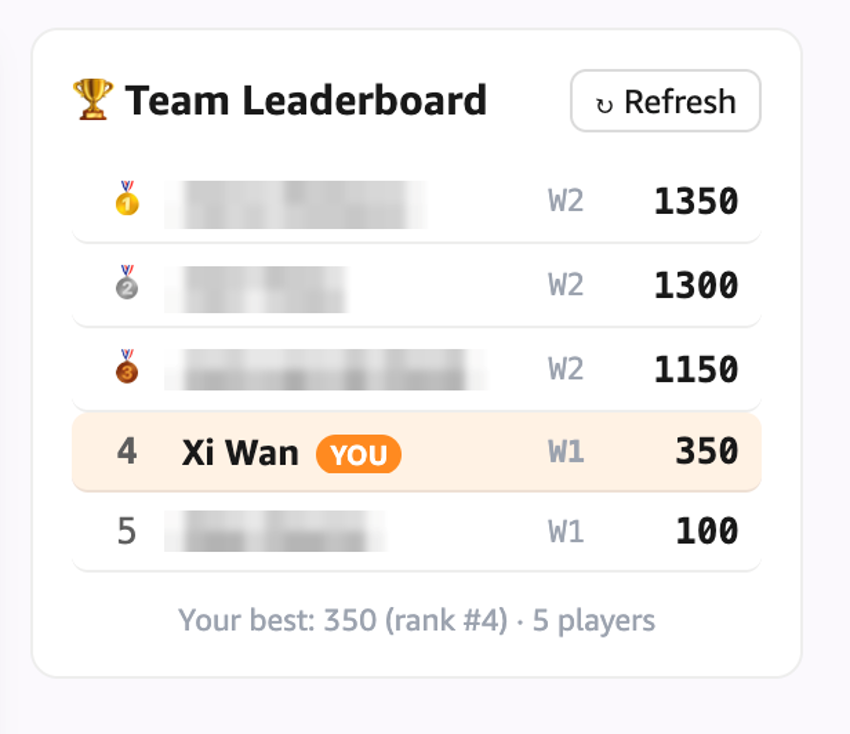
本文介绍用 Amazon Quick 以自然语言对话构建游戏原型:依次完成 2048、抽卡概率模拟器、卡池 A/B 对比、横版闯关和 Three.js 射击原型,并发布为带团队排行榜的应用及英文版,全程约 100 分钟。该方式适合策划与运营快速验证玩法数值,但仅限原型演示,不能替代正式游戏引擎。
昆仑万维发布Matrix-Game 4.0,为全球首款可在单张RTX 5090上实时运行的开源游戏世界模型。其核心思路是“给视频模型套上Harness”:游戏引擎用代码维护世界状态与规则,视频模型仅负责实时生成画面,从而实现盾牌耐久、血量结算等真实游戏逻辑。通过结构草图、动态Caption、少步蒸馏等优化,按键响应不到0.15秒,60帧运行,显存峰值约18.5GiB,并开源模型与代码。
完成下面两步后,将自动完成登录并继续当前操作。