《逻辑哲学论》以七个主命题为骨架,主张世界是事实而非事物的总和;事实经思想与命题构成逻辑图像,命题是基本命题的真值函项,可说者由此穷尽。逻辑形式、伦理与人生意义不可言说,只能显示,故须沉默。文章还梳理对象、事态、图像、说与显等概念,并提醒勿将本书误读为维也纳学派消灭形而上学的宣言。
AI SDK 的 HarnessAgent 层现已在所有适配器(如 Claude Code、Codex、Cursor 等)中支持图像输入。用户可在标准消息格式的内容数组中混合传入文本与图像文件,由底层视觉模型处理。文中还提供了使用 Codex 适配器描述图片的代码示例。
本文综述Agent Harness研究:作为连接大模型、工具与执行环境的运行框架,它影响智能体任务执行的稳定性与安全性。文章精选8项研究,涵盖编码智能体的Harness设计实证、终端动作采样验证、机器人操作接口、可编程视觉生成、安全约束定制、Harness工程能力评测、递归自我改进及持续自进化机制,指出Harness正成为智能体执行效果与安全的关键基础设施。
Canva推出首款自研AI图像模型Canva Craft,采用先生成设计方案再出图的两阶段架构,提升精确度、一致性和可控性。该模型支持最高2K分辨率和30多种宽高比,擅长生成含清晰文字和精准物体布局的复杂图像,训练数据来自平台数百万人工模板。目前全球开放,可在Dream Lab试用,未来将推出更快版本并支持AI代理接入。
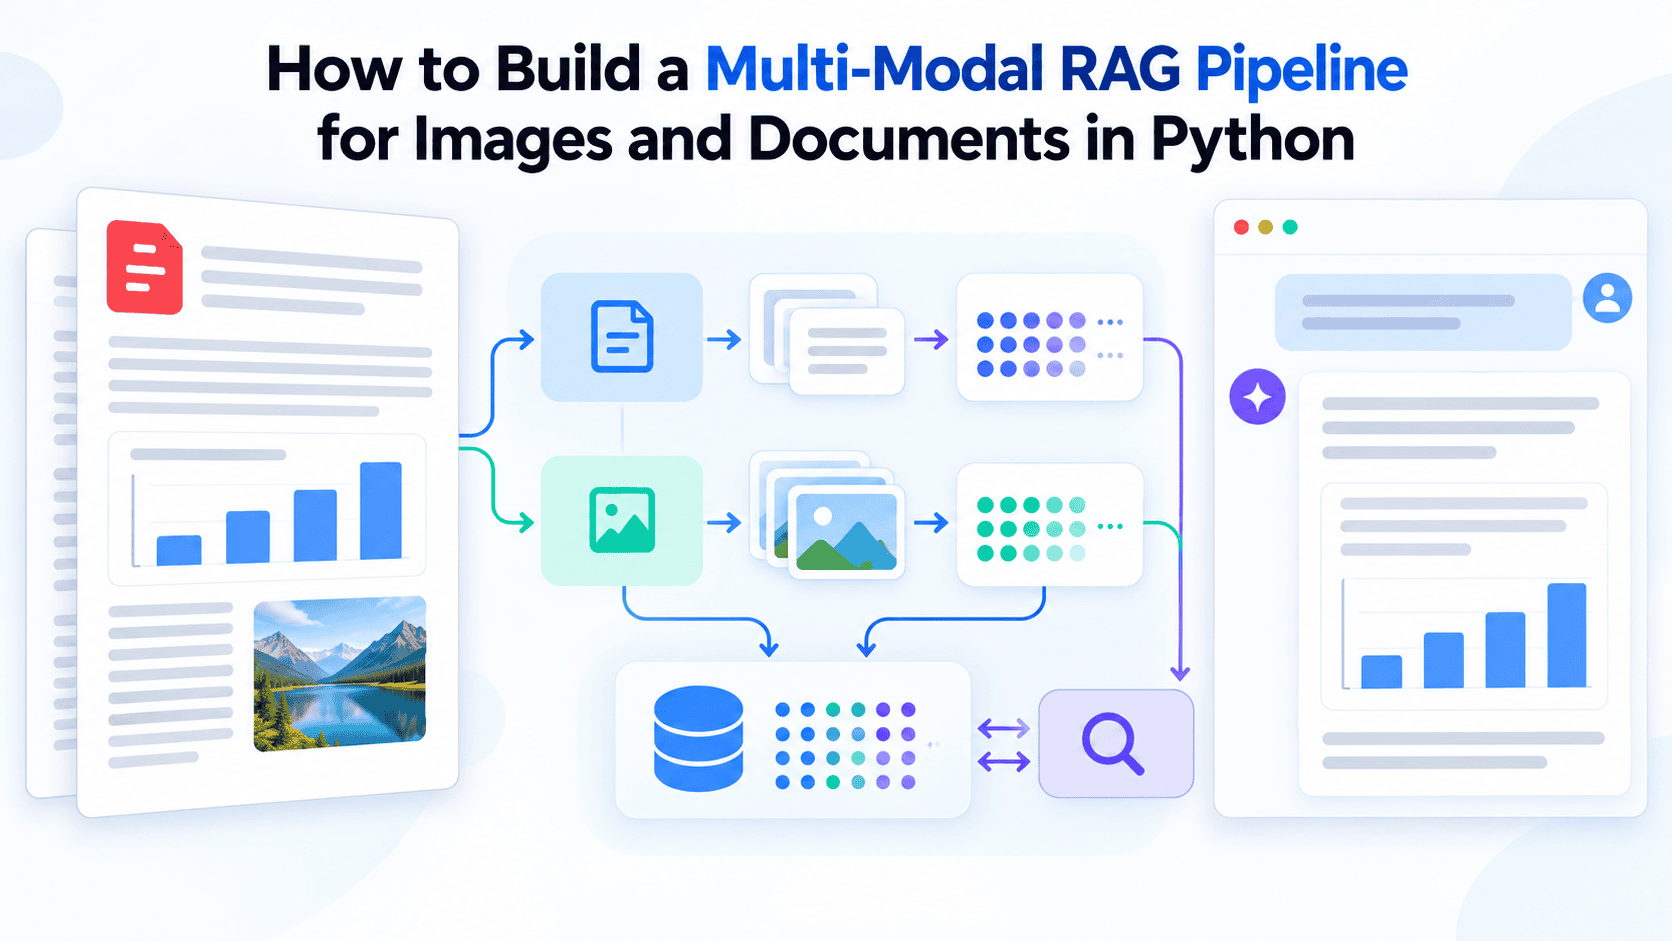
本文介绍用Python构建多模态RAG流水线以处理含图表和图片的复杂PDF,流程分四步:用unstructured库将PDF解析为文本块和图片;用GPT-4o为每张图片生成可检索的文字摘要;用MultiVectorRetriever建立向量库与文档库双存储,以ID关联摘要与原始内容;查询时检索文本和图片摘要,将原始图片与文本一并传给GPT-4o生成有据可依的答案。该方案适用于研究报告、财务文档等图文混排文件。
微软改版Windows 11照片应用,新图库整合本地、OneDrive和iCloud照片,支持按日期、人物筛选及自然语言搜索。编辑器重建后启动提速25%,新增AI消除、Relight多光源调整,支持HDR及HEIC、WebP原格式编辑。查看器界面更简洁,改进HDR显示,新增SVG支持,启动提速15%。目前仅面向Insider测试用户。
演员Mia Goth的经纪人批评Instagram允许一张AI生成的假照片传播。该照片显示她穿着印有离婚暗示文字的T恤,由冒充她的认证粉丝账号发布,并被媒体和网友当作真实内容转发。经纪人称已多次投诉,但该账号仍获蓝标认证,质疑平台为何优先传播伪造图像而非保护公众人物肖像。
Cloudflare 发布开放权重决策模型 Clef-omni,基于 Qwen3-Omni 的 30B-A3B MoE,采用 Apache-2.0 许可,每百万 tokens 收费 0.15 美元。该模型可在一次调用中对文本、图像、音频和视频打分,省去转录步骤,在意图分类任务上领先,但推理与工作流评测弱于 Clef。同时 Clef-flash 降价至 0.038 美元,托管 Clef 迁移 SGLang 后提速 1.7 至 2 倍。
本文梳理图形渲染岗高频面试题:一帧从App到屏幕分五阶段,UI线程录制绘制指令,RenderThread转为GPU调用,SurfaceFlinger合成,HWC优先硬件叠加,最后扫描送显。BufferQueue是生产者消费者队列,双缓冲易卡顿,三重缓冲以空间换流水线连续。OpenGL ES管线分八阶段,仅顶点与片元着色器可编程。
文章介绍用 Java 17 的 HttpClient 调用 Gemini 图像理解接口,从发票图片中提取发票号和金额。做法是让模型只返回单行 JSON 候选字段,再由 Java 校验格式、金额上限和必填项,避免把模型输出直接当财务事实。文中给出完整示例代码,并提醒密钥用环境变量、金额用 BigDecimal、HTTP 200 不等于识别成功,仅适合低风险预填和人工审核场景。
本文介绍用 Java 17 调用图像模型实现商品视觉问答:将图片 URL 与问题放入同一请求,要求模型区分可见事实、推断与未知。代码用 HttpClient 调用 Responses API 并解析 output_text。文章强调模型可能误读容量等信息,关键结论需人工核验,适合低风险咨询,不适用于医疗、安检等判定。
富士胶片将于2026年7月22日发售A3尺寸压力图像分析装置Prescale Station A3。该设备支持A3尺寸读取,可检测12英寸晶圆压力,并兼容圆形压力测量胶片Round Prescale。其通过高分辨率FA相机拍摄压力胶片,结合图像处理技术分析保存数据,具备自动合格判定功能,整合读取、分析、判定、记录流程,助力制造现场质量管理。
火狐浏览器v156.0正式版发布,新增libjpeg-turbo IDCT缩放功能,使大型JPEG图像解码速度翻倍、内存占用降低约20%。同时修复了内置VPN断网、DoH下HTTP网站无法加载、画中画字幕异常、B站MP4 FLAC音频播放失败及书签拖出文件夹等问题。用户可通过自动更新或离线安装包升级。
OpenAI发布GPT Images 2.5,推出Flare和Sunburst两款模型。Flare速度更快,延迟比GPT-Image-2低50%,是多数应用的默认选择;Sunburst精度更高,适合高端视觉工作流,但生成时间更长。两者token费率相同,但OpenAI未说明如何估算实际每张图成本,开发者需自行试验,权衡Sunburst的精度是否值得额外时间和成本。
ChatGPT Images 2.5更新聚焦于模板、草图、评论式编辑和提示词分享,强调在同一作品上迭代而非重新生成。文章指出其提升细节与编辑精度,但无具体速度数据,且模板不支持Work模式。对创作者而言,这使视觉生产更协作,瓶颈转向视觉标准,独立开发者原型路径更短。核心是图像生成具备软件状态感,但需注意同质化风险,建议通过小规模对照测试验证实用性。
OpenAI推出Images 2.5图像生成模型,生成速度提升50%,改进透明背景和多轮编辑稳定性,能更好保留主体特征。API提供Flare和Sunburst两种模型,分别面向通用和精细编辑场景。目前每周生成图片超30亿张。
OpenAI更新ChatGPT图像生成工具,新增Sketch功能,用户可绘制草图并据此生成图像,还能对图像部分添加评论以修改细节。新版本ChatGPT Images 2.5提升光照和纹理效果,编辑指令遵循更佳,生成速度比2.0快50%,现已向桌面、移动和网页端用户开放。
蚂蚁集团开源统一图像生成与编辑模型LLaDA-Image,含6B参数,提供Base和Turbo两版本,支持文生图、编辑及中英文渲染。Turbo采用蒸馏技术,仅需4步采样。模型在Qwen-Image-Bench上得分领先,并公开权重与推理代码。
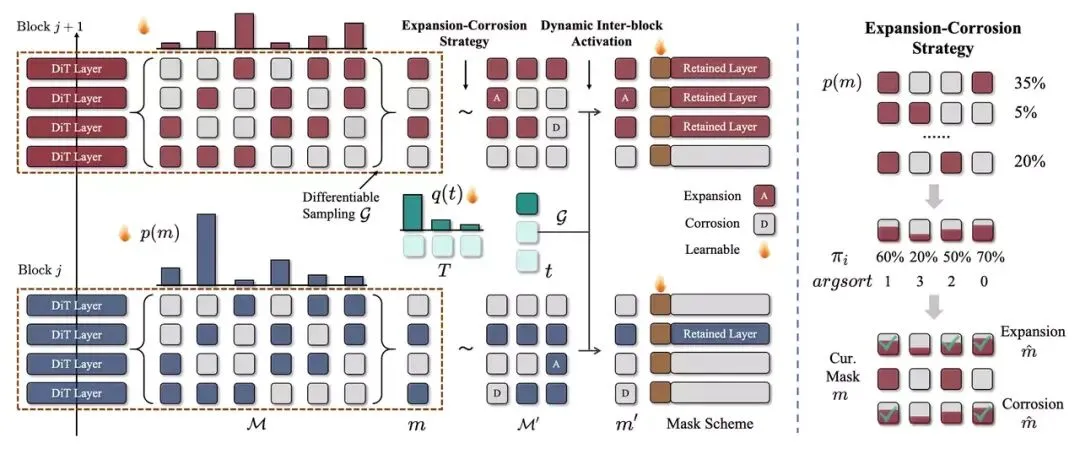
TinySR是一种面向真实世界图像超分辨率的轻量级扩散模型,通过深度剪枝、动态块间激活和扩张-腐蚀策略,实现比教师模型快5.68倍、参数减少83%的加速。同时轻量化VAE,移除时间与提示模块并预缓存。实验显示其在保持画质的同时,推理速度和成本优势明显,适合移动端部署。
Google推出AI图像工具Google Pics,基于Nano Banana模型,提供精准编辑、对象分割、图像内文字修改与翻译、协作及多版本生成等功能。它集成于Workspace的Docs、Slides和Drive中,用户无需切换应用即可创作和编辑图像,面向AI Pro、Ultra订阅者及多数商业客户开放。
完成下面两步后,将自动完成登录并继续当前操作。