本研究探讨了利用深度学习和强化学习解决机器人抓取问题的方法,重点在于域随机化和从仿真到实际的转移。提出的算法显著提高了抓取成功率,验证了机器人在复杂环境中的操作能力。
本文探讨了在模拟环境中学习机器人操作策略的方法,强调数据增强和域随机化的优势。研究表明,因果推断和干预可以提高学习算法的鲁棒性和泛化能力。此外,提出了优化图像识别模型和数据增强策略的方法,利用对比语义对齐损失和贝叶斯公式改善分类性能。
综述探讨深度强化学习中的模拟到真实环境迁移,重点包括域随机化、域自适应、模仿学习、元学习和知识蒸馏。通过多样化数据集训练、对抗训练、观察映射与行为克隆、任务蒸馏及策略组合,实现跨域策略迁移,提升机器人在新领域和任务中的成功率与样本效率。
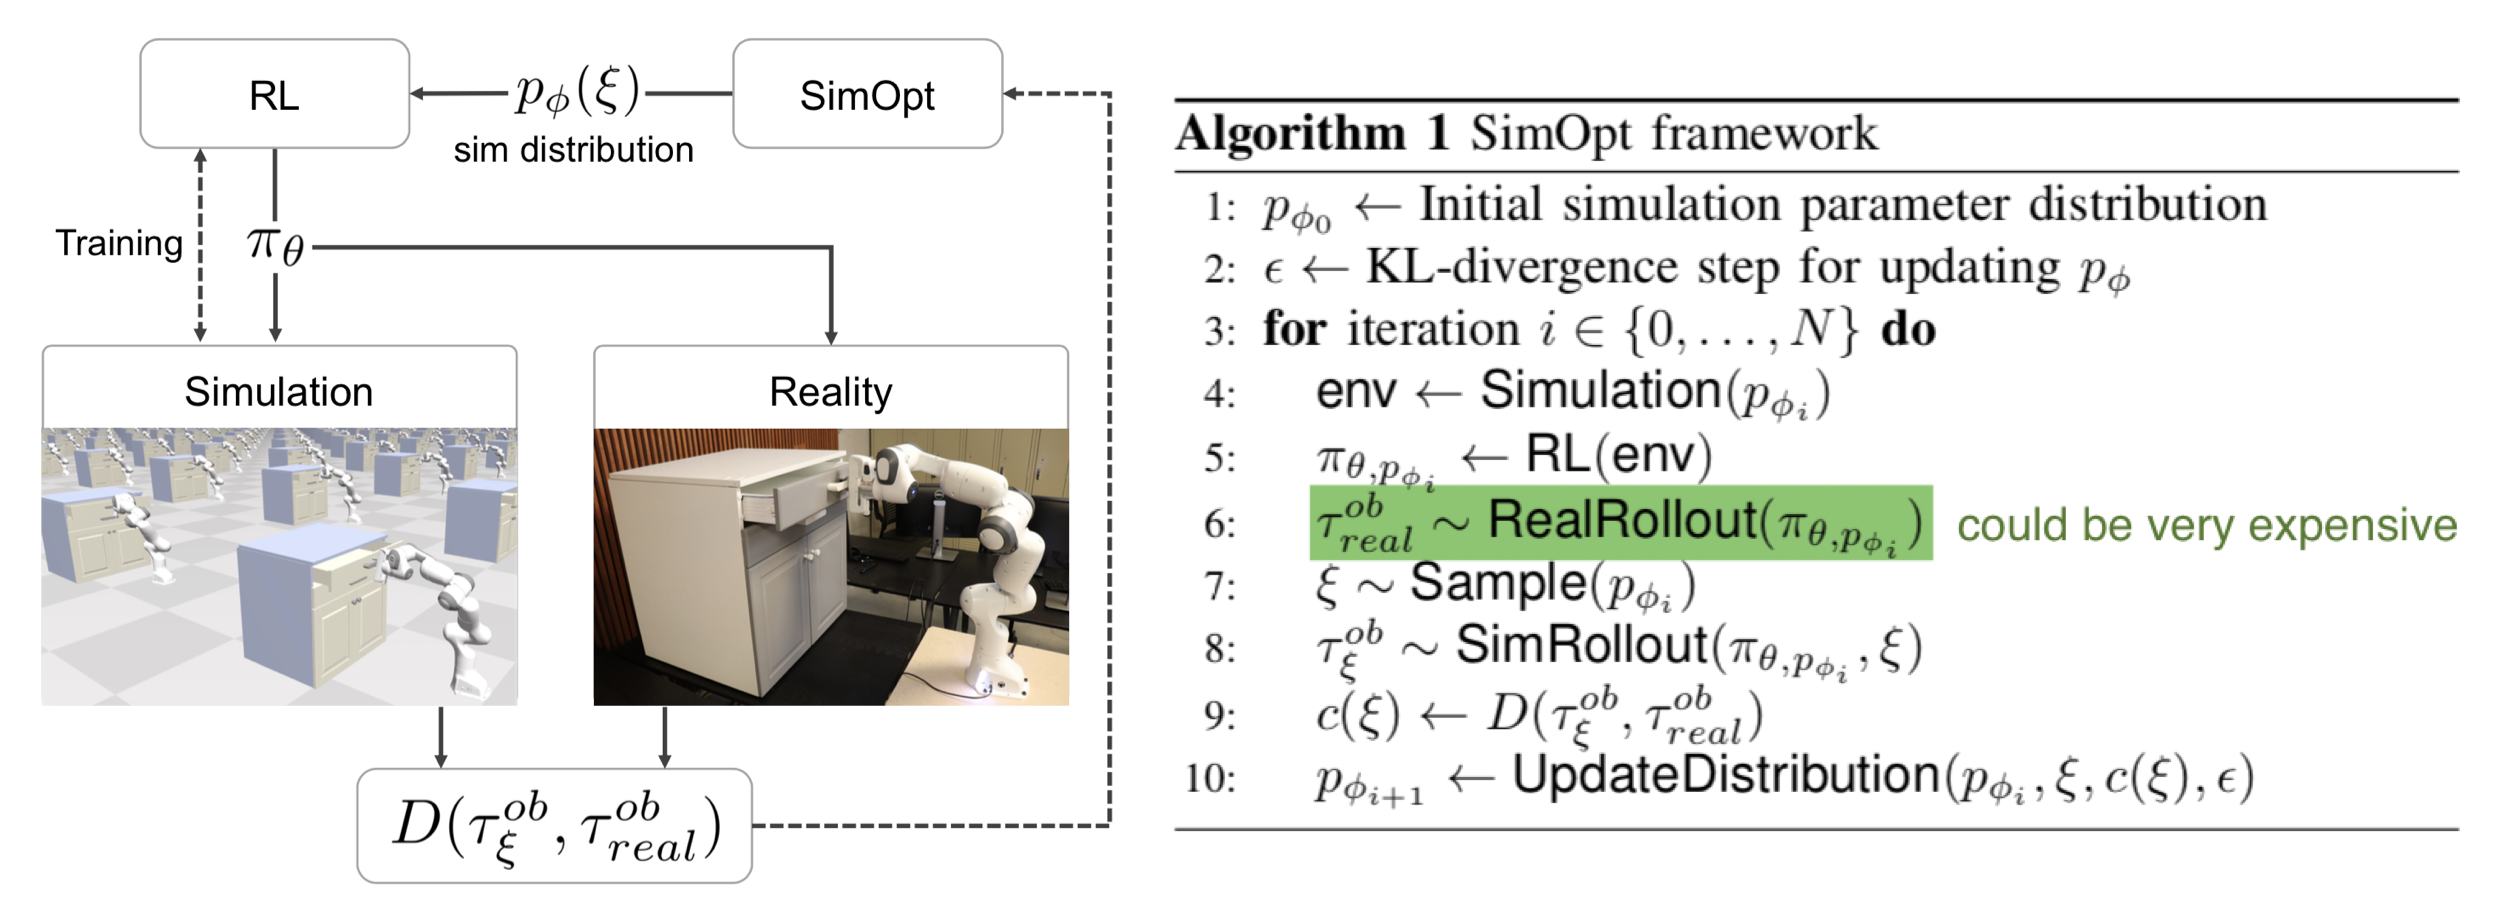
机器人学中,仿真到现实迁移因物理参数不一致和建模误差存在“现实鸿沟”。域随机化通过在仿真中随机化视觉外观与物理动力学参数训练策略,使其泛化到现实,无需真实数据,优于需真实样本的域适应。引导式域随机化利用任务反馈、真实数据或仿真器优化随机化分布(如AutoAugment、SimOpt、RCAN),以提升迁移效果。
我们开发了世界首个在物理机器人上运行的垃圾邮件检测AI,基于模拟训练和域随机化技术,使深度神经网络能够有效识别现实中的垃圾邮件。未来计划扩展到钓鱼邮件检测。
完成下面两步后,将自动完成登录并继续当前操作。