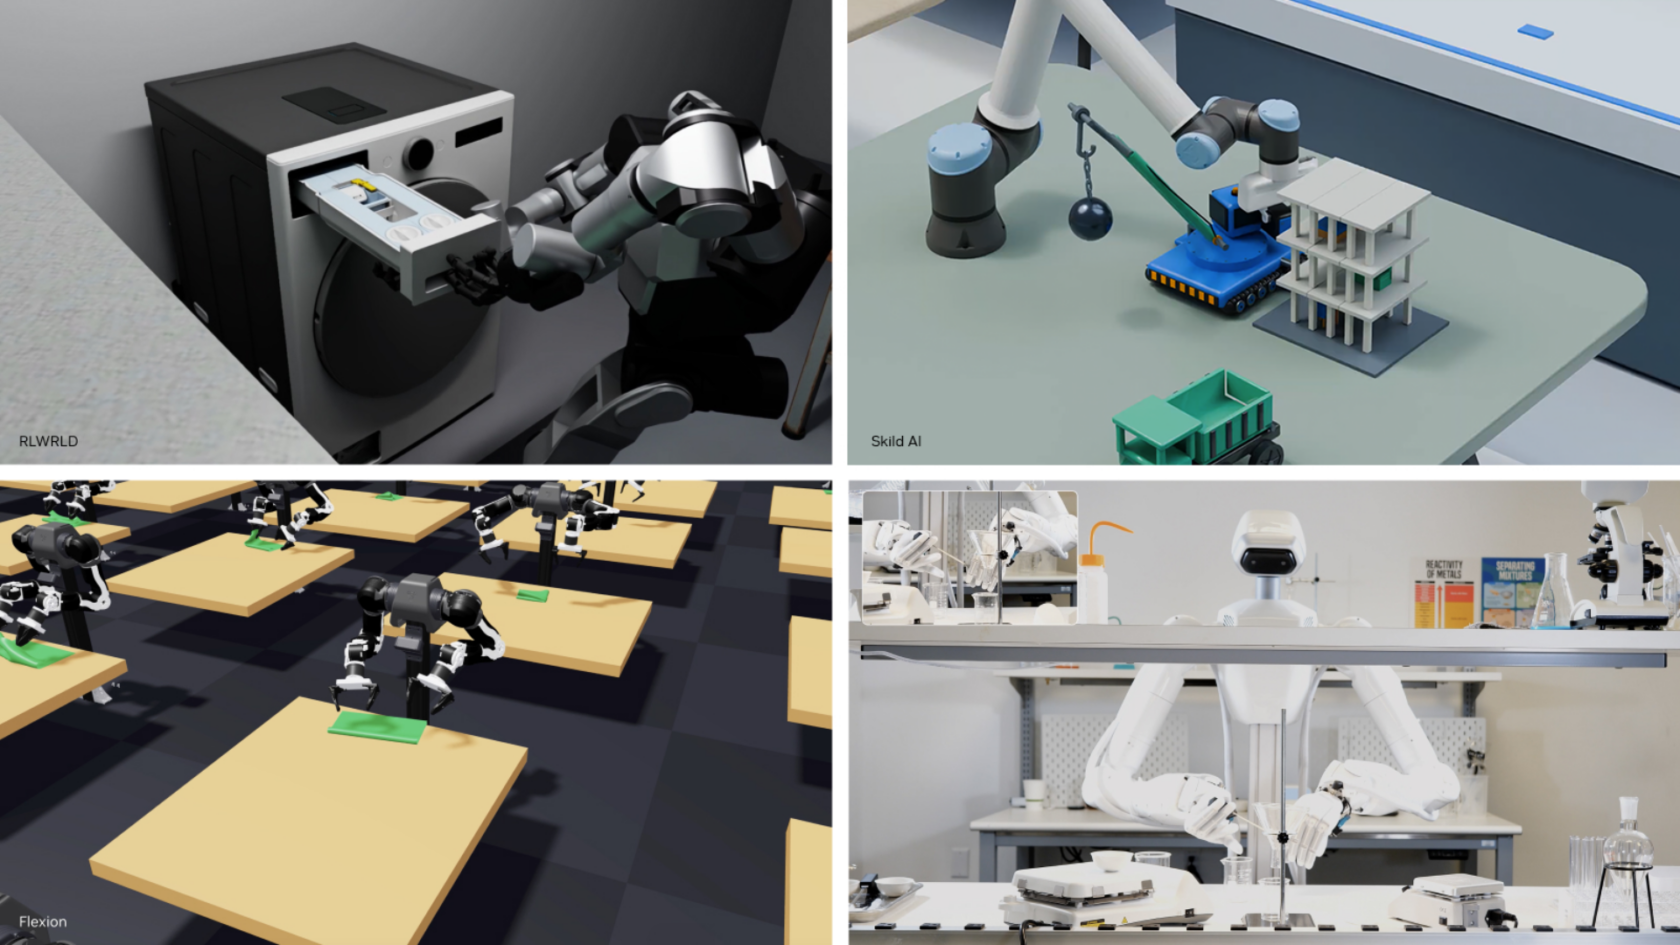
在CoRL大会上,NVIDIA发布GR00T 2世界动作模型、Isaac Lab 3.0仿真框架及新开放基准,推动机器人精细操作训练。GR00T 2支持跨机器人技能迁移,单次演示平均成功率达71%;Isaac Lab 3.0集成Newton物理引擎,支持柔性物体仿真,训练吞吐量提升至2.5倍。AlphaNIST以单一策略完成20项精密装配任务,成功率超98%。新基准DexBench和VABAR用于评估工业场景下的灵巧性与适应性。
澳鹏数据发布ExamOCRBench评测基准,基于2464套中国小学真实试卷(覆盖语文、数学、英语,含手写涂改、复杂布局),关联22636个小题、十类题型,派生24928个任务实例,核心指标要求整页全部判对。五个模型中GPT-6 Astra以58.18%领先,GPT-5.6 Sol为53.41%,Qwen3.8-Max、Claude Opus 5和Doubao-Seed-2.1-Pro分别为42.32%、36.75%和33.22%。
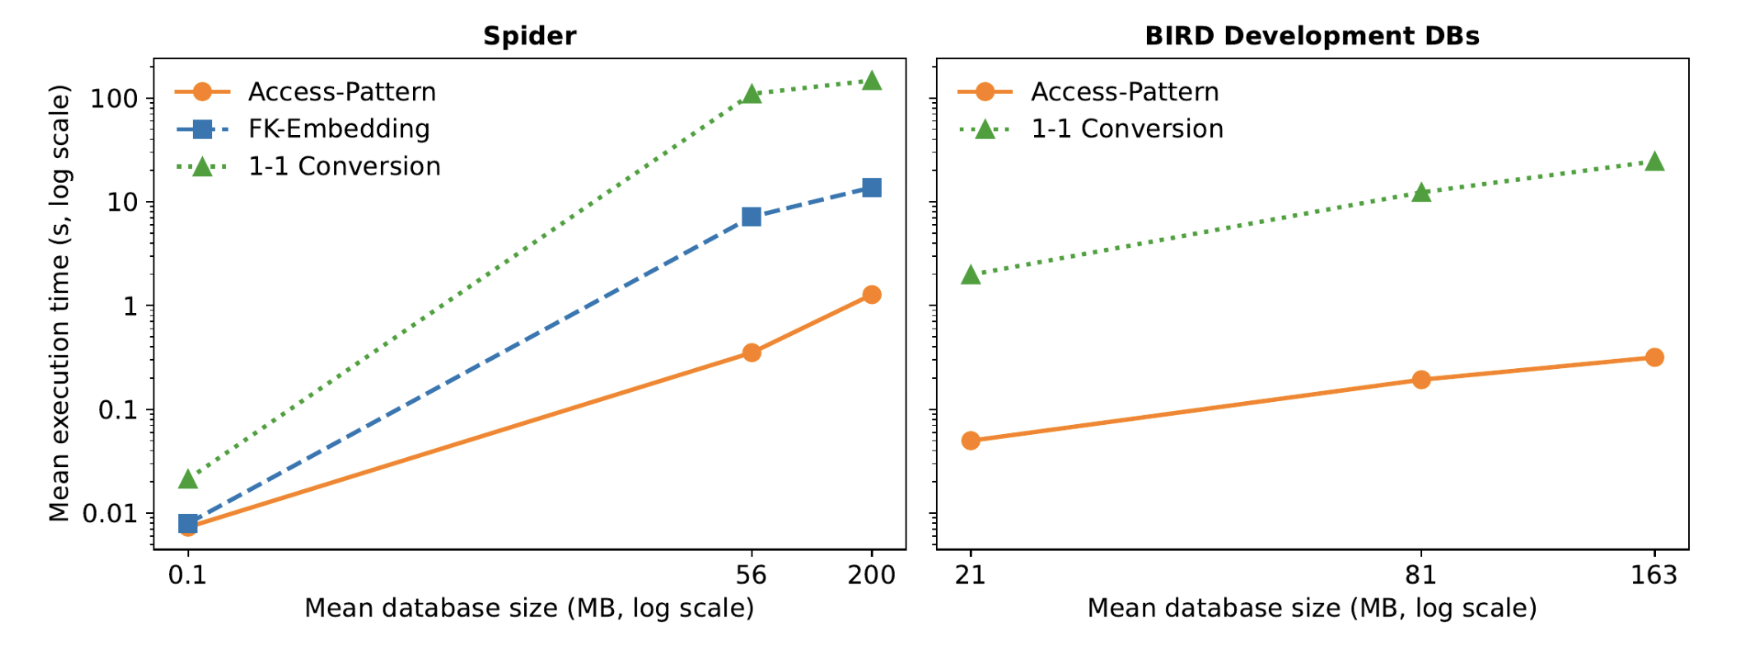
本文介绍AptMQL-Bench:将现有Text-to-SQL数据集转换为Text-to-MQL基准,包含21个MongoDB数据库和3186条自然语言请求。作者提出由编码智能体驱动、人工审核的三阶段转换流程:基于访问模式的模式设计、数据迁移与校验、SQL到MQL翻译及优化。相比机械转换,该方案实现无损迁移且查询速度显著更快。评测显示该基准对模型仍有挑战,最强模型Claude Opus 4.5仅达70.34% Soft-EX,并提出软执行准确率指标。
公开基准仅反映模型最优表现,无法保证生产环境中的稳定准确。Nebius的Wang建议结合内部基准与真实工作流评估开源模型,并关注整个推理栈,包括缓存命中率、吞吐与并发、P95/P99延迟和首字延迟。模型并非越大越好,应平衡精度与规模,必要时拆分任务或微调小模型。
优必选Thinker-WM在WorldOlympiad、EWMBench、WorldArena三大具身世界模型评测中均获第一。其核心是在表征层统一多模态,将RGB视频、深度与机器人动作编码至共享空间,由统一动态Transformer联合建模,支持六种能力模式。深度作为原生模态使操作成功率提升15个百分点。Motion Probe实验证明视觉表征已编码动作信息,标志具身世界模型从拼接式走向统一生成新范式。
作者重跑BadgerDB仓颉移植版基准,推翻原有三条结论:并发写实际比Go慢约2.6倍而非1.3倍,原因是两侧规模相差1300倍;FFI memcmp因约70纳秒调用开销,在随机key下反比逐字节比较慢18倍;io_uring在小文件场景慢2–6倍,但大写入高并发时可快1.1–1.6倍。错误源于规模未对齐、输入分布不匹配及结论超出证据边界。
音视频测试因依赖真机、时序敏感、指标连续而难以自动化。文章提出三层测试体系:单元测试覆盖时间戳映射、抖动缓冲等纯逻辑;性能基准量化编码延迟、帧率、内存等硬指标;设备兼容按高中低配真机矩阵跑CI回归,并对比基准阈值防退化。强调分层测试,避免单层解决所有问题。
GitHub联合微软推出开源基准ReviewBench,用219个公开PR评测AI代码审查工具。首期榜单中,GitHub Copilot以40.1%的F1得分居首,但测试由GitHub自行完成且各产品测试时间不一,结果存疑。Martian等竞品基准排名不同,凸显基准设计对结果影响很大。
AI正在改变开发者的工作方式,要求强化三项技能:指挥AI智能体、批判性审查其输出、在工作流中保持技术判断力。GitHub Copilot支持用自然语言描述界面,由智能体构建可实时使用和更新的画布,减少适应工具的时间;当聊天界面不适用时,画布是更具体的交互方式。
双 DGX Spark 实测显示:合成基准表现亮眼,但真实智能体负载下出现卡顿。两机直连带宽约 200Gb/s,内存带宽仅 273GB/s 成为瓶颈。短提示下六并发达 172.7 tok/s,但五个子智能体扫描代码库时单流降至 15–25 tok/s,六分钟无结果。该设备仅适合单用户逐轮编程,不适合并发多智能体或长上下文任务。
Wild 作者对比 Wild 与 Mold 链接器基准,发现配置差异(输出删除、文件系统、fork)导致结果不同,复现后差距缩小至约 1.0–1.3×。iceoryx2 0.10 发布,新增无界零拷贝 payload 与 FlatBuffers 集成。pg_raw_parse 直接映射 Postgres 解析器,解析速度提升约 20–60×。另有文章可视化 ABA 问题并介绍 crossbeam-epoch 的动机。
计算机科学家Talia Ringer回顾2021年接触Codex时的“AI悲伤周期”,担忧AI生成程序带来漏洞、研究领域被吞没、AI文化侵蚀开放协作传统。她主张主动向AI界和公众说明研究实质,推动编程语言领域与AI互补共存。她认为数学界面临更大关注与敌意,需长期开展公关,向公众解释数学过程而非基准,并考虑工会化、与小公司及学者合作。
国产AI Coding平台没有普适最优解。Gitee定位为AI+DevOps智能研发平台,优势在于国内代码托管、开源生态、信创合规和MCP式AI接入,注册开发者超1400万,但项目管理深度不及Asana等,需单独验证。选型建议按合规网络、仓库、DevOps、AI接入、计费模型五步比较,落地前应通过官方文档、试点和SLA复核。
Sierra开源了Hyper-τ-bench基准,用于测试AI代理能否自主构建另一个代理。结果显示,最佳模型组合得分仅23.9%,远低于人类辅助的82.2%。代理常过早停止研究、提问不足、缺乏实验,尤其在银行业务上表现差。这表明自主开发代理在信息收集和设计判断上仍有明显局限。
英伟达发布AVO智能体系统,将Claude Opus 5在ARC-AGI-3基准上的得分从30.2%提升至100%。该系统通过持久记忆和程序化监督,支持长时间自主操作,并成功从GPU优化迁移至推理任务,证明系统设计而非仅模型能力可解锁前沿性能。
Harvey LAB是法律AI公司Harvey开源的基准,含1660个任务和约10.1万条评分判据,覆盖24个执业领域。任务在沙箱中执行,采用文件系统优先设计,通过LLM评审逐条裁决,使用all-pass评分(差一条判据整题零分)。该基准模拟真实律师工作,但存在评审模型亲缘偏差、判据质量依赖作者功力等局限。
卡帕西用《指环王》开头测试大模型,让Opus 5通过Three.js生成3D中土世界,耗时2小时、百万token。此举取代“鹈鹕骑自行车”SVG测试,成为新基准,考验模型空间理解与复杂项目能力。网友创作多样,但模型仍难真正理解视频或游戏,引发关于空间推理本质的讨论。
香港中文大学与阿里巴巴联合提出PAST-Bench,首个系统评估个人AI智能体递归自我改进能力的基准。通过控制组设计隔离经验保留效应,在26个任务族上测试7个模型和4种框架,定义记忆、程序、主动信息收集和更新四维度。发现跨会话改进不均衡,并提出Hermes+框架增强机制,但效果依赖模型,通用性待验证。
Databricks发布OfficeQA Pro V2基准,用于测试AI代理在企业级文档上的泛化推理能力。该基准基于美国财政部1793至2024年约12万页账目数据,含90个问题。前沿模型平均准确率仅37.5%,专用代理达41.1%,而Databricks Genie系统提升至60%。基准强调跨文档检索、解析和推理,仍具挑战性,旨在推动企业AI代理发展。
华为云OfficeAce首批通过中国信通院《云上Agent基准度量模型》重要级评估,该标准从功能性、安全性、可靠性、用户体验、性能效率、成本效益六维度量化评测Agent。OfficeAce凭借全栈技术优势,在各项指标表现优异,获行业权威认证,助力企业Agent可信选型与规模化落地。
完成下面两步后,将自动完成登录并继续当前操作。