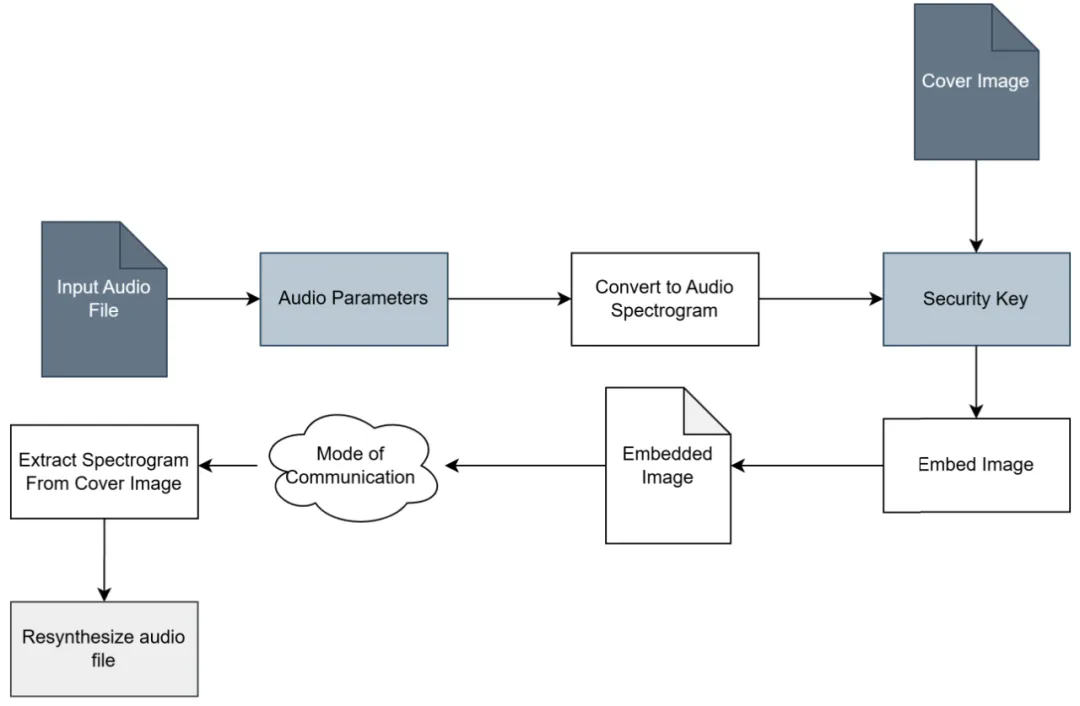


隐写术是一种将秘密信息隐藏于非机密载体的技术。印度研究团队提出了一种新型音频隐写技术ASA,结合声谱图与图像嵌入,能够高效、安全地隐藏音频。该方法不依赖深度学习,具有高存储效率和良好音质,但在高频细节重建和兼容性方面存在不足。
AI通过声波生成声谱图,利用深度神经网络进行声学建模,并结合语言模型和置信度评分,识别“eight”和“ate”的区别。
本文介绍如何使用Web Audio API和HTML5画布在浏览器中实时生成声谱图。通过请求麦克风、连接分析节点和设置画布等步骤,可以创建一个无需外部库的音频可视化工具,适用于音频工具、教育和音乐可视化,具有低延迟和易嵌入的优点。
本研究提出了一种新方法,通过卷积神经网络和图像处理技术,从声谱图图像中直接估计音高。该方法在不同信噪比条件下的检测准确率高达92%,比其他先进方法提高约5%。
本文研究了使用声谱图评估音频信号的可行性,发现该方法鼓励挖掘听觉和视觉通路的相似之处,并定制度量以解决音频信号的特殊性。使用音乐数据集对定制度量和基线度量进行评估,与人类评价者对音频质量的感知相关。
完成下面两步后,将自动完成登录并继续当前操作。