主动降噪耳机通过麦克风采集环境噪声,由数字控制器实时生成相位相反、振幅匹配的反噪声,与原始声波相消干涉,在耳道附近形成局部安静区。系统分为前馈、反馈和混合三种架构,依赖低延迟处理和FxLMS等自适应算法。降噪对低频稳定声更有效,高频突发声仍需物理隔音配合。ANC无法消除所有声音,但能降低背景噪声,帮助用户以更低音量听音乐。
本文介绍如何让Mac同时向多个耳机或音箱输出音频,以便与朋友共享影音。方法是使用macOS自带的“音频MIDI设置”创建聚集设备,并参考苹果官网教程;使用AirPods时建议关闭入耳检测功能。
微软在Windows 11测试版中为安卓设备新增快速设置入口,配对后可通过Win+A面板切换勿扰模式、调节手机音量,并让手机播放声音以便寻找。该功能将Phone Link部分能力前置到系统级入口,目前仍在测试,部分功能仅支持特定安卓设备。
作者用Rust编写了一个agent框架,并添加voice扩展,用于国庆助兴,同时分享了GitHub项目pi-rust,欢迎大家star。
VoxCPM2是首个完全放弃离散token的开源TTS方案,直接在连续潜空间用扩散自回归建模,避免离散化导致的情感与韵律细节损失。它支持通过自然语言描述生成音色、克隆音色并独立控制风格,覆盖30种语言及9种中文方言,输出48kHz音频,采用Apache-2.0许可可商用,支持LoRA微调,单张RTX 4090即可完成。
字节的 Seed-Audio 音频生成模型能力强、可控性高,但官方资料少且冷门。作者为此开发开源 Skill,采用 7 步工作流,将故事目标分解并生成多段音频,面向短剧、漫剧等故事性创作。使用需配置 SEED_AUDIO_API_KEY 并安装 ffmpeg。核心难点是构造统一的复合音频 prompt,作者还从豆包官方 Skill 中提取提示词技巧并整理成文档。
GPT-6 Astra虽不支持音频输入,却能通过梅尔频谱图图片零样本识别声音,如狗叫和光剑音效。这显示视觉模型能跨感官解读声学模式,突破官方能力边界,引发对AI感官界限和潜在能力的思考。
网易有道发布全球首款专为iPhone设计的AI耳机OpenPods,基于苹果MFi认证与AI Agent能力,整合录音、转写、翻译、总结等功能,覆盖会议、跨语言沟通等场景。耳机支持20余种语言,可生成纪要和知识库,单耳仅7克,续航32小时,8月27日预售,9月10日发售。
谷歌Gemini Live推出重大升级,整合Spark功能,支持语音设置多步骤自主任务,如整理想法成文档、规划每周菜单。新增每日简报和免提邮件管理,可语音查询日程、搜索和归档邮件。借助个人智能,能记住过往对话,跨应用提供个性化回答,简化日常操作。
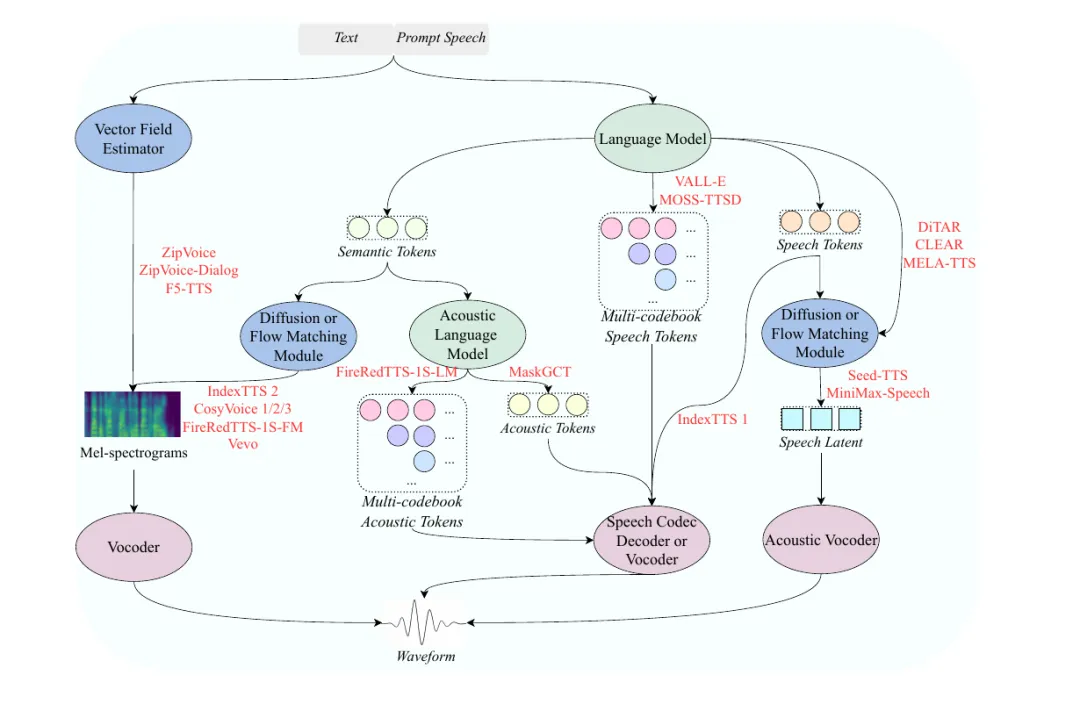
B站发布IndexTTS 2.5语音合成模型,支持中英日西阿五语种零样本配音,推理速度提升2.28倍,并增强跨语言情绪还原与语速控制。团队通过降低语义帧率、换用Zipformer架构及GRPO强化学习优化性能,在情感迁移和说话人相似度上表现优异,旨在让创作者用任意声音、语言和情绪进行配音。
作者在北京整租后,将电脑桌设在客厅,打造极简复古风格的个人角落。选用原木桌、飞利浦显示器、Mackie MR524音箱等设备,通过USB-C一线通简化线缆,享受独处时光。文章强调极简不是空无,而是保留常用之物,按自己节奏生活,让角落成为心灵栖息地。
Game Freak新作《Beast of Reincarnation》战斗流畅但缺乏新意。游戏设定在末日日本,主角艾玛可吸收怪物能力,但故事晦涩、谜团解答平淡,玩法简单,关卡设计直白。大量借鉴《尼尔》《怪物猎人》等作品,虽有忧郁氛围,但未能突破,令人失望。
大脑切换听觉注意力时,先快速抓取新声音,再缓慢放开旧声音,形成短暂的双重处理窗口。研究通过脑电图发现,大脑采用“先开后关”策略,并重置语义上下文,而非延续旧信息。这一发现颠覆传统认知,为助听器和脑机接口设计提供新思路,也揭示大脑与AI语言模型处理方式的差异。
本文提出了一种基于ZEGO的手动混流方案,适用于大班和小班课,强调声音主权和焦点切换的管理。方案包括课堂混流管理、学生静音策略及录制回放等细节,旨在提升在线教学体验。
本文讨论了直播中主播声音干扰的问题,提出使用ZEGO的自动混流方案来解决。该方案通过标记主播流为焦点,自动管理音频流,确保主播声音突出,降低维护成本。文章还介绍了自动混流的实现步骤和适用场景,强调了其在直播中的优势。
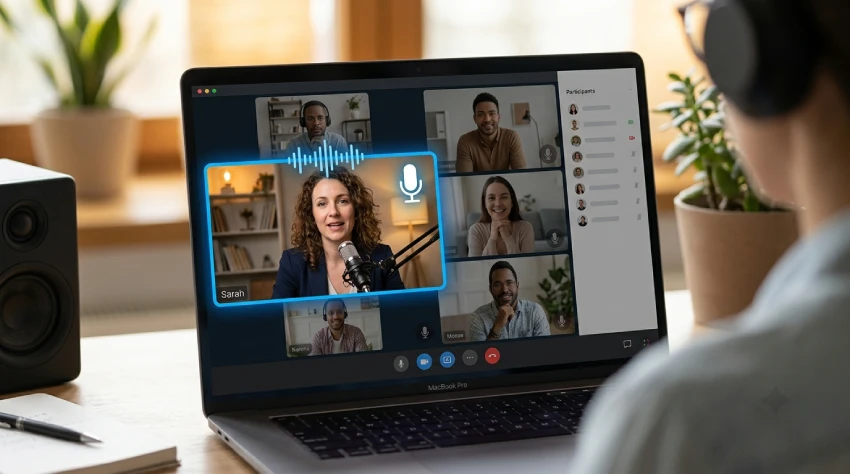
本文介绍了ZEGO实时音视频SDK的混流焦点语音方案,旨在解决多人会议中重要发言人声音被淹没的问题。通过服务端混流,突出特定发言人的声音,适用于视频会议和在线课堂等场景。方案包括核心原理、关键API参数及实现步骤,强调统一控制和动态切换焦点的优势。
文章探讨了“角落”的意义,作者在东莞的宿舍中寻找创作空间,重新定义理想的角落。通过简单的桌面和耳机,营造适合思考的环境。同时,作者在城市中探索咖啡馆和电影院,发现声音与空间的关系,强调角落不仅是物理空间,更是心灵的栖息地。
该研究聚焦于文本到声音视频生成(T2SV),旨在从文本生成同步音频的视频。为解决文本条件瓶颈和跨模态特征交互机制不明确的问题,提出了交叉参考重写器(CRR)框架,通过提取语义锚点和生成解耦的字幕对,消除模态干扰,缩小训练与推理之间的差距。
新西兰推出了一种新的Google Maps语音,能够正确发音毛利语地名,如“Taranaki”和“Whangārei”。此举旨在尊重毛利文化,提升对毛利语的认知。与毛利语言委员会合作,确保发音准确,并计划建立数据守护小组,支持毛利学者和社区。新语音已在Android和iOS平台上线。
Netflix将于9月23日首播以《威利·旺卡》为主题的真人秀《金票》,节目将使用AI生成的基因·怀尔德声音,并获得其家族同意。12名获胜者及其搭档将参与竞争,最终于9月30日决出冠军。
完成下面两步后,将自动完成登录并继续当前操作。