MiniMax M3.1 Flash 已在 AI Gateway 免费开放至10月20日。该开源多模态模型面向编程与智能体任务,支持100万 token 上下文,在复杂智能体、编程和网络安全方面较前代有所提升。免费仅限由 MiniMax 处理请求,需在网关设置中排序供应商;优惠结束后按标准价计费。可通过 AI SDK 及各 API 或编程智能体调用,模型名为 minimax/minimax-m3.1-flash。
iRTE2026实时智能大会将于10月23日至24日在北京悠唐皇冠假日酒店举行,全议程已公布,限免报名中。大会汇聚多模态模型、Voice Agent、实时音视频、AI Infra、AI硬件及应用场景一线从业者,探讨实时智能在模型、工程技术、基础设施与商业落地方面的关键变化。
何恺明团队提出视觉原生框架VISTA,使多模态模型能直接保存原始画面,并在推理时随时回看、放大和检查细节,无需重新训练。在该框架下,Claude Opus 5.0通关ARC-AGI-3全部25个公开游戏,动作效率得分满分100,动作数比人类基线少57.4%;GPT-5.6 Sol同样全部通关,得分99。团队还在浏览器游戏、迷宫和连线题中验证了该方法,并将具身任务列为后续方向。
文章介绍在Java中调用多模态模型抽取票据金额前进行本地校验:检查文件类型仅限JPG/PNG、大小不超过5MB,并用BigDecimal比对申报金额与识别金额,容差0.01元。示例基于JDK17+的HttpClient构造REST请求,显式处理密钥、超时和状态码,强调模型输出不可直接作为付款指令,需JSON解析与人工复核。
Cloudflare发布多模态决策模型Clef-omni,基于Qwen3-Omni架构,支持文本、图像、音频和视频输入,单次API调用即可完成跨模态判断。Clef-flash降价至每百万输入token 0.038美元,低于Jev,但上下文窗口缩至24k。Clef经SGLang优化后速度提升约1.7至2倍。
Mistral Large 4已上线AI Gateway。该开放权重、原生多模态模型融合推理与图文理解,适用于网络防御、制造和金融。用户可用单一API密钥访问,无需单独注册Mistral账户,支持AI SDK、OpenAI兼容接口及Claude Code等编码代理。
Nova Act 合成监控使用多模态模型按真实用户路径完成任务,替代易误报的选择器脚本。需分离动作与结果断言,连续两次失败才告警,并使用新会话、最小权限和脱敏证据。它适合视觉频繁变动且结果可断言的流程,是继指标、日志、追踪后的第四层证据,但不替代传统脚本。
vLLM 是加速大语言模型推理的框架,通过近乎零浪费的 KV 缓存解决内存管理瓶颈。本文提供离线推理教程,演示 Florence-2、Mllama、Whisper 三个多模态模型的隐式与显式提示用法,包含完整代码示例,并统计生成耗时与 RPS。
商汤科技发布SenseNova-U1.5-8B-MoT统一多模态模型,支持图像生成、编辑与理解,提升4K画质和文字渲染。HyperAI官网更新数据集、教程及百科词条,涵盖语音、地震数据及多模态模型部署,并预告9月截稿顶会。
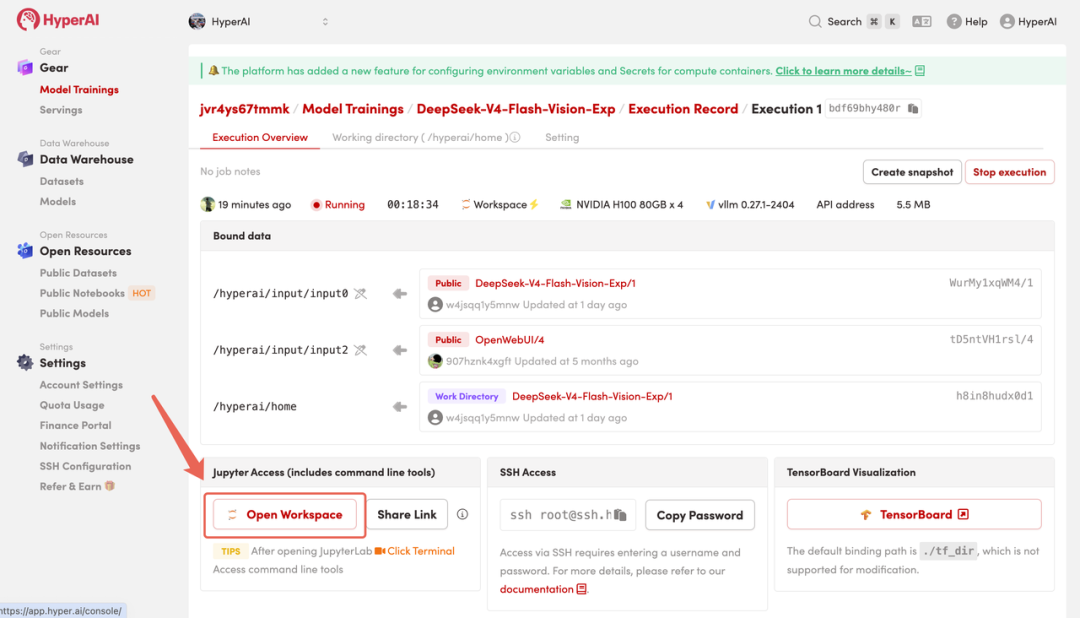
DeepSeek发布首个多模态实验模型V4-Flash-Vision-Exp,新增视觉理解能力,可处理图像图表等复杂任务,性能提升至36.5,多模态评测表现优异。HyperAI已上线部署教程,支持一键运行。
智谱发布并开源GLM-5.3-Flash多模态模型,性能超GLM-5.2,与Claude Opus 4.8持平。商汤大装置提供国产算力支持,通过异构混推技术提升服务性能3倍,成本与英伟达GPU相当,推动国产算力规模化商用,日均Token服务量达2.42万亿。
智谱发布开源原生多模态模型GLM-5.3-Flash,采用MoE架构,支持文本图像输入及百万Token上下文,性能与Claude Opus 4.8持平,API定价大幅降低。同时,Perplexity推出端侧AI智能体,明基发布专业显示器,Google推出语音转文本模型及视频生成模型,英伟达发布定制高带宽内存,微软Xbox推出光盘数字化功能。
DeepSeek推出多模态模型DeepSeek-V4-Flash-Vision-Exp,图片最多占384个Token,通过三级压缩技术大幅降低成本。模型侧重OCR和图像描述,非人脸识别,故认错人属设计初衷问题。API成本可预测,推理快,多模态能力接近Opus-4.8,体现低价高效理念。
2026年8月21日,DeepSeek下架免费模型并上线视觉模型API,同日OpenRouter出现匿名模型Ox Alpha,免费且支持多模态。网友测试发现其Tokenizer与智谱GLM完全一致,推测为智谱未发布的多模态模型,但小米因历史匿名测试套路也被怀疑。Ox Alpha免费一周疑为压力测试,身份成谜。
DeepSeek发布V4-Flash-Vision-Exp多模态模型,视觉能力免费,定价与纯文本版一致,单图最高384 token,价格远低于GPT-4o。性能接近Opus-4.8,但细节识别有限,支持600张图批量处理,受分辨率限制。模型为实验性质,不建议生产使用,旨在收集真实数据优化。
DeepSeek推出多模态模型deepseek-v4-flash-vision-exp,新增视觉理解能力,支持图片输入,提升多模态Agent任务表现。模型延续V4-Flash文本能力,定价按token计费,图片最高换算384 tokens。同步推出Files API,支持文件复用,降低开发者调用门槛,推动Agent从文本处理走向复杂任务执行。
Mux 团队分享了 stream.new 应用内容审核系统的三次迭代历程。从 2021 年使用 Google 和 Hive 视觉 API 检测帧,到 2025 年采用 @mux/ai 工具包,利用多模态模型通过自然语言问题识别盗版等内容,再到 2026 年迁移至 Mux Robots 原生服务,简化了代码并提升了审核能力。每次升级都减少了定制代码,使审核更高效、准确。
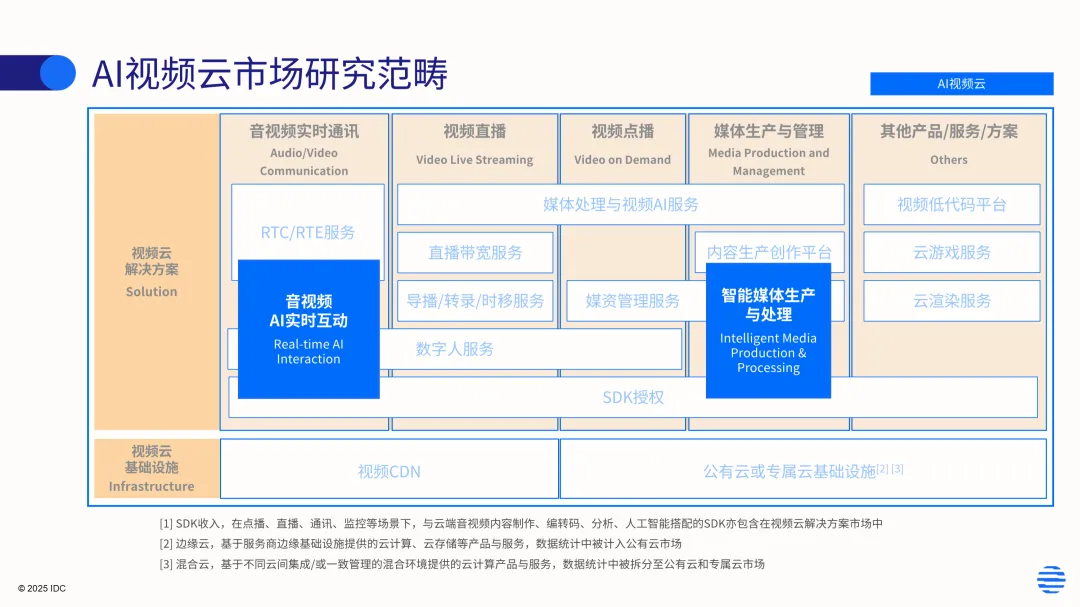
IDC报告显示,2025年中国AI视频云市场近10亿元,智能媒体生产与处理赛道增速达427%,音视频AI实时互动增长223%。AI正重构内容供给体系,多模态模型成核心引擎,竞争转向工业化能力比拼,未来将进入Agent-Native时代。
本文解析多模态模型核心技术:CLIP对比学习依赖大batch与温度参数;视觉接入语言模型有projector、cross-attention、指令微调三种方式,各有分辨率瓶颈、压缩损失和幻觉问题;SAM专注像素级分割,与聊天VLM是不同产品线;融合时机决定部署成本,统一token接口仍存争议。
阿里巴巴发布Qwen3.8-Max,2.4万亿参数多模态模型,支持百万token上下文,采用稀疏专家和混合注意力架构,并承诺下周开源权重。专家质疑其自评基准可信度,强调需外部验证和稳健测试框架。模型在自主编码和长任务执行上表现突出,但成本、安全及实际采用率仍是关键考量。
完成下面两步后,将自动完成登录并继续当前操作。