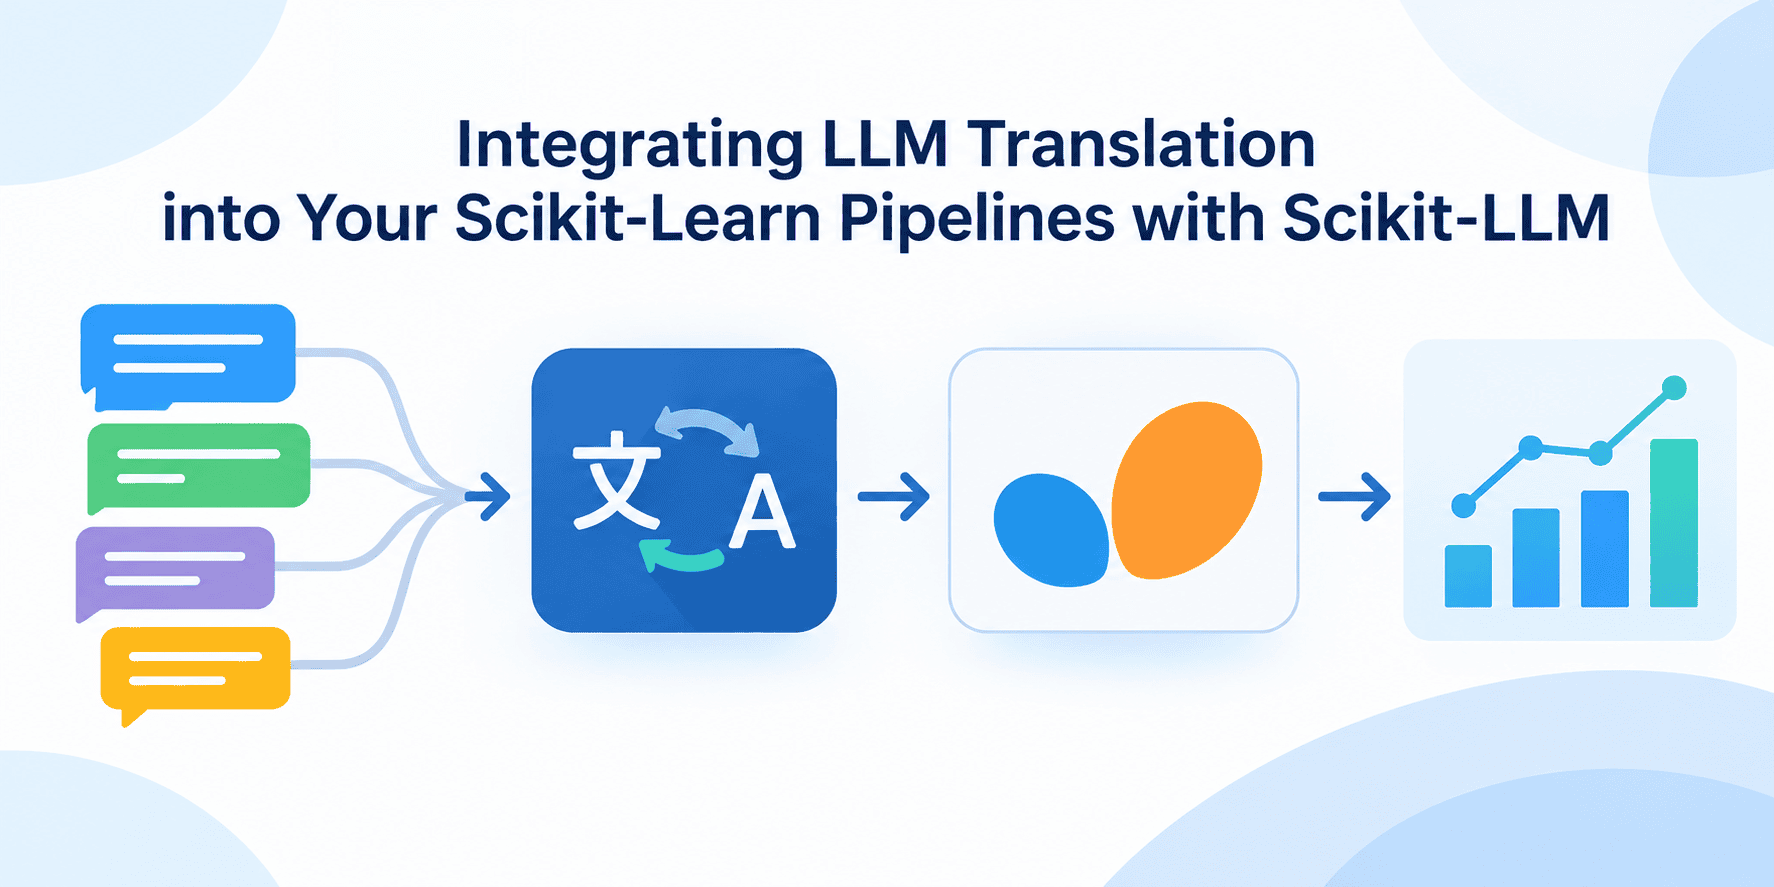
文章介绍用Scikit-LLM构建两阶段scikit-learn流水线实现多语言文本分类:先用GPTTranslator将法语、德语、西班牙语等原文统一翻译为英语,再用ZeroShotGPTClassifier进行零样本分类,无需大量训练数据,只需类别标签和少量占位样本。示例通过Groq免费API调用模型,对意大利语、葡萄牙语新文本先翻译后分类,结果准确。该方法以语义推理替代关键词匹配,解决冷启动问题,免费高效。
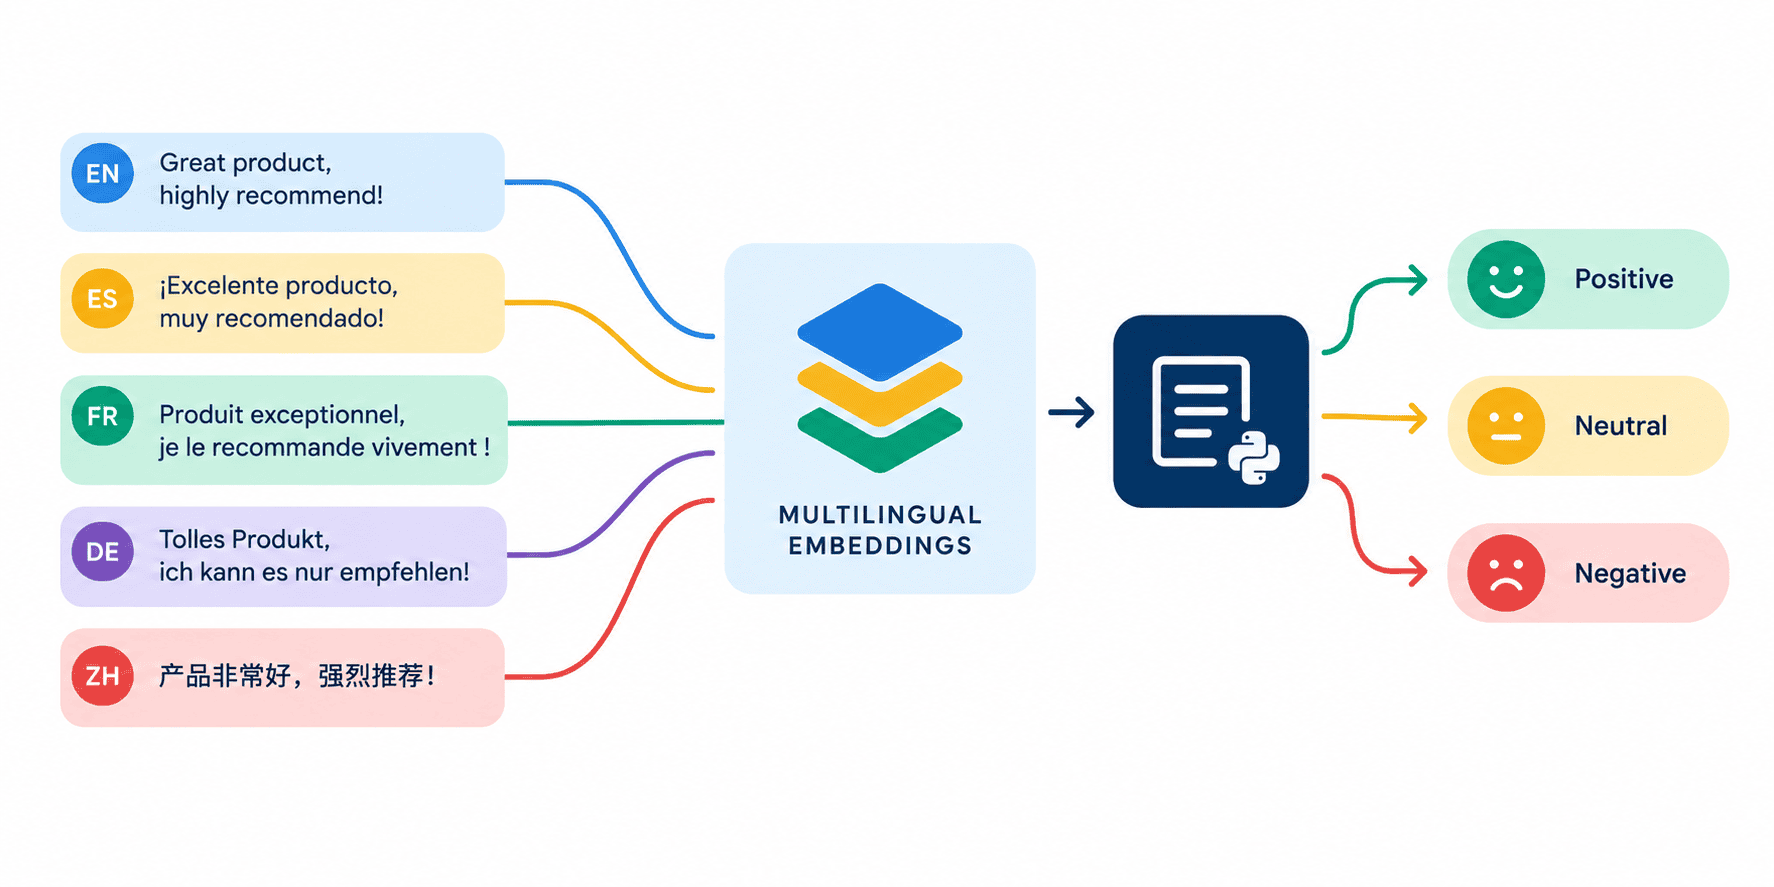
本文介绍使用Scikit-LLM与多语言嵌入构建多语言文本分类流程:通过Ollama本地运行BGE-M3模型,将英西双语评论映射到统一向量空间,再训练逻辑回归分类器,无需为每种语言单独建模。在2000条亚马逊评论上准确率约57%,极端评分预测较好,中等评分较难区分。
本文探讨了机器翻译在多语言文本分类和自然语言理解中的应用。研究表明,结合神经机器翻译与高资源语言的分类器能显著提升分类效果。通过迁移学习和多任务学习,利用源语言资源解决模型质量问题,增强了多语言对话评估的鲁棒性。使用机器翻译数据有效提升自然语言理解系统的性能。
本文探讨了跨语言学习和转移学习在多语言文本分类中的应用,提出了多种方法以提高低资源语言的性能,包括使用多语言BERT、神经网络和Transformer模型。研究表明,结合语言特征和数据集扩充能显著提升模型效果。
本研究比较了适配器和低秩适应技术在多语言文本分类任务中的应用与全面微调相比的影响,分析了不同训练场景和语言,为参数节约微调技术的适用性提供了有价值的见解。
本研究比较了适配器和低秩适应技术与全面微调在多语言文本分类任务中的影响,分析了不同训练场景和语言的适用性。
本研究比较了适配器和低秩适应技术在多语言文本分类任务中的应用与全面微调相比的影响,分析了不同训练场景和语言的适用性,为参数节约微调技术提供了有价值的见解。
研究人员通过基于语言模型的学习方法提出了几种数据蒸馏技术,以增强文本数据蒸馏的跨体系结构泛化能力。他们在多语言文本分类数据集上进行了实验,并分析了这些技术在分类强度和跨体系结构泛化方面的性能。此外,他们还研究了这些方法生成的数据摘要的语言特定公平性。
完成下面两步后,将自动完成登录并继续当前操作。