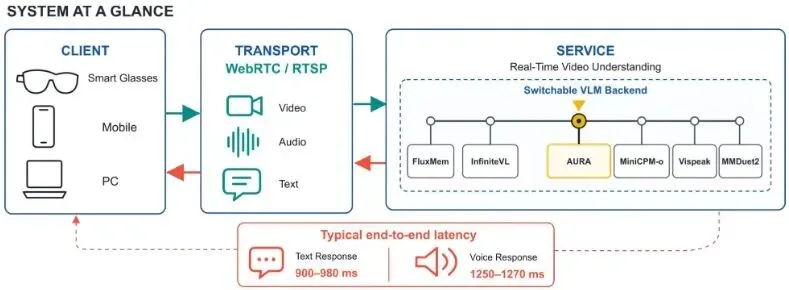
本文提出一套低延迟边云系统,集成六种流式视频VLM后端,共享ASR/TTS与统一编排,支持实时语音交互。实验显示,在合适后端与WebRTC传输下,首句VLM文本延迟约0.9–1.0秒,首段TTS音频约1.3–1.5秒。研究表明实时视频理解是分层系统问题,VLM到TTS交接尤为关键,低首token延迟并不保证快速语音响应。
谷歌Gemini 3.8 Live与Extended Thinking已上线AI Gateway。Live支持实时音频、视觉定位、97种语言自动切换及后台工具调用;Extended Thinking增加与语音并行的多步推理,可边回应边播报进度。两者均可通过AI SDK实时API接入,需安装Gateway提供商和WebSocket客户端,获取短期令牌后连接使用。
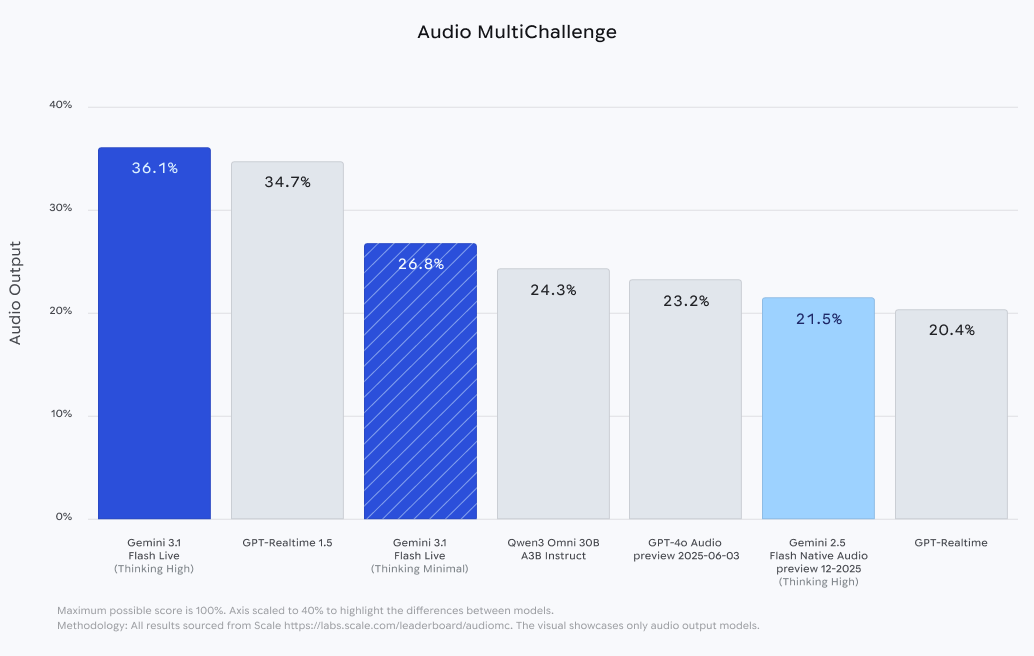
谷歌发布了Gemini 3.1 Flash Live预览版,旨在实现低延迟的实时语音交互。该模型通过原生音频处理提升了嘈杂环境中的语音识别准确性,并支持双向流式传输,允许用户中断对话。同时,开发者可调整推理深度,以优化速度与准确性。
happy 是一款多平台 AI 编码助手,支持实时语音交互和端到端加密,便于远程控制。Antigravity-Manager 管理多账号,支持 OAuth 2.0 授权。cc-switch 集成多种 AI 编程接口,优化用户体验,支持多语言界面。
完成下面两步后,将自动完成登录并继续当前操作。