Kimi K3.1 Pro 发布后,作者更关注接入现有开发流程的工程成本,而非跑分。建议用带重试逻辑的真实小任务试用,记录改动与人工审查时间;长上下文需保留输入清单、脱敏日志并单独核查迁移风险;Highspeed 更快但更贵,应按最终通过审查的任务算账,并保留切回原模型的开关。起步应放入隔离环境、仅改工作副本、经合并请求人工审核,部署凭据留在现有流程,先备好回滚。
Claude Code团队博客分享AI时代代码审查经验:代码审查仍必不可少,但改为先由AI审查验证、再由人确认,以减轻人工负担。审核路径按风险分级,低风险改动自动合并,高风险需人工批准。提交者须对自己的改动负责,不能推责给AI。开发者可借助AI阅读完整源码、理解项目全貌,从而维持对项目的理解。
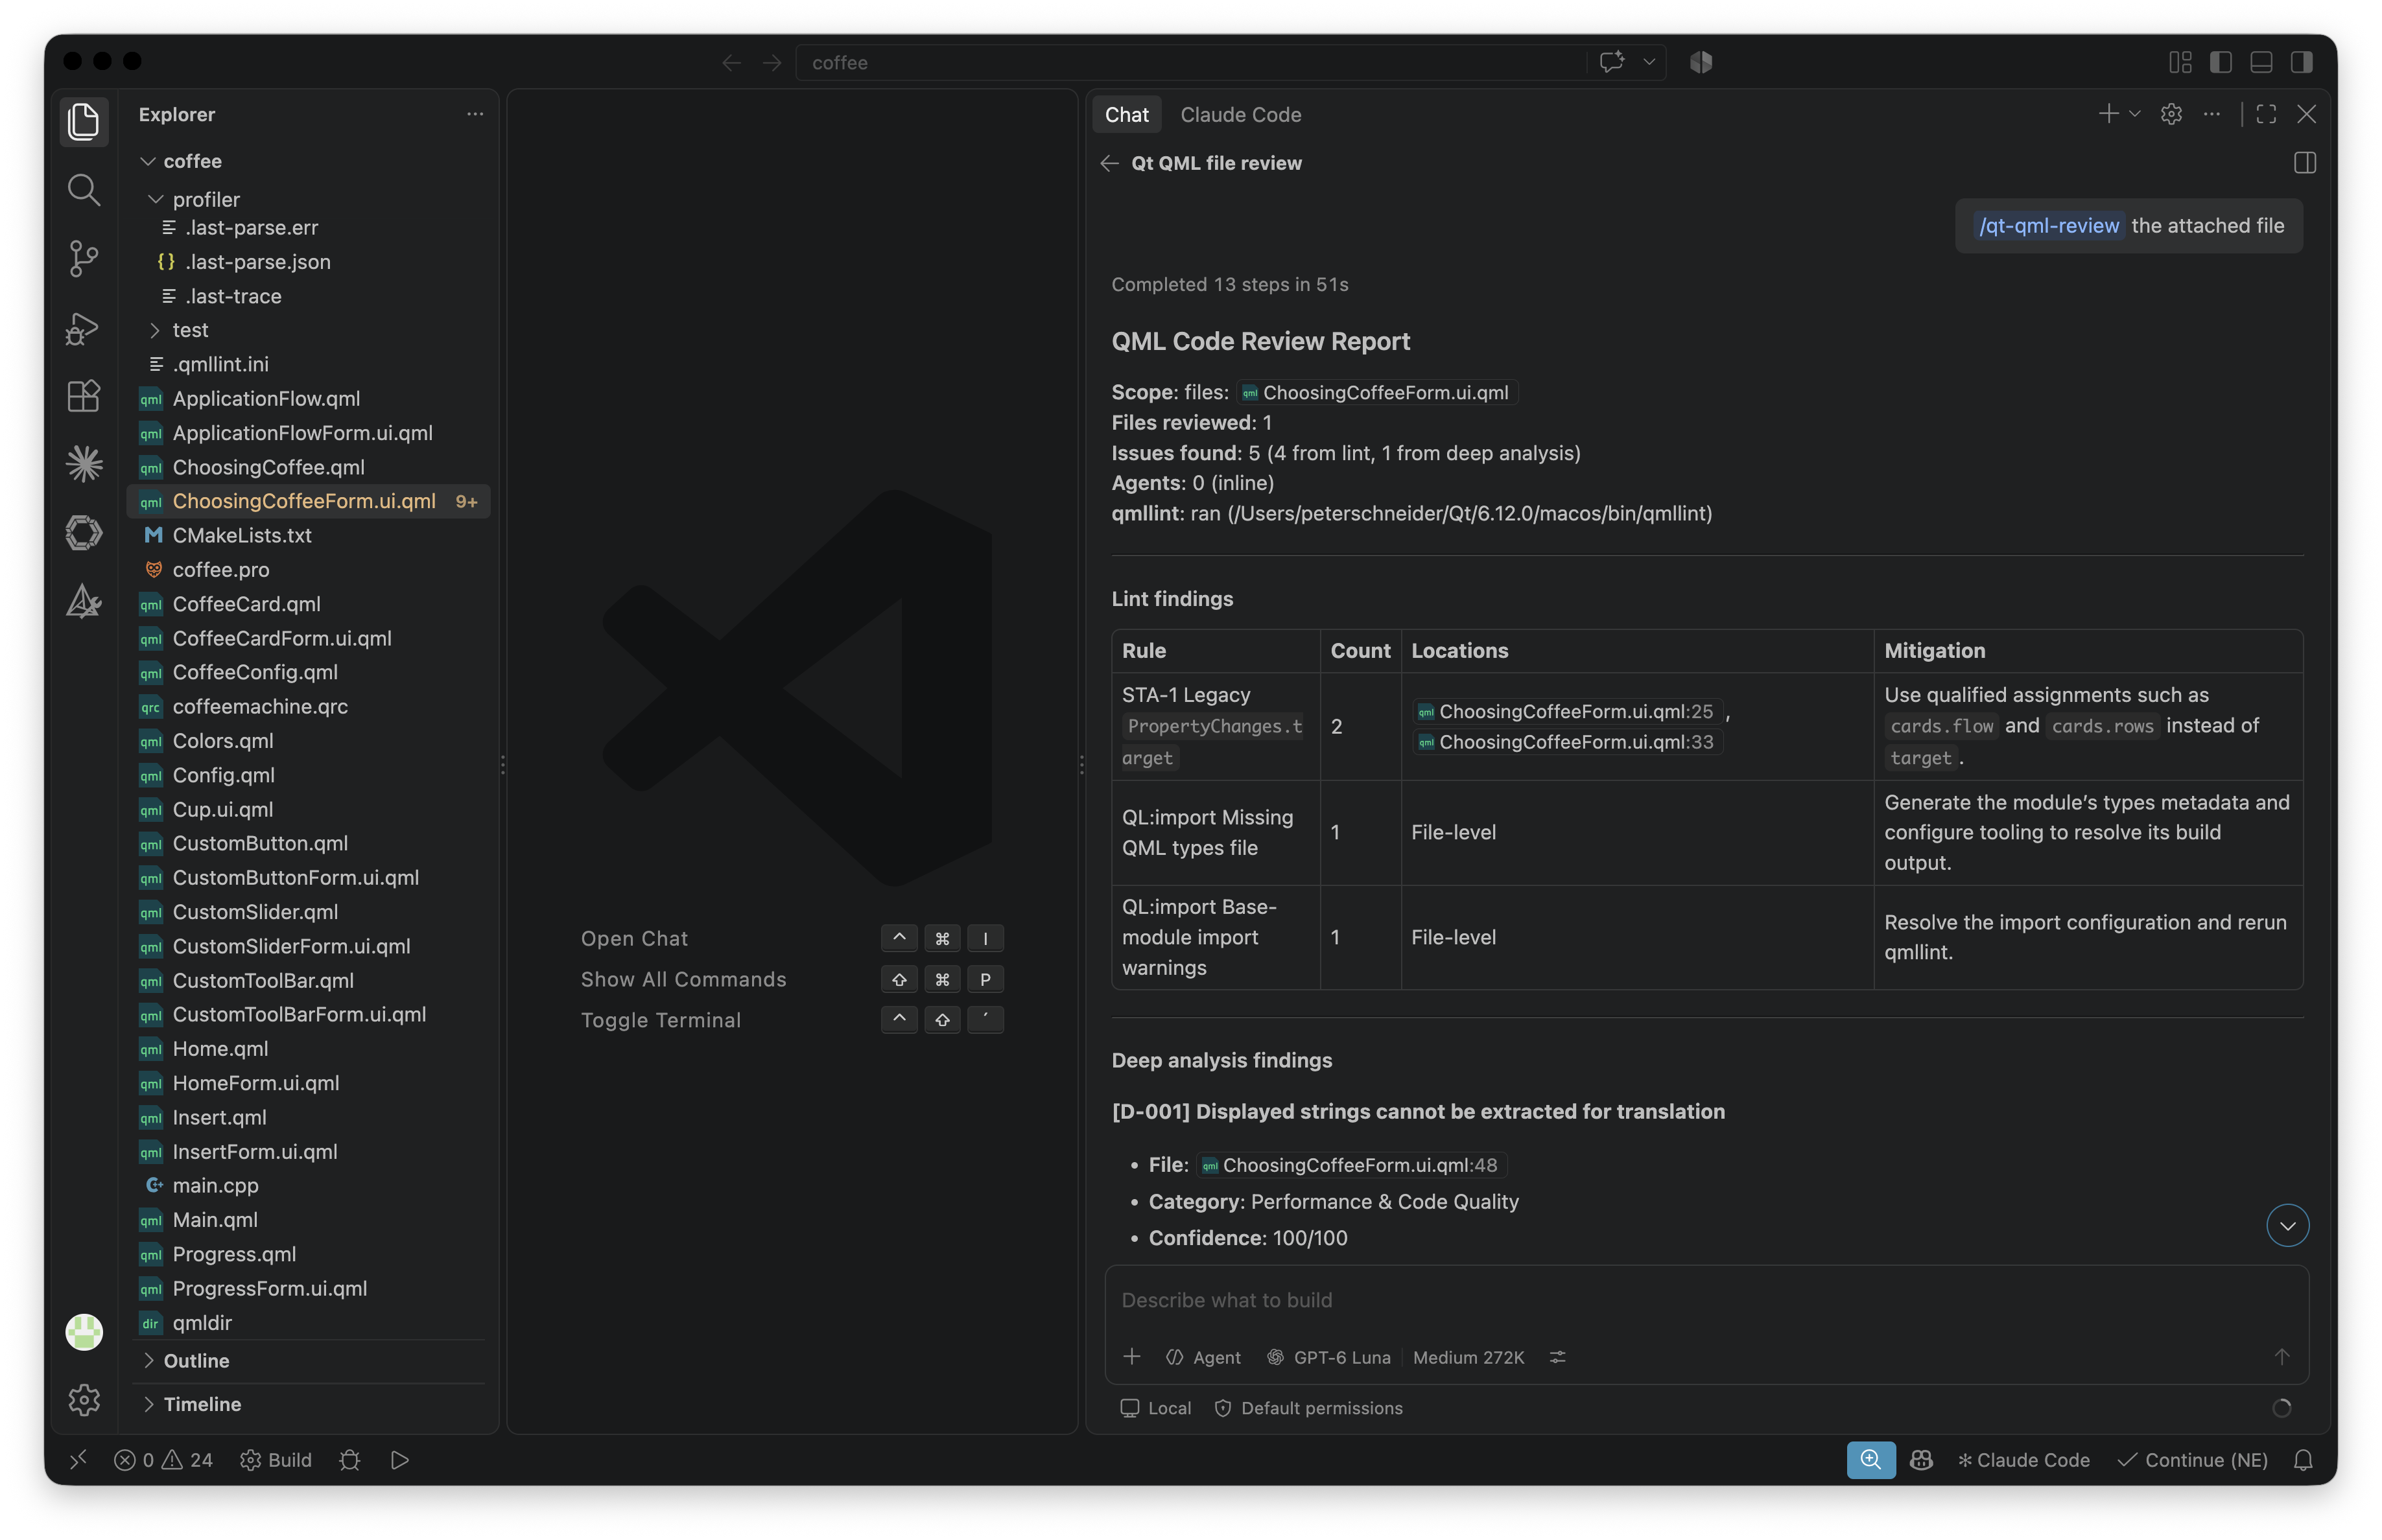
Qt 重构了 QML 与 Qt C++ 代码审查技能以降低 token 消耗:将深度分析由 6 个子代理改为单代理,2500 行以下代码按规则直接分析,并仅审查会话中修改的代码。测试显示审查准确率未下降,小项目平均成本从 1.25 美元降至 0.31 美元。更新已发布在 GitHub 仓库及 Anthropic qt-development 插件中。
Anthropic的Claude Code团队超90%代码由AI生成,逐行人工审查成为瓶颈,遂转向人机协同分级审查:提交前由Claude自测并交叉验证,PR先经AI审查、多智能体投票过滤误报,再按风险分级决定人工审批人数,低风险变更可零人工合并。配合自动化安全检查、合并队列、功能开关与快速回滚,PR量翻倍而回滚率降超40%。人类专注方向决策、高危代码与最终责任,事故复盘持续转化为评测集以优化审查器。
GitHub联合微软推出开源基准ReviewBench,用219个公开PR评测AI代码审查工具。首期榜单中,GitHub Copilot以40.1%的F1得分居首,但测试由GitHub自行完成且各产品测试时间不一,结果存疑。Martian等竞品基准排名不同,凸显基准设计对结果影响很大。
AI正在改变开发者的工作方式,要求强化三项技能:指挥AI智能体、批判性审查其输出、在工作流中保持技术判断力。GitHub Copilot支持用自然语言描述界面,由智能体构建可实时使用和更新的画布,减少适应工具的时间;当聊天界面不适用时,画布是更具体的交互方式。
Ivo把合同审查模型Ivo Sage开源了! Ivo Sage 免费开源,合同审查模型市场震动,可真正值钱的是 Ivo-micro1 Contract Bench 测出的判断力,不是改得快;Ivo Collaborate 收费,Harvey Tenet 只发模型,法律AI开源竞争转向长周期合同工作。 ## I
Azure Repos 的 Copilot 代码审查更新:新增 Lite 和 Balanced 审查强度级别,支持按项目或仓库设置默认值;应用建议时可同时解决相关评论;审计日志新增启用/禁用、代理池、自定义指令、强度级别及分支策略等事件。功能正逐步推送,未来数月将继续改进。
2026年AI代码审查工具市场已成熟。主流工具各有侧重:CodeRabbit覆盖广,Sourcery专注Python,Qodo强于测试生成,SonarQube合规性强,Codacy擅企业统一管理。Gitee提供原生PR审查流程与马建仓AI助手,但集成第三方工具需注意API兼容性。AI适合首轮筛查,无法完全替代人工审查。选型应先明确技术栈与合规需求,再从免费层评估。
在Databricks平台构建受治理的多智能体系统用于安全审查:通过对话式录入收集信息,多个职责明确的智能体评估风险、匹配标准并生成要求,低风险请求自动完成,高风险交由人工判断。所有数据经Unity Catalog治理,仪表盘追踪效率。常规审查从数天缩短至数分钟,专家可专注高风险决策。
华钦科技在香港监管沙盒内完成中国某银行AI反洗钱辅助审查项目。通过微调开源小型大语言模型,风险评级准确率超90%,远超基线模型及通用大模型。团队采用合成数据、类别加权与推理链优化,解决数据不足和幻觉问题,形成可跨场景复制的金融AI训练方法论。
Thorsten Ball 提出 16 条判断:代码审查、单元测试和终端将消亡,写代码的手艺贬值,工程师价值转向理解业务与判断取舍;“好代码”共识可能崩塌,Token 成为新计算范式,PM、设计、工程三角瓦解,小团队优势扩大,UI 将实时生成。他强调变革需一代人时间。
AI生成代码导致资深工程师审查负担过重:代码量大、缺乏意图说明,且看似合理却暗藏错误。建议将重复反馈规则化、保留生成意图作为验收标准,并衡量真正防止劣质代码的工作,否则核心工程师可能因不堪重负而离职。
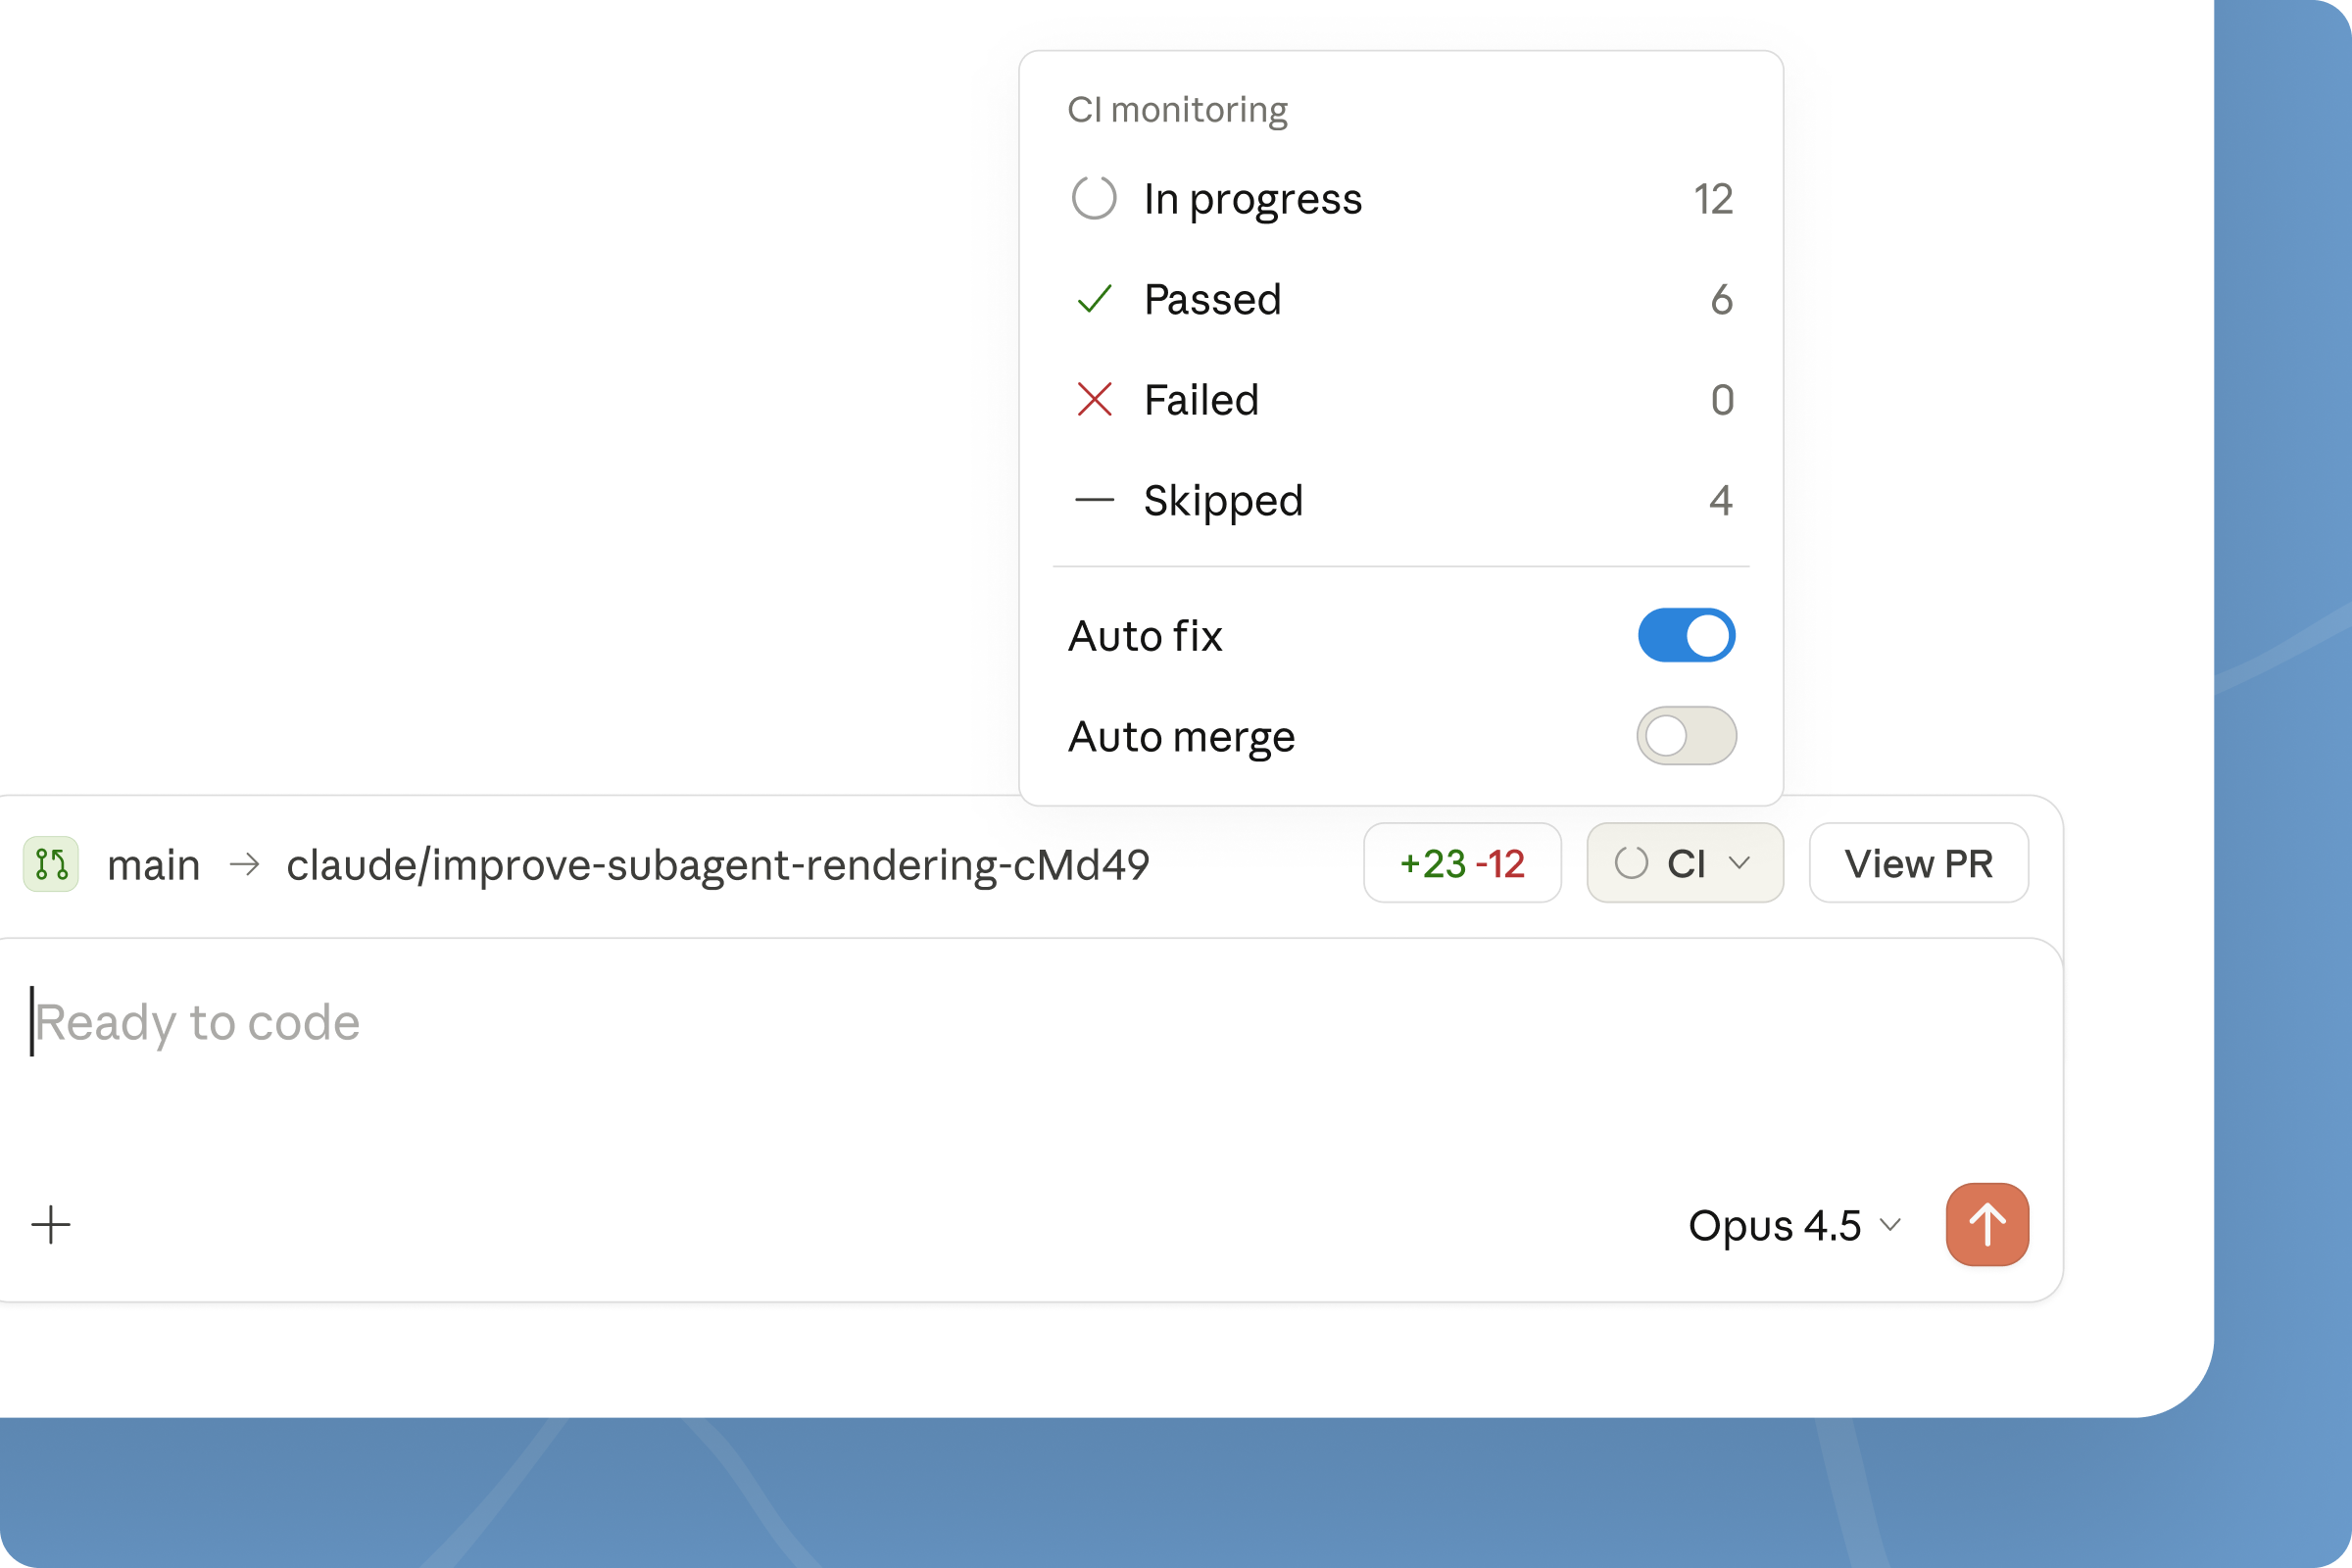
Claude Code 更新了多项功能,包括桌面应用预览、自动代码审查与修复、监控 GitHub PR 状态等。用户可在桌面界面直接查看应用反馈,并在不同设备间无缝切换。
文章探讨了AI生成代码激增带来的代码审查挑战。开发者大量使用AI导致合并请求增加98%,但缺陷和事故率上升。专家建议将质量检查从人工转向交付管道,采用“策略即代码”规则,仅标记违规内容,而非人工审查全部代码。文章还预告了一场关于此话题的直播辩论,讨论政策能否替代人类判断及其对初级工程师的影响。
博主因友链网站被注销备案而受影响,推测当局清退旧规备案存量网站并加强审查,导致其博客内容被牵连。为此,他通知备案友站移除链接,并新增规则不接受大陆备案网站,同时观察到中文网站屏蔽大陆访问的趋势。
代码审查已无法应对AI生成代码的速度,应转向自动化、结对编程和设计评审。AI处理格式、安全等机械问题,人类专注架构和业务逻辑。反馈需前置,知识传递发生在写码过程中。Meta数据显示代码量增220%但功能仅增36%,瓶颈已从写码转向审查,需警惕AI偏离意图的“认知债务”。
本文探讨企业为AI编程工具构建内容审查层(DLP)的方案,核心是内容审查需在明文可见处进行。路径分两种:可改端点的自研应用用LiteLLM网关,闭源工具如Kiro则用透明MITM拦截。架构采用分层DLP引擎,语义审查小模型须部署在自有VPC内,并用RAG相似度检索弥补新写代码漏检。内容型DLP本质是best-effort检知,非硬预防。
GitHub Copilot代码审查现已公开预览,适用于Azure Repos,所有Azure DevOps用户均可启用。新功能包括组织、项目、仓库级别的灵活配置,支持Managed DevOps Pools,自定义审查指令,自动代码审查,以及改进的计费与成本可见性。未来将推出日志查看和审查级别选项。功能将分区域逐步推出。
本课程介绍如何构建生产级多智能体PR审查系统,模拟资深工程师的判断。内容涵盖:将复杂工作流分解为触发器和评分、用LangGraph协调安全与质量等并行代理、通过Tiger Cloud统一数据库管理、用Redis处理GitHub webhooks、设置验证门控和回归检查,以及通过置信度队列和成本仪表板防止幻觉与超支。
完成下面两步后,将自动完成登录并继续当前操作。