本地AI生态已成熟,分为四层:模型服务(Ollama适合入门,llama.cpp/vLLM供高级控制)、编辑器接口(Cline为自主编码代理,Cursor等提供轻量补全)、终端层(Aider/OpenCode/Claude Code实现仓库级自动化)、上下文层(LanceDB/Chroma等向量数据库支持本地检索)。各层可独立选型,推荐Ollama+Cline+OpenCode+Chroma组合,兼顾隐私、零成本和效率。
小型语言模型(SLM)虽知识量有限,但适合本地运行,可处理三类任务:保密数据文档结构化、批量分类(如邮件路由)及低延迟即时响应。关键在于将知识外置(如用模式约束输出),避免依赖模型记忆,并注意上下文窗口和推理限制。
本文探讨了小型语言模型(SLM)在窄自动化任务中的优化,重点介绍了约束输出空间技术。通过直接评分候选标签而非生成自由文本,该方法消除了解析错误,降低了延迟(例如处理600条工单的时间从134秒降至94.5秒),并提供置信度分数以支持人工复核。该技术使SLM成为固定输出场景下高效的生产选择。
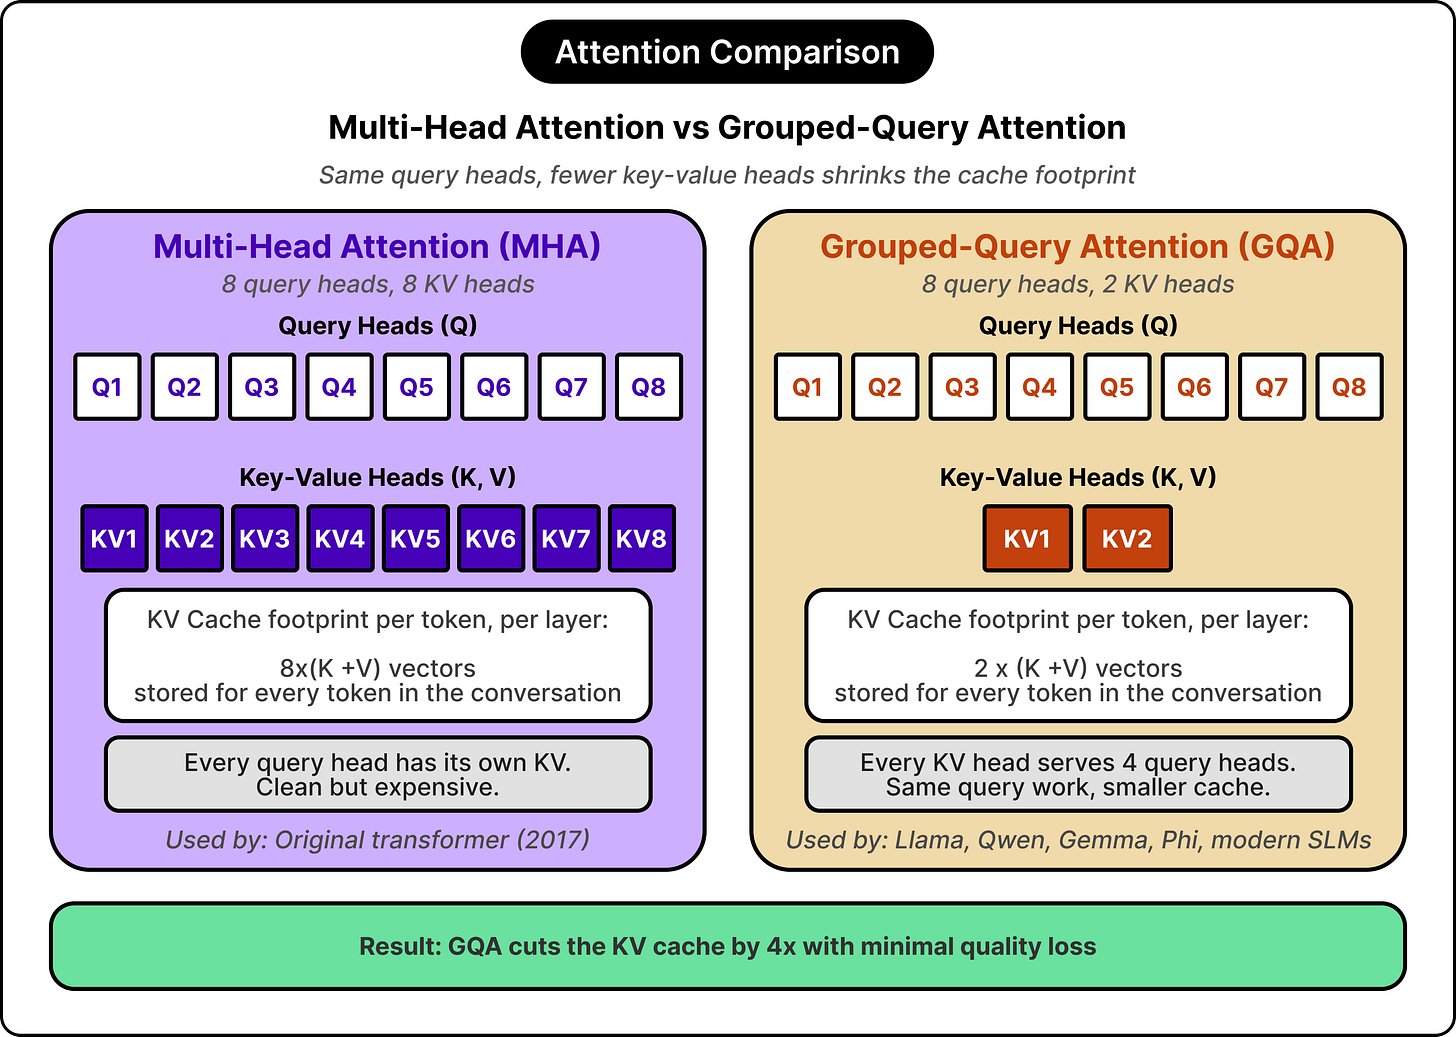
本文介绍SmolLM3,一个3B参数的小型语言模型,强调其在特定任务上能以更低成本媲美70B模型。文章通过构建多语言客服工单路由器的实例,展示了SmolLM3的加载、推理、工具调用和微调方法,并指出其架构优势(如分组查询注意力、双模式推理)使其在资源受限环境下高效实用。
2026年企业AI部署转向小型语言模型(SLM),因其成本低、延迟小且满足隐私要求。文章推荐五份关键资源:从零训练SLM的GitHub指南、arXiv压缩技术综述、NVIDIA关于SLM在代理AI中优势的论文、Pioneer AI微调实践指南,以及Hugging Face的模型概览,覆盖架构、策略到部署全流程。
小型语言模型(SLMs)在代理人工智能中逐渐取代大型模型,因其在处理重复性任务时更高效、经济。SLMs可直接在设备上运行,减少延迟,适用于特定工具调用,并能与大型模型协作,确保敏感数据不离开本地,适合医疗和金融等受限行业。因此,SLMs在代理设计中正成为重要选择。
小型和大型语言模型因设计约束不同而异。小型模型适用于设备,内存和延迟有限;大型模型在数据中心运行,资源更充裕。两者基于变换器架构,小型模型通过数据质量、知识蒸馏和过度训练提高效率。生产系统通常结合两者,利用小型模型处理常规请求,大型模型应对复杂任务。
本文介绍了如何利用小型语言模型(LLM)为教育应用程序生成创意项目建议。作者开发了一款基于活动学习的应用,使用维基百科数据构建数据集,并通过过滤和生成训练对来训练模型。文章详细阐述了模型的微调过程、评估方法及其在应用中的集成,确保生成内容适合儿童且安全。最终目标是根据教师提供的材料和年龄范围,生成结构化的教育活动建议。
本文讨论了小型语言模型(SLM)架构设计,以避免“模型衰退”。重点包括建立模型注册表以跟踪模型来源和性能,实施版本控制的网关模式,以及开发基于清单的交付系统,以确保模型在边缘设备上的高效部署。这些方法提高了模型的可维护性和可追溯性,确保在生产环境中有效管理多个SLM。
小型语言模型的性能显著提升,4亿参数的模型在推理基准测试中超越了30亿以上的模型。优秀的小型模型如阿里巴巴的Qwen3.5-4B和微软的Phi-4-mini在多种任务中表现出色,适合在普通硬件上运行。小型模型的优势在于资源需求低和响应速度快,适合多种应用场景。
本文介绍了五种小型语言模型:SmolLM3-3B、Qwen3-4B-Instruct-2507、Phi-3-mini-4k-instruct、Gemma-4-E2B-it 和 Mistral-7B-Instruct-v0.3。这些模型支持工具调用,适用于多种应用场景,具有不同的参数、架构和上下文长度,能够在不依赖大型基础设施的情况下提供高效推理和多语言支持,适合边缘设备和低延迟需求。
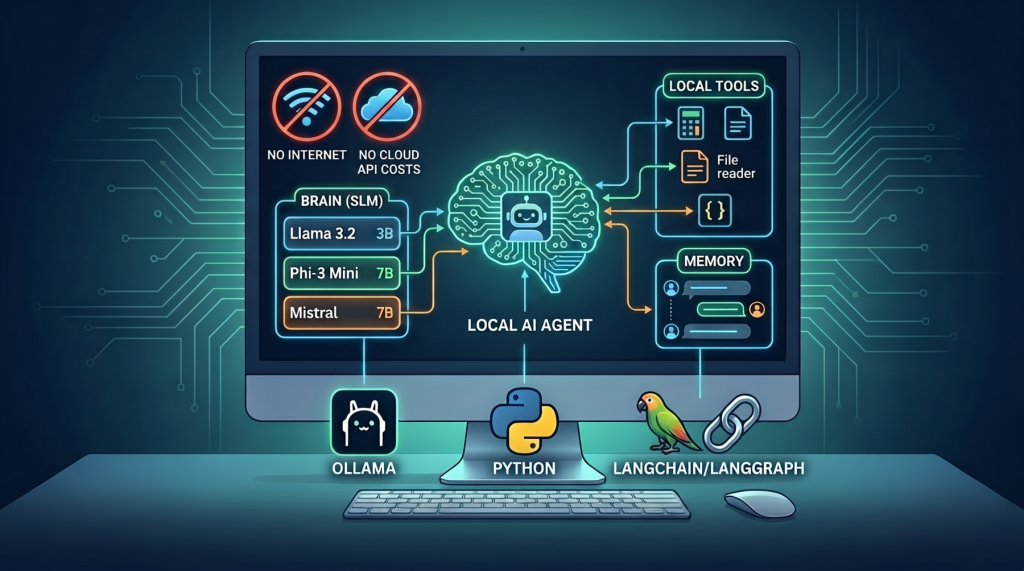
本文介绍如何使用本地小型语言模型构建AI代理,无需互联网连接和API费用。内容包括AI代理的定义、Ollama和Python库的设置步骤,以及逐步构建本地AI代理的方法。小型语言模型(如Phi-3和Llama 3.2)适合在普通电脑上运行,提供隐私保护和零成本。通过示例代码,读者可以创建具备记忆和工具的智能代理。
本文探讨了小型语言模型(SLMs)在预训练过程中应学习的标记及何时通过<CALL>标记请求外部帮助。研究表明,损失值可以预测标记的准确性,但某些高损失标记仍可接受。提出的LaCy方法通过选择性学习和委托,显著提高了生成的准确性和效率。
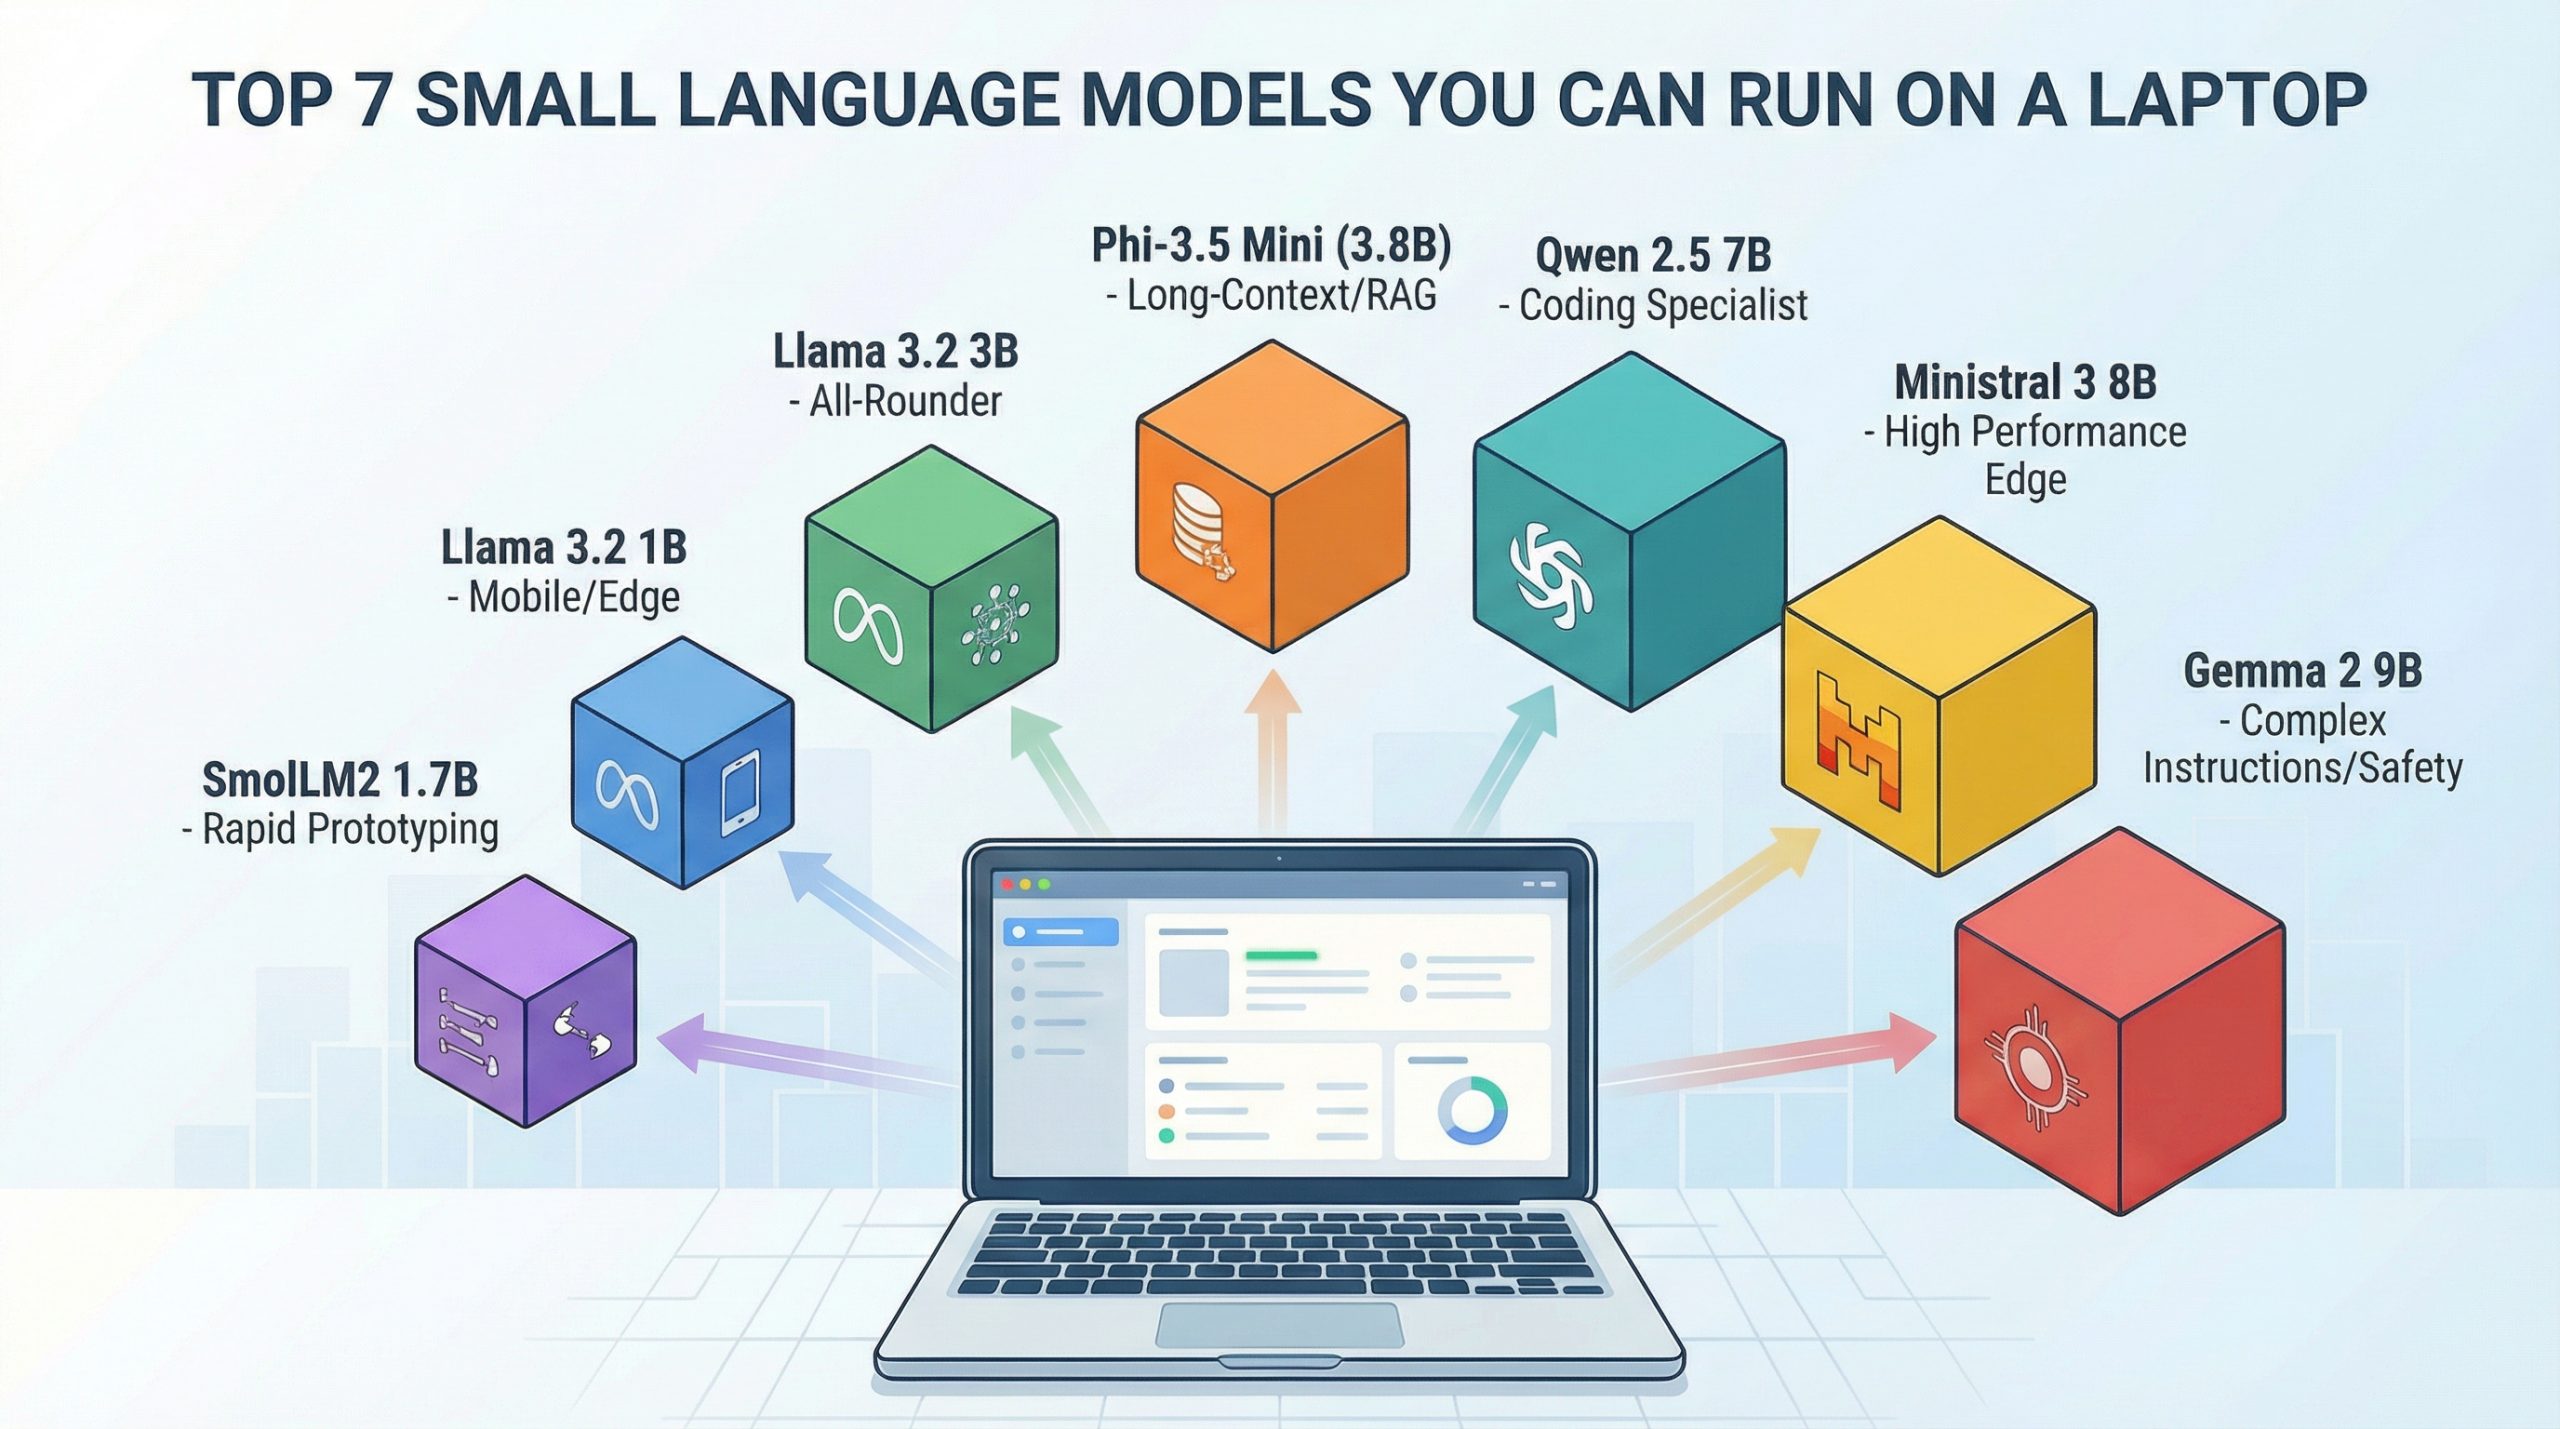
本文介绍了七种可在笔记本电脑上运行的小型语言模型,包括Phi-3.5 Mini、Llama 3.2、Ministral 3、Qwen 2.5、Gemma 2和SmolLM2。这些模型适用于文档处理、代码生成和快速原型开发,用户可根据需求选择合适的模型。
小型语言模型在企业应用中迅速发展,但GPU计算和内存带宽常常闲置。NVIDIA的多进程服务(MPS)允许多个推理进程共享GPU,显著提高小模型的吞吐量,尤其在短上下文中。然而,对于大模型和长上下文,MPS的优势减小。在CPU瓶颈情况下,MPS仍能有效利用GPU时间,但增加了操作复杂性。
企业AI继承了消费级AI的模型,但不适用于大多数B2B问题。企业工作流程在封闭系统中运作,小型语言模型(SLM)更能满足特定任务的需求,提供更高的准确性和效率。SLM专注于特定领域,避免了大型模型的高成本和复杂性。
企业结合小型语言模型(SLM)与检索增强生成(RAG)架构,能有效降低基础设施成本,提高响应准确性和可审计性。SLM专注于特定领域,适合企业平台的可持续运行,而RAG通过引用权威数据源增强输出可信度。模块化代理架构使每个代理独立负责特定功能,便于扩展、治理,确保合规性和操作控制。
本文介绍了一种基于层次记忆的预训练方法,旨在提升小型语言模型的性能。该方法通过访问大型记忆库,有效存储和提取长尾知识,同时保持常识理解。实验结果表明,使用这种记忆增强架构的小模型在性能上可与参数更多的常规模型相媲美,并在资源受限的设备上表现优异。
到2026年,数据生态系统将更加分散,AI代理将通过合作增强专业化,促进人机协作。用户将寻求可插拔的解决方案,而非依赖单一供应商。云服务将向区域化和专门化发展,以支持多种AI任务。同时,小型语言模型的使用将增加,以应对成本问题,实现灵活性和适应性。
麻省理工学院的研究人员开发了“DisCIPL”框架,通过结合大型语言模型与小型模型,提高了文本生成和推理任务的效率与准确性,降低了计算成本,为未来的数学推理和模糊偏好处理奠定了基础。
完成下面两步后,将自动完成登录并继续当前操作。