文章讨论小参数语言模型在搜推场景的推理优化,核心是在延迟约束下追求有效吞吐,而非单纯追求吞吐数字。压测应将超时请求计为失败,明确端到端延迟预算并区分排队与计算耗时;合批需权衡等待成本,压测应贴近真实请求分布并关注尾部延迟。工程上应设置调用超时、及时停止过期任务、限制重试并演练降级,通过小流量对照验证质量与资源消耗。
本文对比标准向量RAG与三层Graph-RAG在事实密集型查询中的幻觉表现。作者用合成篮球数据构建基准:图数据库存真实数据,向量库存含矛盾数字的噪声文本。使用Flan-T5-base模型测试50个查询,标准RAG准确率为96%,Graph-RAG为92%。结论是复杂冲突消解提示需更强模型,小模型反而表现更差。
Cua团队提出“系统一”小模型路线,推出70万参数、2.8MB的CUA-S1-FORMS,专攻表单填写,准确率99.7%,本地CPU延迟仅7毫秒,远超托管大模型。其核心是菜单式决策:应用先提取控件生成合法选项,模型只做选择,不生成坐标或代码,避免幻觉与误操作。大小模型分工,大模型负责规划与异常处理,小模型负责高频精准操作,可显著降低成本与延迟。
《细胞》刊发LongevityBench基准,用17项衰老任务测试26个AI模型。经组学数据微调的90亿参数小模型L-Qwen3.5-9B在DNA甲基化、蛋白质组等任务上击败GPT-5、Gemini-3.1-Pro等前沿大模型。原因是通用大模型训练语料缺乏原始测量数据,只会背知识,不会读数据。小模型训练成本低,但研究仍属概念验证,未闭环。
2026年5至8月,Blockchain Labs、微软、奔驰相继公开端侧小模型专利,涉及本地数据签名、边云分层路由和车载模型剪枝,均处于审查阶段。端侧AI竞争正转向架构层面,但量化选型基准与交付工具仍缺失。独立开发者可开发本地评测CLI或基准站,提供量化级、速度与准确率报告,并输出边云降级路由模板,服务私有化部署外包,2至4周可完成MVP。
语音AI的“人味”取决于响应时机而非模型大小,小模型实时处理反而更像真人。“电话兜住率”具误导性,应关注解决率。听起来像人却会编造答案的AI,比机械但基于真实数据的AI更糟。语音智能在于不存储什么,专注小模型可胜过大模型。理想部署应识别能力边界并适时转人工。语音不会取代其他界面,而是增强。简单拼接API算不上语音智能体,规模化需芯片级优化。
OpenAI Astra采用“循环深度”技术,通过重复使用参数提升计算深度,使3B小模型达到50B效果,但引发AI安全争议。该技术减少可见思维链,增加监控难度。开源Nanbeige模型应用此技术未受关注,而闭源Astra因规模大、透明度低遭担忧。核心问题在于模型越强越难监控,竞赛或致人类无法理解AI推理。
新加坡国立大学提出COTA框架,利用0.5B小模型比较候选动作而非直接解题,在运行时干预大模型智能体,在9个组合上均获最佳性能,平均开销1.38倍。关键在成对比较与建设性干预,直接接管会导致崩溃。成本有边界,部分环境开销较高。
推测解码通过草稿模型生成候选token,目标模型并行验证,以接受-拒绝机制保证输出分布与直接采样等价,从而加速自回归推理。其加速效果取决于接受率、草稿模型成本及批大小,批增大或模型变大时收益下降。Medusa、EAGLE、MTP是三种草稿来源方案,各有优劣。
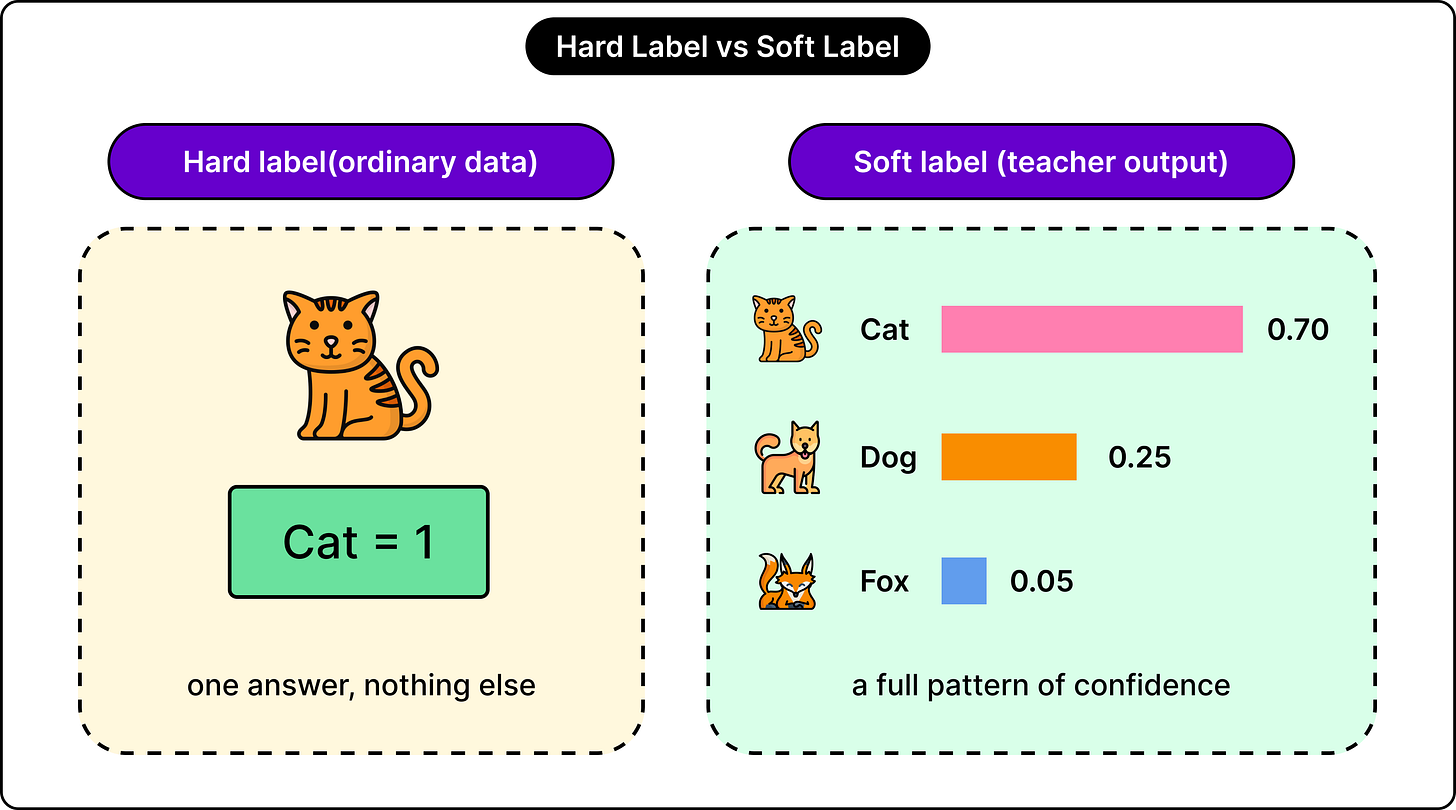
知识蒸馏是一种训练小型模型模仿大型模型行为的方法,与模型压缩不同,它生成独立模型。通过软标签传递更多信息,学生模型能超越原始数据学习。主要方法包括输出蒸馏、特征蒸馏和合成数据蒸馏,其中合成数据蒸馏最常用。蒸馏在窄任务上表现优异,但受限于教师模型能力、容量差距和架构影响,且可能传递非预期特征。自动化蒸馏正减少人工干预。
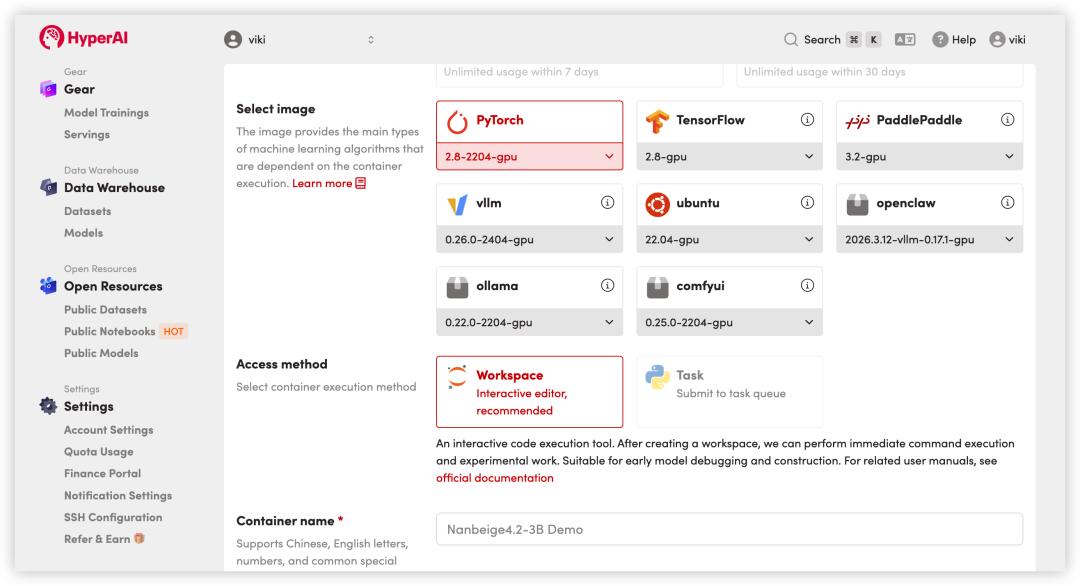
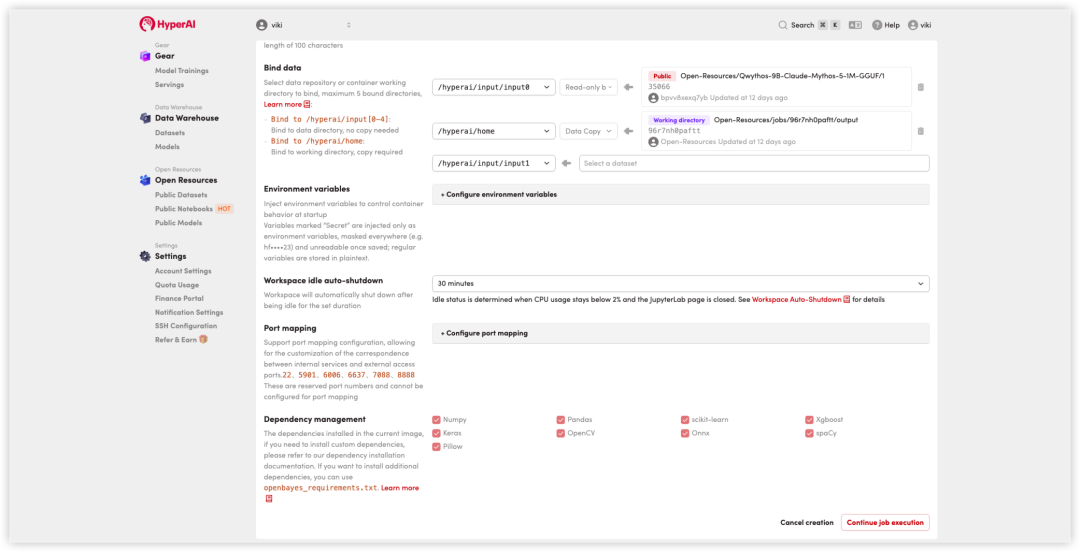
南北阁实验室发布Nanbeige4.2-3B模型,采用Looped Transformer架构,仅30亿参数,在Agent基准测试中表现优异,如SWE-Bench得分63.6,GPQA-Diamond得分87.4。支持Thinking Mode和262K上下文,已在HyperAI平台上线,便于开发者低成本探索本地智能体应用。
Empero 开源了 Qwythos-9B-Claude-Mythos-5-1M,这是一款增强推理能力的小模型,拥有 90 亿参数。该模型通过高质量数据提升复杂推理任务的表现,支持长上下文和工具调用,拓展了多模态应用。HyperAI 提供了快速部署和测试的资源,方便开发者使用。
2026年,AI领域的蒸馏技术成为热点,主要有离线硬学、在线讨教和自我顿悟三种流派。蒸馏技术通过让小模型模仿大模型的输出,实现性能与效率的平衡。新玩法包括多个专家共同指导一个学生模型,以及模型自我教导,提升学习效果。这些技术在开源社区逐渐普及,成为AI训练的重要手段。
Ornith-1.0是一个开源AI模型,首次实现自我优化训练策略,通过强化学习提升学习效率。尽管参数较小,Ornith-1.0在测试中表现优异,超越许多大型模型。其训练方法可迁移至其他领域,未来可能出现多样化的思考方式模型,改变开发者的工作方式。
谷歌的Gemma模型通过使用Gmail等私有数据进行训练,展现出更自然的对话能力。相比于大型模型,Gemma因参数较少,保留了人类的语言本能,更贴近真实对话。其训练数据来自真实的邮件和文档,使表达更具亲和力。Gemma适合用于写作和聊天,而大型模型更擅长技术任务。选择AI时,应根据需求选择合适的模型。
Gemma 4 12B是一个开源的多模态AI模型,能够在普通笔记本上离线运行。它可以生成C++游戏、3D打印机模拟器和现代网页,表现超出预期。其架构设计简化了信息处理,降低了内存需求,使普通开发者也能轻松使用。这一模型的推出标志着AI技术的普及,降低了使用门槛,吸引更多人参与AI开发。
小米AI团队在ICML 2026上展示了11篇研究成果,涵盖GUI Agent、推理增强和多模态理解等领域。他们从5亿条视频中提炼数据,构建了全球最大开源GUI操作数据集,显著提升了模型的准确率,并探讨了模型训练的稳定性和推理能力,推动AI技术的实际应用,展现了小米在AI研发的长期投入与成果。
OpenAI推出了名为privacy-filter的小模型,通过先处理隐私数据再交给大模型,确保数据安全。该系统可在本地运行,成本低且高效,适用于医疗、金融等敏感行业,提升了AI应用的安全性和可审计性。
第三方评测机构Artificial Analysis发布报告称,Qwen3.5 27B和Gemma 4 31B在智能水平上接近GPT-5。Qwen3.5在推理能力上表现优异,但知识准确性仍有不足。两款模型支持多模态输入,适合本地部署,降低使用门槛。Gemma 4系列在多种应用场景中表现出色,具备强大的推理和语言处理能力。
AI安全能力已具实用性,小模型能够完成关键任务,能力呈现锯齿状波动。真正的竞争在于系统设计和流程编排,而非单一模型性能。行业应尽快落地实践,避免继续观望。
完成下面两步后,将自动完成登录并继续当前操作。