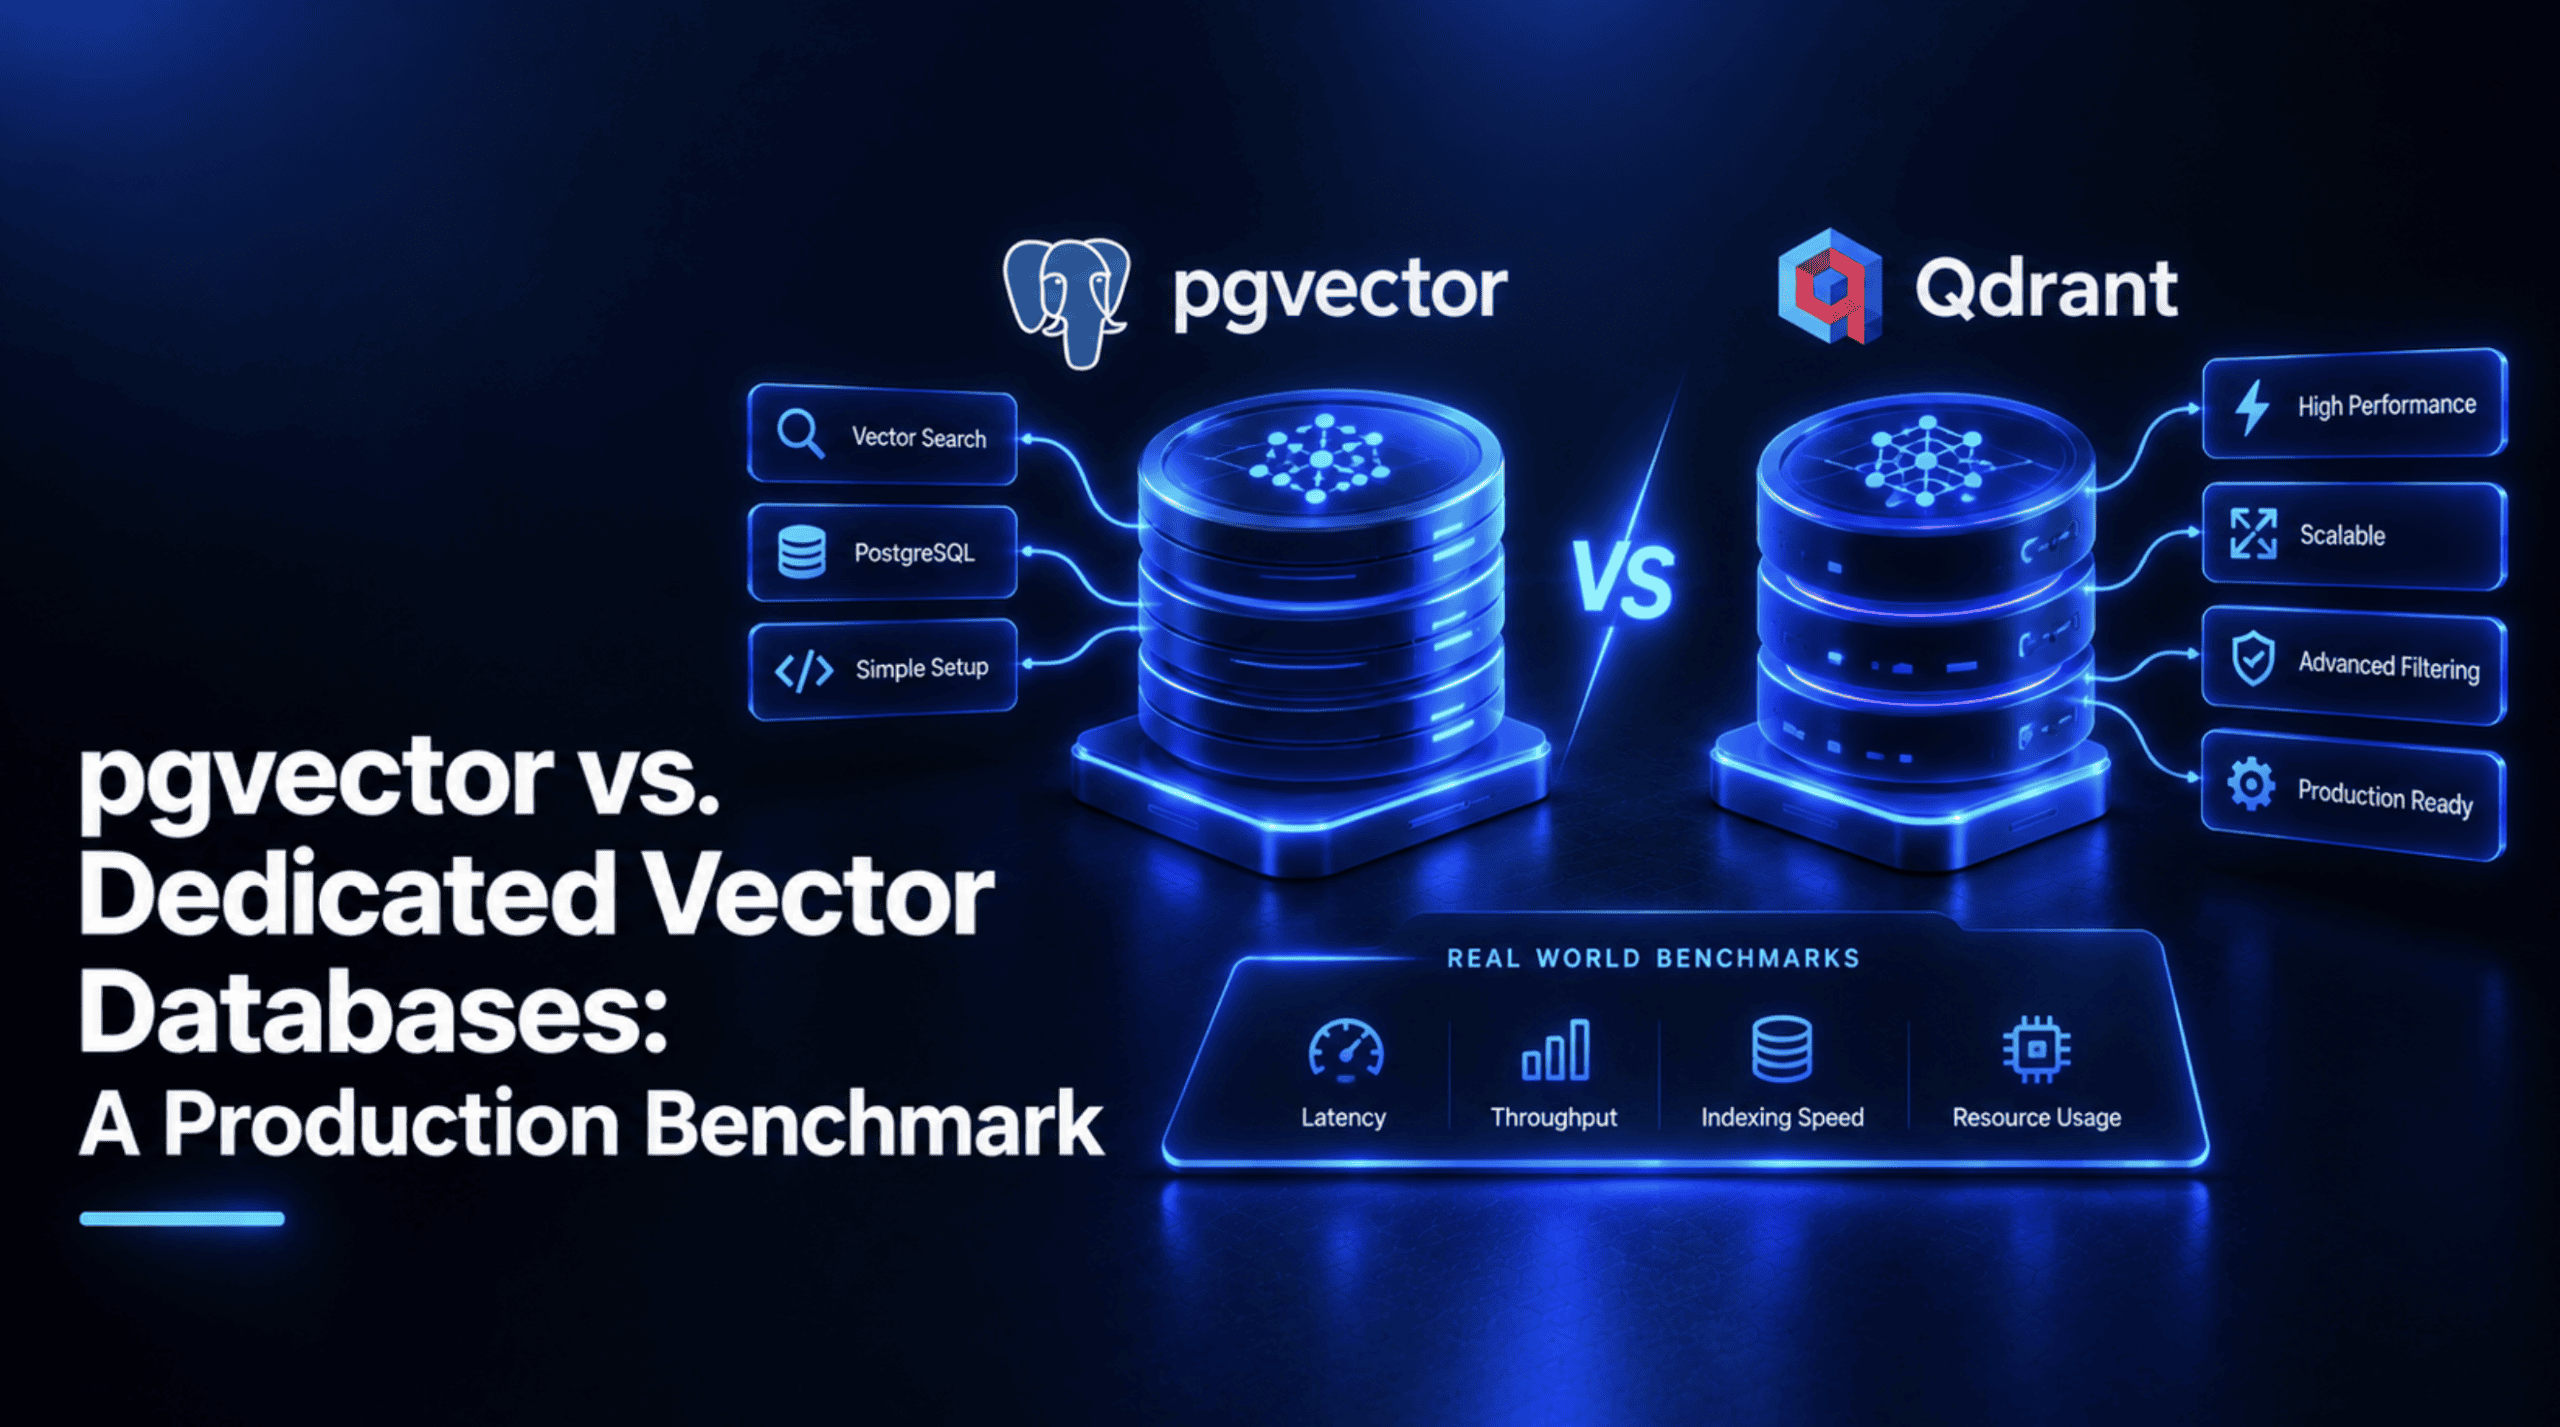
文章比较了pgvector与专用向量数据库。pgvector是Postgres扩展,可在同一数据库内同时存储向量与关系数据,支持多种向量类型和距离函数。作者用Docker在本地对pgvector和Qdrant做基准测试,但10万向量的规模太小,难以得出结论。文章引用Tiger Data的5000万向量生产级测试:在99%召回率下,pgvector配合pgvectorscale吞吐达471 QPS,远超Qdrant的41 QPS;但Qdrant尾延迟更优,p99为38.71ms对74.60ms,索引构建也快约3.4倍。结论:千万级以下、需要事务一致性的场景选pgvector;超大规模、严格尾延迟SLA或零运维需求的场景选专用数据库。
Oracle Java团队文章指出,评估垃圾收集器尾延迟常用SPECjbb2015或DaCapo,其中仅SPECjbb2015支持负载生成器与后端服务器同JVM或分JVM运行。文章探讨了同JVM运行负载生成器的风险与局限。
论文指出,智能体并发高时变慢常源于推理服务前的调度:贪心释放导致在途请求堆积。作者主张解耦“就绪”与“释放”,控制未完成工作量,并按尾延迟调度。实验显示竞争下P95完成时间最高改善3.50倍,但非普遍加速。建议记录端到端P95/P99,限制在途队列,兼顾公平与等待保护。
实时AI扩展面临延迟、准确率下降等问题,根源多在数据管道而非模型。尾延迟源于架构,如锁竞争;特征陈旧导致准确率下降;向量索引退化影响召回率。需分离读写路径、训练与服务,监控指标,并采用支持高并发写入和弹性扩展的数据库,避免“厄运循环”。
本文讨论了尾延迟对用户体验的影响,指出即使平均响应时间良好,少数慢请求也会导致用户感到应用迟缓。尾延迟常因请求排队、垃圾回收、磁盘I/O等因素引起,尤其在高并发场景下更为明显。采用内存架构(如Redis)可显著降低尾延迟,提升系统性能,确保用户体验一致。
本文探讨了750B MoE模型从自建RoCE集群迁移至AWS EFA的过程,验证了Prefill-Decode分离推理的通信架构。客户希望利用AWS的弹性算力扩展本地GPU资源,降低硬件风险。通过理论分析和实际测试,比较了AWS EFA与自建RoCE集群的性能,发现EFA在复杂通信负载下表现良好,尽管在某些延迟指标上略逊一筹,但在尾延迟稳定性上有显著优势。整体来看,EFA已可替代RoCE,尤其在对尾延迟敏感的场景中表现出色。
某电商平台在大促期间出现尾延迟问题,导致用户投诉。研究表明,尾延迟对用户体验的影响大于平均延迟。文章探讨了尾延迟的数学原理及优化策略,如对冲请求和绑定请求,以减少整体请求延迟。强调在大规模分布式系统中,管理尾延迟是提升用户满意度的关键。
本文介绍了通过“请求对冲”策略降低Go HTTP客户端的P99尾延迟74%。该策略通过并行发送请求,利用最快响应来提高效率,尤其在微服务中表现出色。文章还提供了实现对冲机制的代码示例,并强调了在生产环境中需考虑的幂等性和延迟设置等因素。
Linux 网络邮件列表发布了 Homa 传输协议 v16 补丁,旨在替代 TCP,显著降低短消息的尾延迟。Homa 是一种无连接、面向消息的协议,适用于高负载环境,优化性能并减少连接状态。该项目由斯坦福大学与麻省理工学院共同研发。
完成下面两步后,将自动完成登录并继续当前操作。