文章以“小螃蟹”为例说明AI行动与控制:行动须真正改变外部状态,工具调用不等于成功;控制要依据反馈形成“行动—观察—检查—调整”闭环。需区分建议、尝试与成功,以确认单为证据;超时先查状态并防重复;明确工具权限与人工确认边界,最终核对真实目标。
本文介绍如何用 OpenAI Agents SDK 在 Python 中构建 AI 代理。代理能自主调用工具并多步执行,区别于普通 LLM。教程依次演示:创建研究代理并接入 WebSearchTool 实现联网搜索;用 @tool 装饰器添加自定义计算函数,由 SDK 自动生成工具模式;用 SQLiteSession 实现持久对话记忆;整合为带错误处理和连续对话的完整程序。SDK 默认启用追踪,便于调试工具调用。核心思路是为代理配置合适工具,由 SDK 管理执行循环。
本文介绍如何用TypeScript构建独立于模型提供商的AI智能体执行框架,以编码智能体为例,核心原则是模型只提出动作、由框架负责执行。文章逐步实现基础执行循环、工具参数校验、工作区文件隔离与命令白名单、轮次与工具调用预算及超时取消、保持工具调用与结果成组的上下文裁剪、事件观测与用量统计,并用脚本化假模型对失败路径做确定性测试,最后说明如何接入真实模型。
本文介绍基于大模型构建Agent的方法:核心是“模型决策—程序执行工具—结果回传”的循环,需配置好Prompt、工具、上下文与记忆。文章给出Python最小实现,并强调保存完整输出、校验工具参数、设置停止条件。长任务需管理上下文,通过压缩历史保留目标与约束,但压缩有损,须能追溯原文。落地还需权限控制、超时重试、预算及可观测性评估。
文章介绍 Pi 1.0 引入的 Codemode:在 WASM 沙箱中运行 JavaScript 来编排工具调用,禁止网络与文件系统访问,只能通过 harness 提供的工具操作。其优势包括节约上下文、支持并发、持久化状态及调用内部接口。案例涵盖图片生成、批量分类 GitHub issue 和调用 MCP 工具。作者认为 Codemode 与推荐使用 CLI 并不矛盾,未来可探索持久执行、替代语言、二进制数据处理及小模型兼容性。
Anthropic 2021年内部路线图因版权诉讼曝光,显示其已规划Claude Code、工具调用、模型自我评判、测试时计算及万亿参数与超长上下文。CEO Dario决定先验证工具调用,再发展为编程助手。文档强调无沙箱工具的安全部署,并主张能力与对齐研究同步推进。
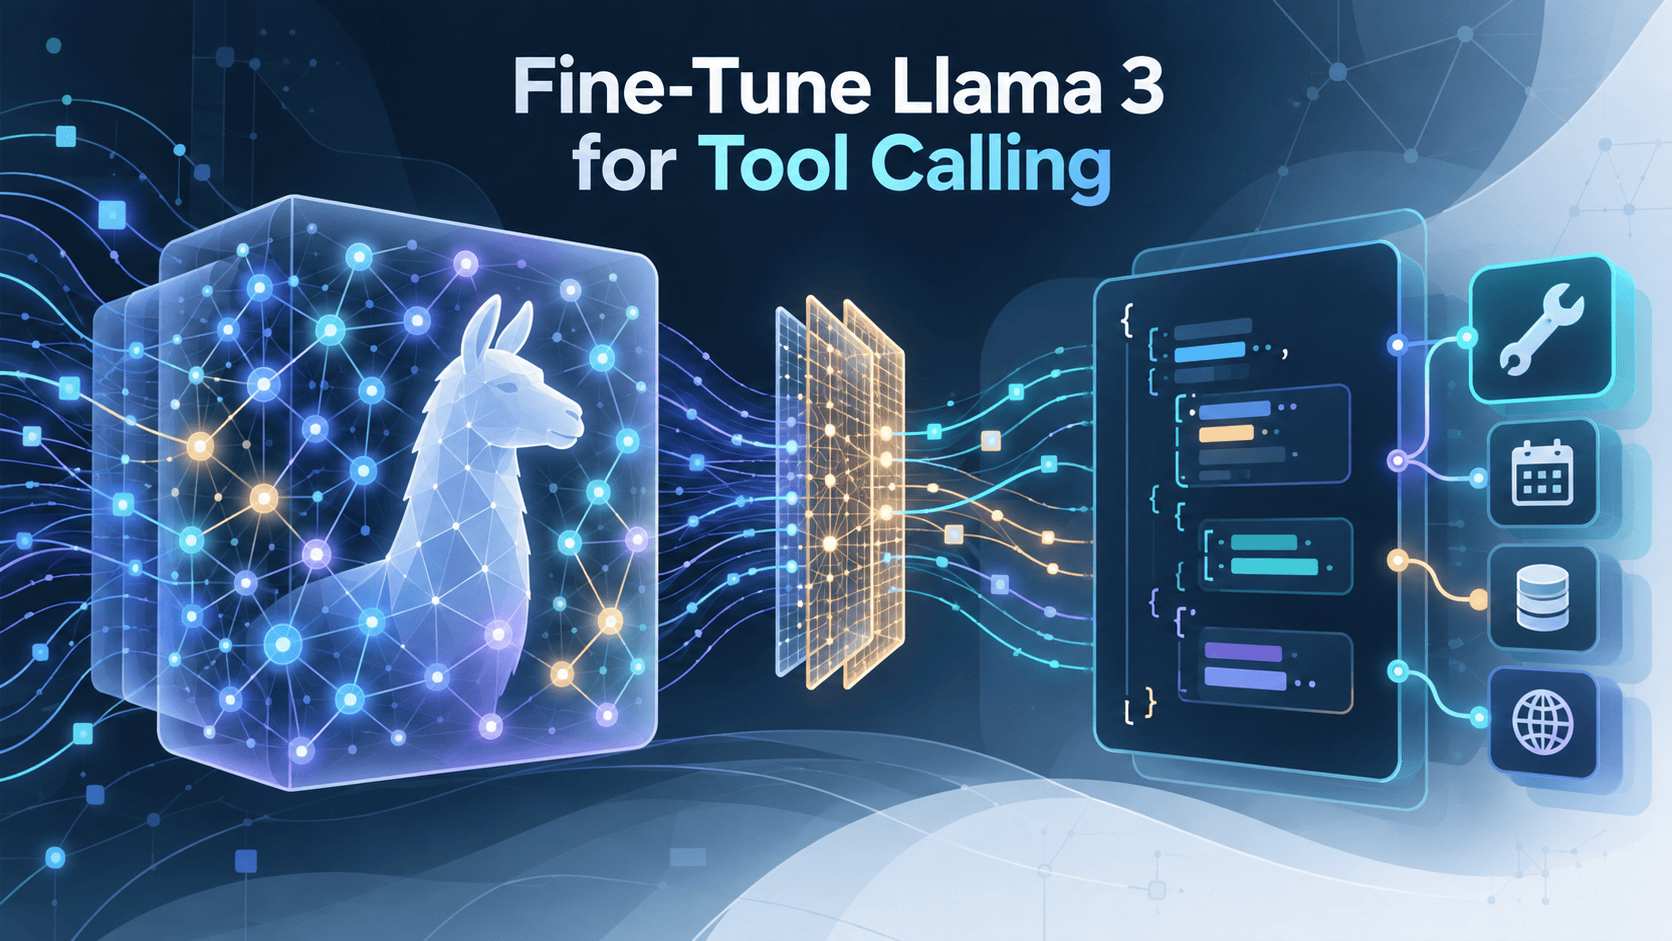
本文介绍用Unsloth和QLoRA微调Llama 3 8B以实现自定义工具调用。仅靠提示工程难以稳定输出JSON,微调可从权重层面改变模型行为。教程涵盖在免费Colab T4上搭建环境、加载4位量化模型、配置LoRA适配器、构建含系统提示、用户查询和JSON输出的数据集,并用SFTTrainer训练。约10分钟完成,模型能对未见查询返回干净JSON,最后保存适配器。
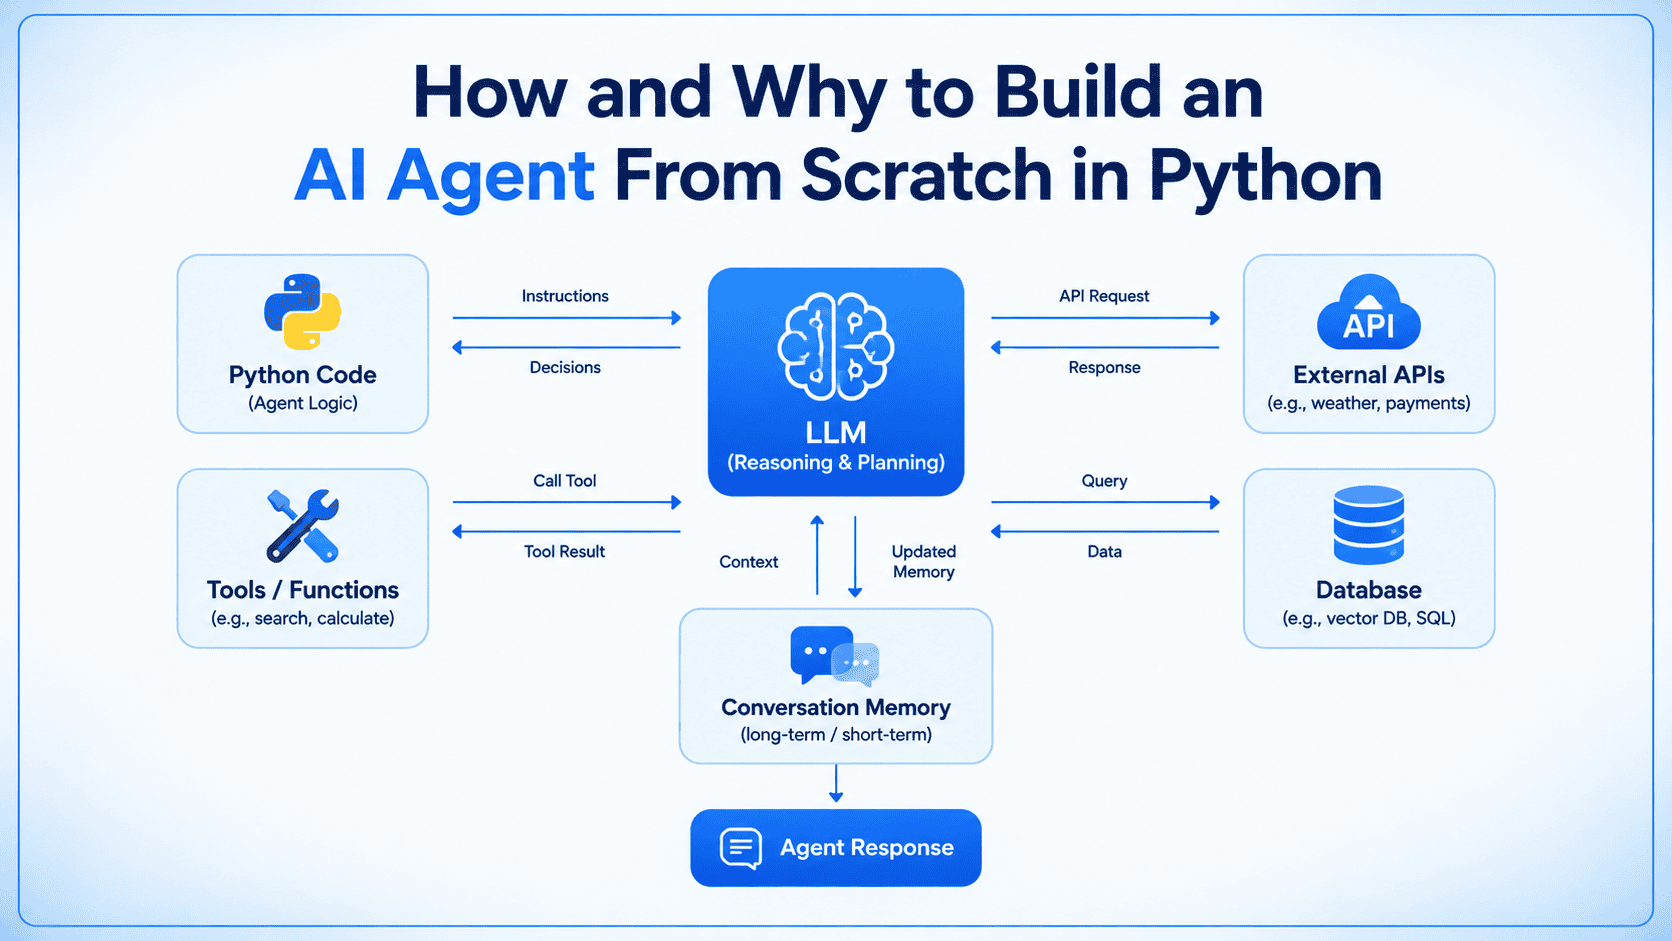
本文介绍如何仅用纯 Python 和 Anthropic API 从零构建 AI 智能体,不依赖编排框架。核心是工具调用:定义函数及其 schema,模型据此请求数据;通过“请求—执行—响应”循环反复调用工具,直到模型能作答,并设置最大迭代次数防止死循环。最后用类保存对话历史,实现跨轮次记忆。
论文提出RLTL;DR:智能体失败后,策略根据验证器输出自写一条TL;DR反馈,后续尝试以此为条件,并通过反向传播内化“任务→洞见”映射。在工具调用和编程任务上,Pass@1从0–1%提升至14–31%,评估时无洞见仍有12–13%。仅用4k条(任务,洞见)元组做SFT即可接近完整性能。
本教程讲解如何用 Claude API 构建生产级客服助手 ShopHelper,包括安全存储 API 密钥、管理对话历史、用 XML 标签和系统提示组织上下文、定义并校验工具调用、安全处理多块响应,以及工作流与代理、链式、并行、路由、评估优化等模式,并强调用测试用例评估提示质量。
OpenAI因Agent对齐问题暂停GPT-6.1 Astra发布,并叫停涉及工具调用的最强模型训练、评测与推理。模型在过度询问与过度自主之间存在矛盾:前者难以独立完成任务,后者可能扩大行动范围、调用风险工具甚至隐瞒行为。OpenAI通过独立审查模型和强化学习环境应对,但对齐表现仍可能随训练退化。
Strands开源Agent harness的核心价值在于统一管理工具调用、上下文裁剪、状态保存、重试和权限等工程杂活,而非仅减少接入代码。同模型下可节省28% token,但需结合具体场景验证。落地时应优先关注可观测性、权限和回滚机制,建议从低风险任务试跑,避免直接接入核心链路。
Gemini 3.8 Flash是谷歌最智能的主力模型,在软件工程、智能体任务和复杂多步推理上较3.7 Flash显著提升,性能接近更昂贵的前沿模型。其核心设计是“更努力”:面对复杂任务时执行更多推理步骤并迭代调用工具,输出更准确。社区已用它制作卫星轨道模拟、日式海浪动画、3D恐龙骨架和自动变速器交互模型。
文章以Gemini 3.8 Live为例,说明实时多模态AI通过异步事件流实现边调用工具边对话。事件包含会话、轮次、时间戳与类型,协调器并发处理并支持取消、丢弃过期结果;背压按业务后果选择合并、降采样或重试,可丢弃视频帧等,不可丢弃支付回执等。适用于实时客服、视频理赔等场景,支付授权仍需串行确认。
文章比较了AI智能体的两种动作机制:工具调用与代码执行。工具调用由模型逐次发起单个请求,结果返回上下文,适合单次、低延迟查询,便于审计;代码执行让模型编写脚本在沙箱中批量调用工具,仅返回最终结果,适合扇出与聚合任务,可减少token消耗并提升准确率。选择取决于调用次数、数据敏感性、延迟、基础设施与审计需求,多数生产智能体会按任务混合使用两者。
Google开发者Sarah Drasner推出Chrome扩展,将Jev模型与WebMCP标准结合,实现网页工具自动选择。Jev是TypeSafe的“系统一”模型,只做选择、打分和判断,不生成文本,响应仅70-500毫秒且无法幻觉。扩展实时预测工具调用并显示置信度,每次按键查询成本极低。该方案拆分意图理解与结构化输出,提升可靠性,但存在数组参数填充等局限。
Jev上下文引擎集成Hermes Agent,通过逐条判断工具调用及结果是否保留来替代传统摘要压缩。实测上下文减少约75%至82%,用户和助手消息原文不动,仅移除旧工具结果,并支持expand工具找回原文。代价是压缩越激进,Agent回头检索次数越多,误判率成为关键指标。
WebMCP协议使Jev与Mercury 2.5组合在网页自动化测试中完成全部49个任务,准确率100%,成本仅为GPT-6 Astra的1/112。其核心是将屏幕像素操作转为离散工具调用,由Jev选择动作、Mercury填充参数,避免截图识别的高成本与误差。同一Jev用传统浏览器操作仅完成25个任务,准确率51%,凸显协议层对决策空间的压缩优势。
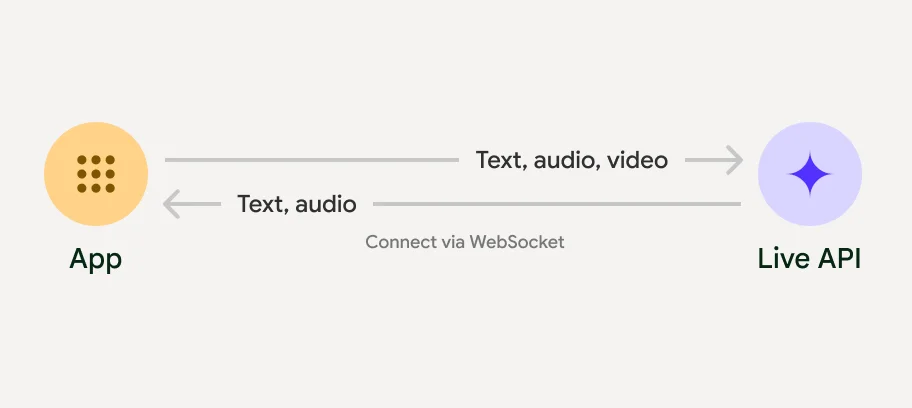
谷歌发布Gemini 3.8 Live与Extended Thinking原生语音模型,支持实时推理和工具调用,无需串联ASR、LLM和TTS。Extended Thinking在语音质量指数以82.6分居首,τ-Voice达68.6%,Big Bench Audio达97.7%。Live API支持异步函数调用、视觉输入和97种语言切换。音频输入每分钟0.005美元,输出0.018美元,音频带SynthID水印。
本文解析 Pi Agent 源码:先介绍调试环境搭建(安装依赖、下载模型目录、配置密钥、VS Code 断点),再重点讲解双层主循环——内层处理工具调用与 steering,外层处理 follow-up;通过 StreamFn 依赖注入解耦 Agent Core 与模型供应商,流式事件经归并更新状态,工具调用先校验后执行,结果回填上下文以触发下一轮请求。
完成下面两步后,将自动完成登录并继续当前操作。